ASTRA 是一套训练 tool agent 的数据与环境生产线。它先从 MCP tool documentation 合成多轮 SFT trajectories,让 base model 学会基本的选工具、填参数和接续 tool output;再把有依赖关系的 QA 拆解编译成 Python mock tools,让模型在可执行环境里做 online RL。论文把 cold start、长轨迹 rollout、可执行反馈和调用效率 放进了同一套训练方案。
Q1. ASTRA 想解决的训练瓶颈是什么?
强 tool agent 既需要广覆盖的示范轨迹,也需要能反复 rollout、稳定给 reward 的多步环境;现有路线通常只解决其中一半。
只做 SFT,数据可以离线生成,训练也稳定,但模型看到的是固定答案,无法从自己当前 policy 的错误中学习。只做 RL,又会遇到 cold start:base model 连基本的 tool selection 和 argument filling 都不稳定,很难探索到足够多的成功轨迹。更麻烦的是,很多工作让另一个 LLM 临时扮演 tool 或 environment;这样扩展很快,却可能让同一个 action 在不同 rollout 中得到不同 state transition,reward 也不再是确定规则。
ASTRA 因而把问题拆成两段:
- 用 tool graph 合成大量、跨领域的多轮 trajectory,先做 SFT;
- 用 QA dependency graph 生成样本级 Python environment,再做 multi-turn online RL。
这套设计的实际含义很直接:SFT 负责让模型“先会用工具”,RL 再训练“在一个任务中连续做对,并且少走弯路”。论文把前者称为在 static tool topology 上拓宽能力,把后者称为在 semantic topology 上加深能力。这个说法略抽象,落到数据上就是:一边组织哪些 tools 可能连续出现,另一边组织一个答案依赖哪些中间事实。
Q2. 它与已有 tool-agent 训练和 environment synthesis 工作差在哪里?
ASTRA 把大规模 SFT cold start 与 QA-derived executable environments 接成了一套公开 pipeline;tool graph、trajectory synthesis 和 GRPO 则分别有已有工作。
| 路线 | 代表工作 | 主要解决什么 | ASTRA 的位置 |
|---|---|---|---|
| 大规模 tool-use SFT | ToolLLM、ToolACE、Toucan | 从 API / tool inventory 生成 query、call 与 response | 同样从 tool documents 起步;额外聚合同一 server 内的 transition graph,并生成完整多轮 trajectory。 |
| 多轮 trajectory synthesis | MAGNET、ToolACE-MT、APIGen-MT | 用 graph、blueprint 或 simulator 构造连续调用 | 最接近 ASTRA 的 SFT branch;区别是 ASTRA 还把合成 trajectory 用作第二阶段 RL 的 cold start。 |
| 数据闭环与 text-to-trajectory | LoopTool、GEM | 围绕模型弱点迭代数据,或从文本恢复隐含流程 | ASTRA 除了生成离线轨迹,还把 QA decomposition 编译成能执行的独立 tools。 |
| Environment scaling | EnvScaler、AutoForge、AgentScaler、CuES、GenEnv | 自动生成 executable environments、tasks、validators 或 curriculum | 这是 ASTRA 的最近邻;其组合点是 QA-derived environment、F1 trajectory reward、irrelevant-tool mixing 与两阶段训练。 |
论文对 earlier multi-turn work 的一个重要批评是:有的方法虽然先生成多轮数据,训练时却把它拆成独立 single-step instances,模型仍没有真正学习“读完上一条 tool output 再决定下一步”。ASTRA 保留整段 assistant–tool 交互,并允许 online rollout 最长 32 turns。
不过,“fully automated”也要读得准确。它表示 pipeline 不需要逐条人工标注,不表示每一步都有外部事实 oracle。SFT 的质量主要由 LLM judges 决定;RL tools 由 LLM 根据目标 QA 生成,验证的也是与目标答案的自洽性。这一点决定了它更像一座可扩展的 synthetic training factory,而不是现实 API 的数字孪生。
Q3. 54,885 条 SFT trajectories 是怎样造出来并筛选的?
SFT branch 先把同一个 MCP server 内的 tools 连成 transition graph,再生成 task、执行完整交互,最后用七项 LLM score 过滤 trajectory。
作者从 open MCP registries、RapidAPI、内部 tool specifications 和公开数据集收集文档,统一成 OpenAI-style function calling schema。少于三个 tools、说明含糊或 schema 无法转换的 server 会被丢弃;最后保留 1,585 个 MCP servers、19,036 份 tool documents、41 个 domains。论文明确限制组合发生在同一 server 内,不做跨 server workflow。
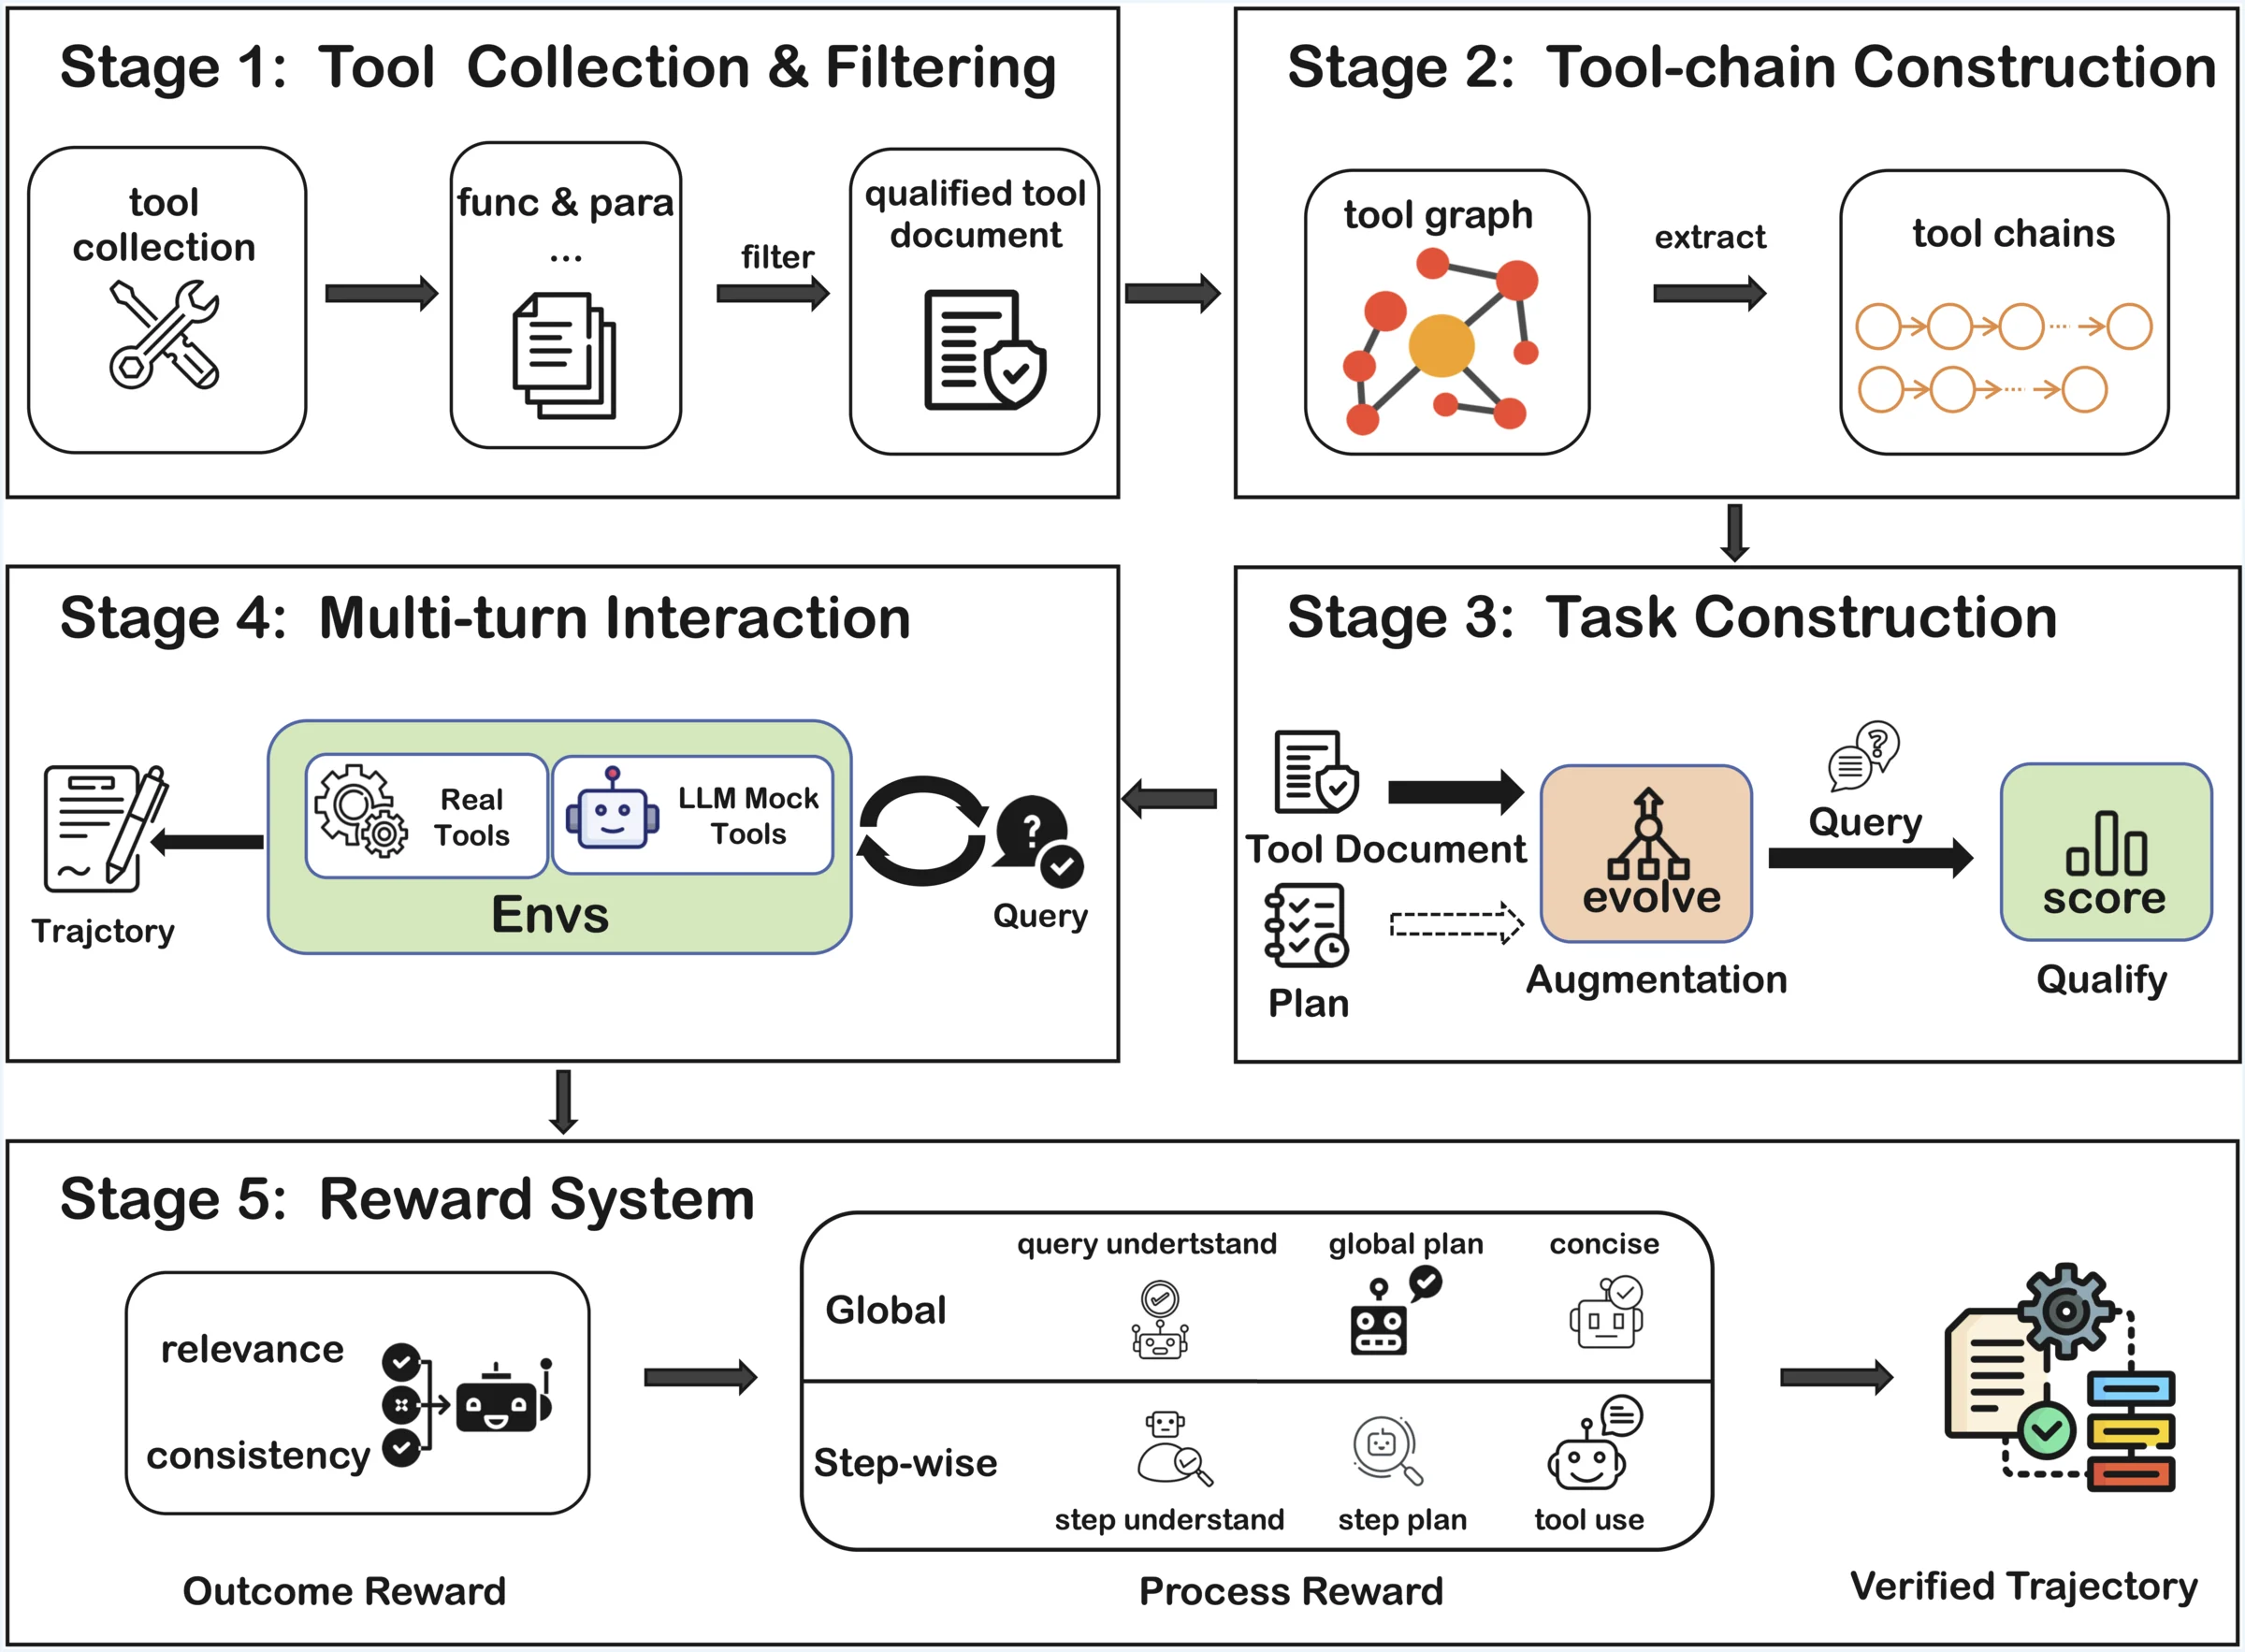
assets/sft-pipeline.png(Apache-2.0),对应论文 Figure 2。它把 tool collection、chain construction、task generation、multi-turn interaction 和 reward system 分成五段。- 1 · COLLECT清洗 schema,按来源 service 分组,过滤不可用 documents。
- 2 · BUILD GRAPHLLM 先提出 task 与 plausible chain;连续 tools 形成有向边,再做 length-bounded random walk。
- 3 · VERIFY检查后续 tool 的 required arguments 能否来自 query 或前序 output,也检查 task-chain coherence。
- 4 · MAKE TASKS合并 chain-conditioned 与 server-only 两类 task,再做 diversity、complexity、persona augmentation。
- 5 · ROLLOUTQwen-Agent 调 deployed MCP 或 stateful emulator,记录完整 trajectory 后评分。
task 先过三项门槛:question quality、scenario realism、tool-use necessity。trajectory 生成时,真实部署的 MCP 会直接执行;只有文档、没有可用 backend 的 tools 则由 stateful LLM emulator 返回结果。为了让模型遇到失败后继续处理,emulated calls 以 20% 概率注入 timeout 或 unreachable 一类错误。
七项 trajectory judge 到底在看什么?
评分分成七个维度,最后取算术平均:
| 维度 | 看哪一段 | 判断内容 |
|---|---|---|
| Query Understanding | 最初 assistant response | 是否正确理解 user query。 |
| Query Planning | 最初 assistant response | 初始 plan 是否可行、完整。 |
| Tool-call Understanding | 每一步局部 context | 是否正确读懂上一条 tool response。 |
| Tool-call Planning | 每一步局部 context | 下一步 action 是否由当前证据支持。 |
| Tool-call Success | 执行记录 | 调用是否成功完成。 |
| Tool Conciseness | 整条 trajectory | 是否有重复或不必要调用。 |
| Final Answer | 最终回答与 tool evidence | 是否相关、完整,并忠实于执行结果。 |
这里有一个论文正文没强调、但公开实现值得注意的细节:judge request 抛异常,或返回对象没有 score 字段时,代码会写入 1.0。
if isinstance(result, Exception):
    scores.append(1.0)
else:
    scores.append(result.get("score", 1.0))
这是一种 fail-open 策略:评审服务失败并不会保守地拒绝样本,反而给满分。论文没有报告实际有多少 trajectories 触发 fallback,因此不能断言它显著污染了训练集;但在复现或扩展时,应改成 fail-closed、重试后隔离,至少把 fallback rate 报出来。
公开代码与论文公式还有一个小差异。论文 Equation 8 把成功调用记为 1、失败调用记为 0;reward.py 实际计算的是 (1.0 × success + 0.5 × fail) / total_calls,因此失败调用仍有 0.5 分。这个差异不会改变“七项求平均”的框架,却会改变 trajectory 的具体排序,复现实验时应该固定以论文还是代码为准。
最终 SFT 数据包含 54,885 个 conversations、580,983 条 messages,每条平均 10.59 条 message 和 4.42 次 tool call,覆盖 6,765 个 unique tool functions。公开 Hugging Face release 是 1,000 条样本,不是论文中的完整 54,885 条。
Q4. 6,596 个 RL environments 怎样生成、验证和给 reward?
RL branch 先把主问题拆成带 dependency 的 sub-QA graph,再把需要外部信息的 sub-question 编成 Python tool。checker 验证代码对目标输入能输出目标字符串;训练时按 sub-task coverage 与 tool-call 数量计算 F1 reward。
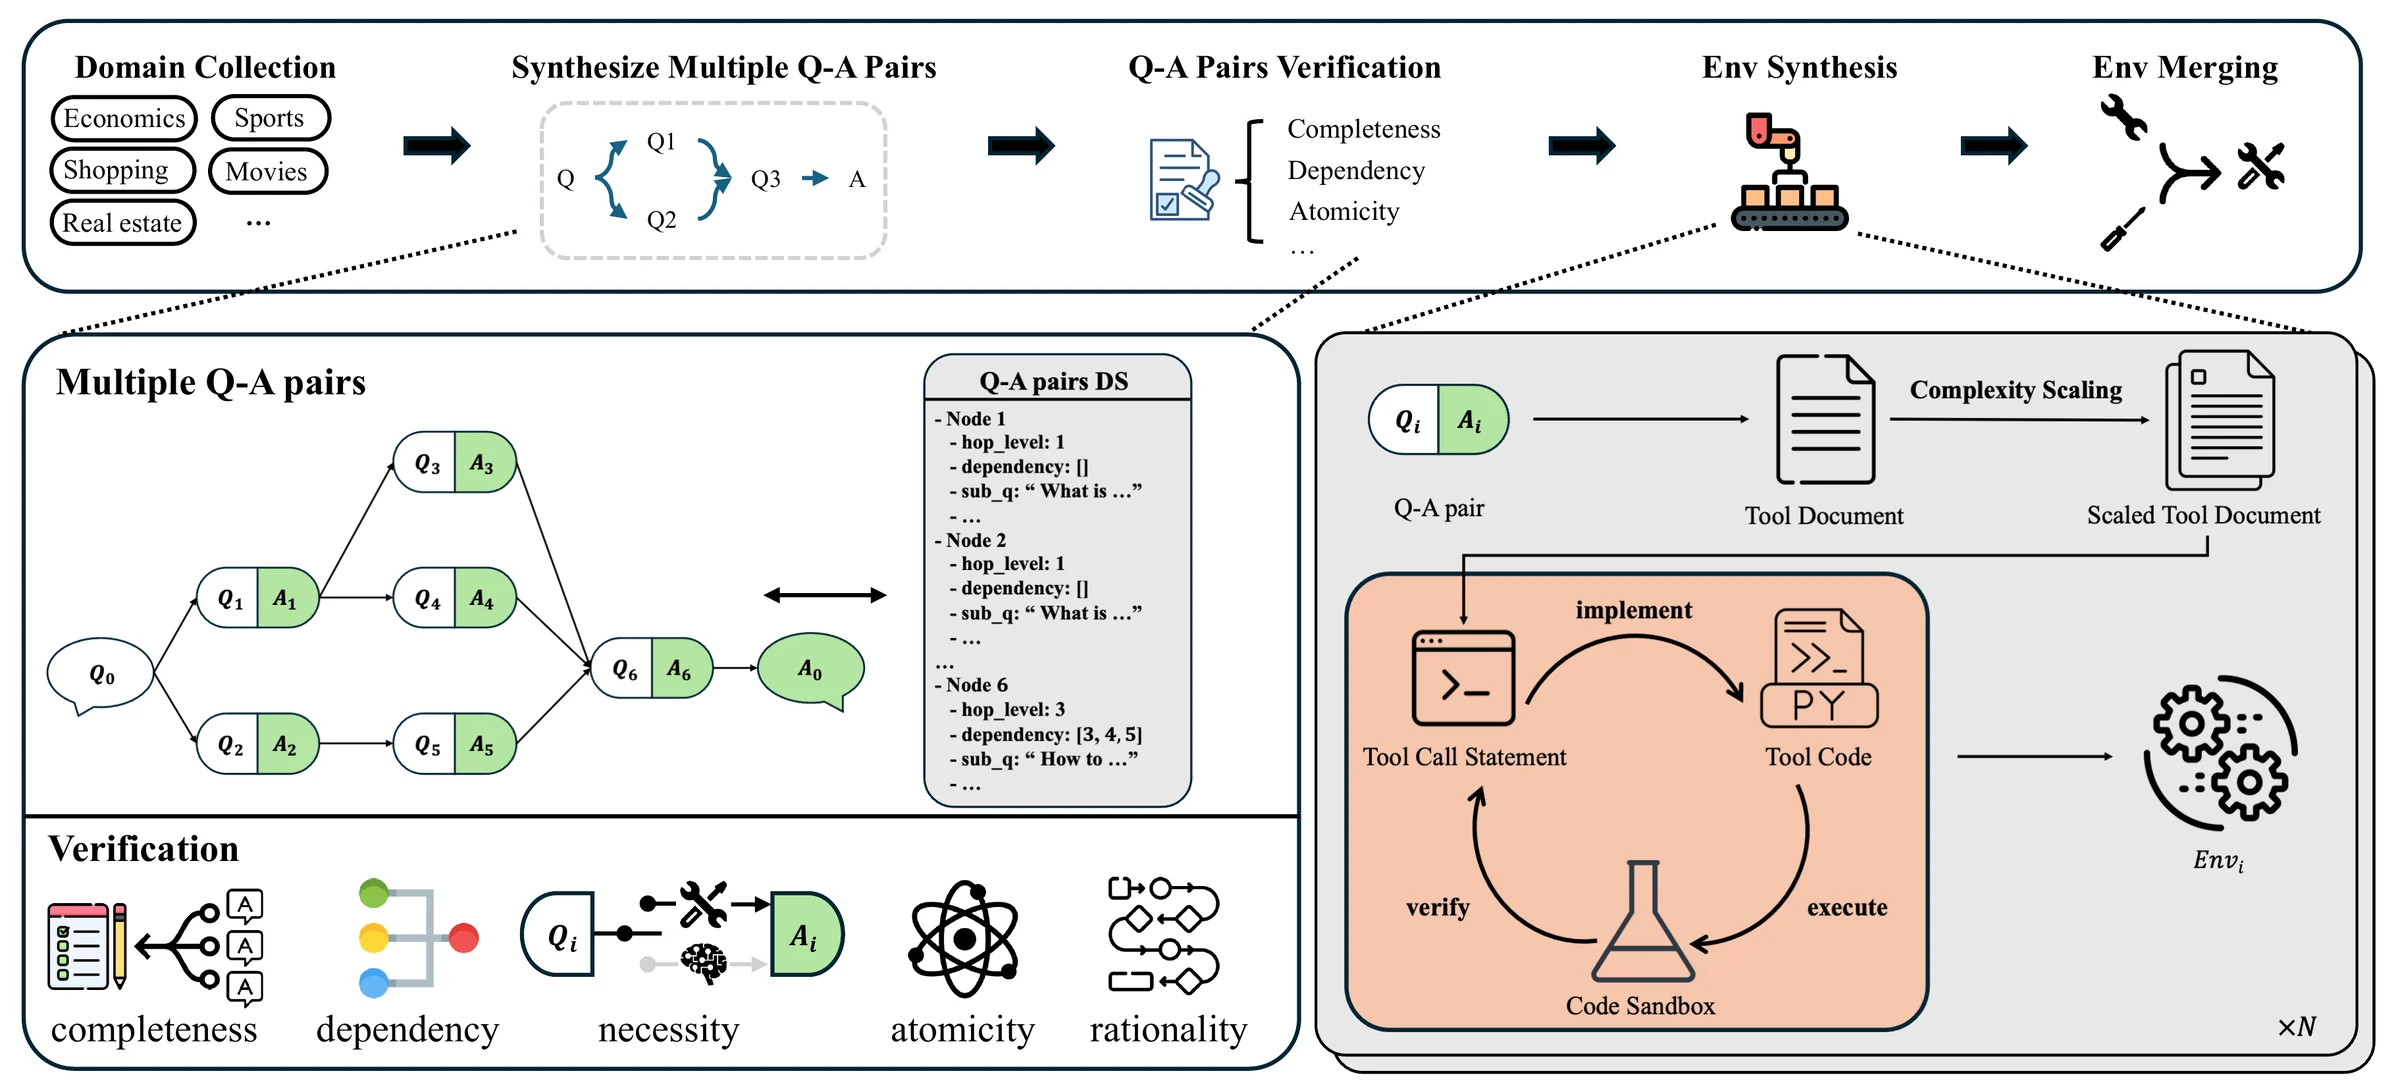
assets/env.png(Apache-2.0),对应论文 Figure 3。QA decomposition、necessity check、verification、environment synthesis 与 tool merging 是构造步骤;它们不是训练时的 reward。主问题先被拆成若干 sub-questions,并显式标出哪些可以并行、哪些依赖前一步答案。LLM 随后做四类结构检查:dependency 是否合理、每个 sub-question 是否 atomic、执行顺序是否正确、合起来是否足以回答 main question。需要 tool 的节点依次生成 tool document、补充 parameters、生成 call statement 和 Python implementation;功能接近的节点最后可以合并到一个 tool 里。
QA 可以由已有 main question 条件生成,也可以让 LLM 根据 domain-specific knowledge source K 和 hop budget H 从头生成。论文只把 K 说明为 text corpus 一类知识源,没有列出这些材料的上游出处、license、去重规则或 train/test leakage audit。公开仓库带有可运行的 knowledge/en/*.jsonl 与 knowledge/zh/*.jsonl 输入,其中也能找到下文行李 case 的来源场景,但仓库同样没有交代这些文本由谁编写或从哪里采集。整个 decomposition 与四项 quality check 都由 LLM 完成,作者没有加入人工标注,也就没有 annotator agreement 可报告。
训练时,policy 看到 user query、当前可选的 tool schemas,以及每次执行后返回的 tool output。sub_qa_dict 中的目标 answers 用来计算 reward,并不作为作答提示交给 policy;每个 sample 的 Python environment 彼此隔离,不共享 state。
Environment validation 验证了什么?
公开 step_04_env_synthesis.py 的关键通过条件如下:
call_ans = get_code_sandbox_ans(final_code)
if call_ans["status"] == "Success":
    if q_a_pairs["answer"] in call_ans["run_result"]["stdout"]:
        is_success = True
也就是说,生成的 Python code 在 sandbox 中执行成功,并且 stdout 包含目标 answer,就算通过;失败则重新生成。这个检查能建立 executable self-consistency:已知 call 确实能得到合成 QA 指定的答案。它没有连接真实 database 或 API,也不检查其他输入上的行为,所以不能把它解释成 factual correctness 或完整的 tool semantics validation。
数据规模是 6,596 个 samples、28,794 个 sub-questions;91.3% 的 sub-questions 需要 tool,平均 4.37 个 reasoning hops。任务中 71.2% 为英文、28.8% 为中文;47.8% 是 Parallel Multi-Hop,34.8% 是 Multi-Hop。公开 release 同样只放出 1,000 条。
训练 reward 与上面的 checker 不是一回事
设一条 job 有 n 个目标 sub-tasks,当前 rollout 命中 n_hat 个,tool 一共调用 c 次:
做全 4 项、正好调用 4 次,reward 接近 1;做全 4 项却调用 6 次,F1 约为 0.80;只做对 3 项、调用 4 次,约为 0.75。这里的 precision 不是分类 precision,而是“每次 tool call 解决了多少目标 sub-task”的效率分。
为防止模型只会在给出的正确 tools 中机械选择,作者还混入 high / medium / low similarity 三档 irrelevant tools,阈值分别是 >0.85、0.4-0.85、<0.4。消融曲线显示不加 distractors 最差,随机加 5-9 个优于不加,但低于分档采样;论文没有提供曲线终点的精确表格值,因此不应从图上臆测具体提升。
一个公开的行李加购 sample:从 task 到 PASS / FAIL
ASTRA-RL-1k train row 0 重绘,revision dbc70e26。绿色路径是数据声明的目标;红色分支是我核对公开 tool_schema 与 tool_dict 后发现的不一致。按执行顺序看这个 released row
- User request。Amit Kumar 要修改 Bengaluru City 与 Chennai Central 之间、9 月 20 日去程和 9 月 23 日返程的 reservation,把 baggage allowance 从 1 件加到 3 件;先告知费用,再用 wallet 支付。
- 目标 sub-QA。
reservation_finder应给出RES987654;baggage_allowance_retriever给出当前 1 bag;baggage_fee_calculator算出额外 ₹600;payment_processor应返回支付成功和TXN123456789。 - 理想 rollout。四个目标都命中、调用四次,
n_hat=4, n=4, c=4,F1 reward 接近 1。重复查 reservation 或 fee 会增加c,即使最终答案完整也会扣分。 - 公开 artifact 的问题。
tool_schema有 9 项,其中两个都叫payment_processor;转成按名称索引的tool_dict后只剩 8 个 unique names。保留下来的 implementation 返回Charge processed successfully...,transaction ID 通常随机生成,无法复现目标Payment successful. Transaction ID: TXN123456789。 - 可能的评测后果。前三个 sub-task 可以命中,但 payment target 按公开实现无法稳定命中。若其他判定逻辑不补偿,结果会落到
3/4一类,而不是理想 PASS。
这是公开 1k 子集中的一行缺陷,不能据此推断内部全部 6,596 个 environments 都有问题。它能说明的是:仅做 answer-in-stdout 的逐 tool validation,没有捕获 tool merging、同名覆盖或最终序列化后产生的跨组件不一致。更可靠的 release check 应该在最终 artifact 上逐行重放全部 target calls,并检查 tool name uniqueness、deterministic outputs 与 reward target 一致性。
Q5. 训练和外部评测具体怎样做,结果说明了什么?
SFT 提供稳定的 cold start,RL 带来更大且更一致的三榜提升;但最终结果同时包含数据、environment、reward、distractor 与 batching 的作用,不能归因给单一组件。
SFT 从 Qwen3-14B 和 Qwen3-32B 开始,各训练 2 epochs;学习率分别为 5e-6 与 2e-6。RL 使用 GRPO,batch size 与 mini-batch size 都是 256,学习率 2e-6;最大 prompt 25,600 tokens,最大 response 49,152 tokens,user 与 assistant 都允许最多 32 turns。作者去掉 KL regularizer 与 entropy bonus,并使用 batch-level token loss averaging。
长轨迹 RL 还有一个常见问题:同一 query 的一组 rollouts 如果 reward 完全相同,group-relative advantage 就是 0,这组样本不产生有效梯度。ASTRA 的 Adaptive Batch Filling 只接受 reward standard deviation 大于阈值的 groups,先把有效 samples 填满 batch,多出来的放入 buffer 留到下一步;它改变的是每次优化时“有没有可学的对比”,不是 environment judge。
| Benchmark | 测什么 | 论文 protocol | 需要注意 |
|---|---|---|---|
| BFCL-v3 MT | 多轮 function calling,含 missing function、missing parameter、long context | vLLM,temperature 0.6 | 论文未报告 repeated trials 或置信区间。 |
| τ²-Bench | agent 与 user simulator 共同推进环境状态 | 排除 airline;GPT-5.1 user simulator;temperature 0;4 trials;报告 pass^1 | airline 因先前报告指出 ground-truth grading 质量问题而排除。 |
| ACEBench | multi-turn 与 multi-step tool use | agent split 50 题;GPT-4.1 user simulator;temperature 0.6;重复 4 次 | 样本仍小,小分差要谨慎。 |
| AIME 2024/2025 | 检查非 agentic 数学推理是否退化 | temperature 0.6、top-p 0.95;top-k 20 与 -1 各 32 generations | 两种 decoding 的 pass-rate estimate 再平均。 |
14B 从 base 到最终 RL,BFCL-MT 为 44.50→58.13,τ²-Bench 为 44.55→57.70,ACEBench 为 51.67→68.96。32B 分别是 47.88→64.25、49.70→63.70、59.79→71.88。三榜方向一致,而且 RL stage 的增量普遍大于 SFT stage。
但 SFT 不是所有子项都变好。BFCL Missing Function 在 14B 上从 39.50 降到 25.50,在 32B 上从 52.50 降到 40.00;RL 后才分别升到 56.00 与 65.50。这说明离线示范能改善常规调用习惯,却可能让 policy 更倾向“总要找个 tool 用”;加入 irrelevant tools 和在线 reward 后,拒绝不存在功能的能力才恢复。
AIME 用于检查核心 reasoning 是否被 tool training 破坏。14B 在两种 decoding 下的平均分别为 73.45→73.40 与 72.60→72.60;32B 为 74.90→74.85 与 74.15→75.15。可以说没有观察到系统性退化,但它不是一般能力的全面评测。
Q6. 这篇论文最值得复用什么,证据边界又在哪里?
最值得复用的是把训练系统分层:SFT data quality、environment self-consistency、trajectory reward 和 external evaluation 各自有独立 contract;最需要补的是 fail-closed validation、最终 artifact 重放与更完整的因果消融。
trajectory_synthesis/data 则有 1,482 个 MCP server rows 和 941 个 task rows。论文的 F1 reward 设计尤其值得保留:它把“任务做了多少”和“用了多少次工具”放到同一个容易解释的 scalar 里;recall-only 会鼓励不断调用,precision-only 会鼓励过早停止,论文的训练曲线也显示两者后期崩溃,而 F1 保持稳定。与此同时,公开 baggage row 说明 reward 再漂亮,也依赖 target 与 environment implementation 对齐。数据工程中的 name collision 或随机输出会直接改变模型收到的学习信号。
如果沿这条路线继续研究,我会优先补三项:第一,在最终 merged environment 上重放所有 golden calls,而不是只验证生成中间件;第二,用真实 API 或独立 simulator 做 held-out transfer,测 mock environment 学到的 policy 能否迁移;第三,在同样 rollout budget 下分别拿掉 SFT cold start、similarity-stratified distractors 与 Adaptive Batch Filling,报告多 seed 的稳定性。这样才能回答提升究竟来自更多合成数据,还是来自更好的训练 contract。
留言