ASTRA 做了两座数据工厂:MCP graph 产 SFT trajectory,QA graph 产可执行 RL environment
它把 cold start、在线 rollout、可执行 mock tool 和调用成本放进同一套训练方案。需要警惕的是:code-executable 只保证代码能跑,不保证 mock tool 对真实世界的描述正确。
四个词先分清,否则很容易把 data filter、environment check 和 RL reward 混成一个 judge
MCP server
一组带 JSON schema 和文字说明的 tools。ASTRA 把同一 server 内的 tools 连成 graph。
Trajectory
user、assistant、tool call、tool output 和最终回答组成的一整段交互记录。
Environment
针对一个 QA decomposition 生成的 Python mock tools。每个训练样本彼此隔离。
Online RL
policy 在当前参数下实时 rollout,工具返回结果后继续决策,再用整条轨迹的 reward 更新。
训练 tool agent 同时缺两样东西:可扩展的示范轨迹,以及能稳定给 reward 的多步环境
人工成本
人工写任务、tool implementation 与验证规则很慢,难以覆盖大量领域和长链调用。
模拟不等于可验证
让 LLM 直接扮演 environment 时,tool output、state transition 与 reward 都可能漂移。
单一训练阶段
SFT 缺在线反馈;pure RL 又受 base policy 能力限制,弱初始模型很难探索到有效轨迹。
ASTRA 的回答是两阶段:SFT 先建立调用习惯,随后在每个样本独立的 Python environment 里做 multi-turn online RL。
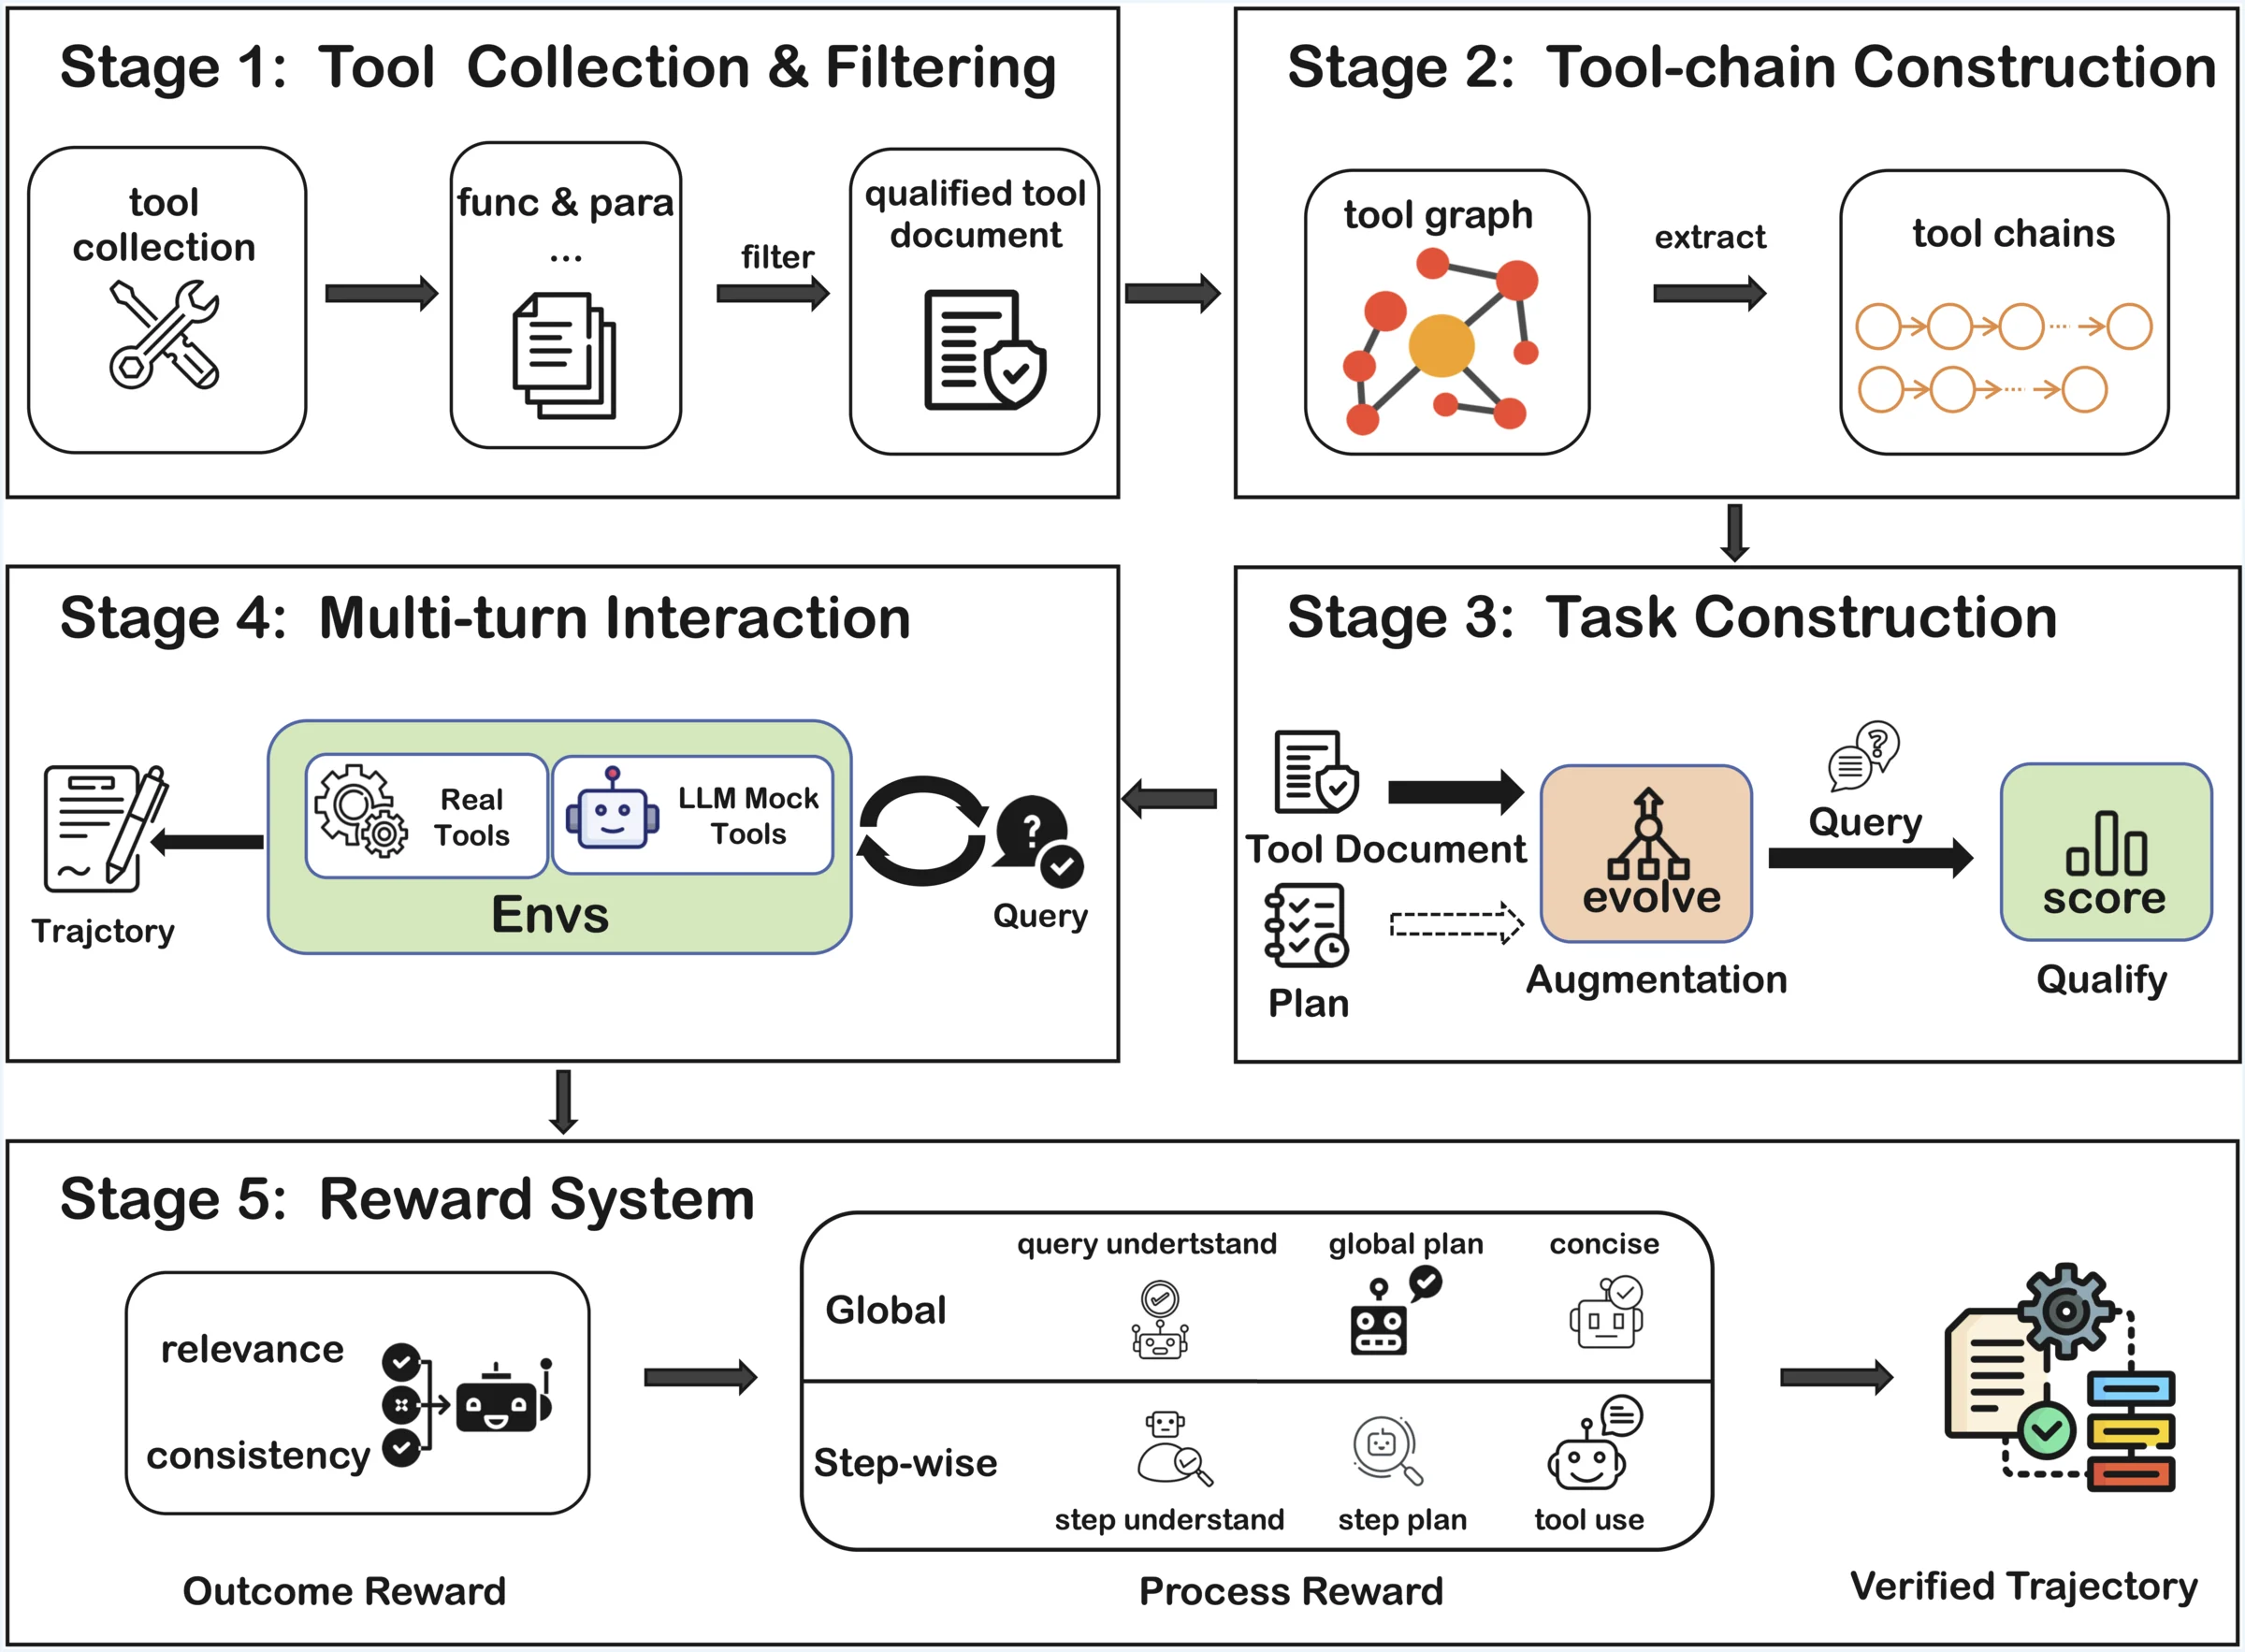
先限定同一 MCP server,再用 tool transition graph 扩展可能的调用链
至少 3 个 tool;说明可执行;schema 能转成 OpenAI function calling。
LLM 先给 task + chain,连续调用形成有向边,再做 length-bounded random walk。
检查后续参数能否由 query 或前面 tool output 支持,也检查 task-chain coherence。
chain-conditioned 与 server-only 两种 task;改写 diversity、complexity、persona。
Qwen-Agent 调真实 MCP 或 stateful emulator;mock call 以 20% 概率注入失败。
七项分数做算术平均;公开实现遇到 judge 异常时会写入 1.0
QU
query understanding
QP
initial planning
TCU
理解上一条 tool response
TCP
据此安排下一步
TCS
tool call success rate
TC
调用是否必要、无重复
FA
final answer 相关且忠实
if isinstance(result, Exception):
    scores.append(1.0)
else:
    scores.append(result.get("score", 1.0))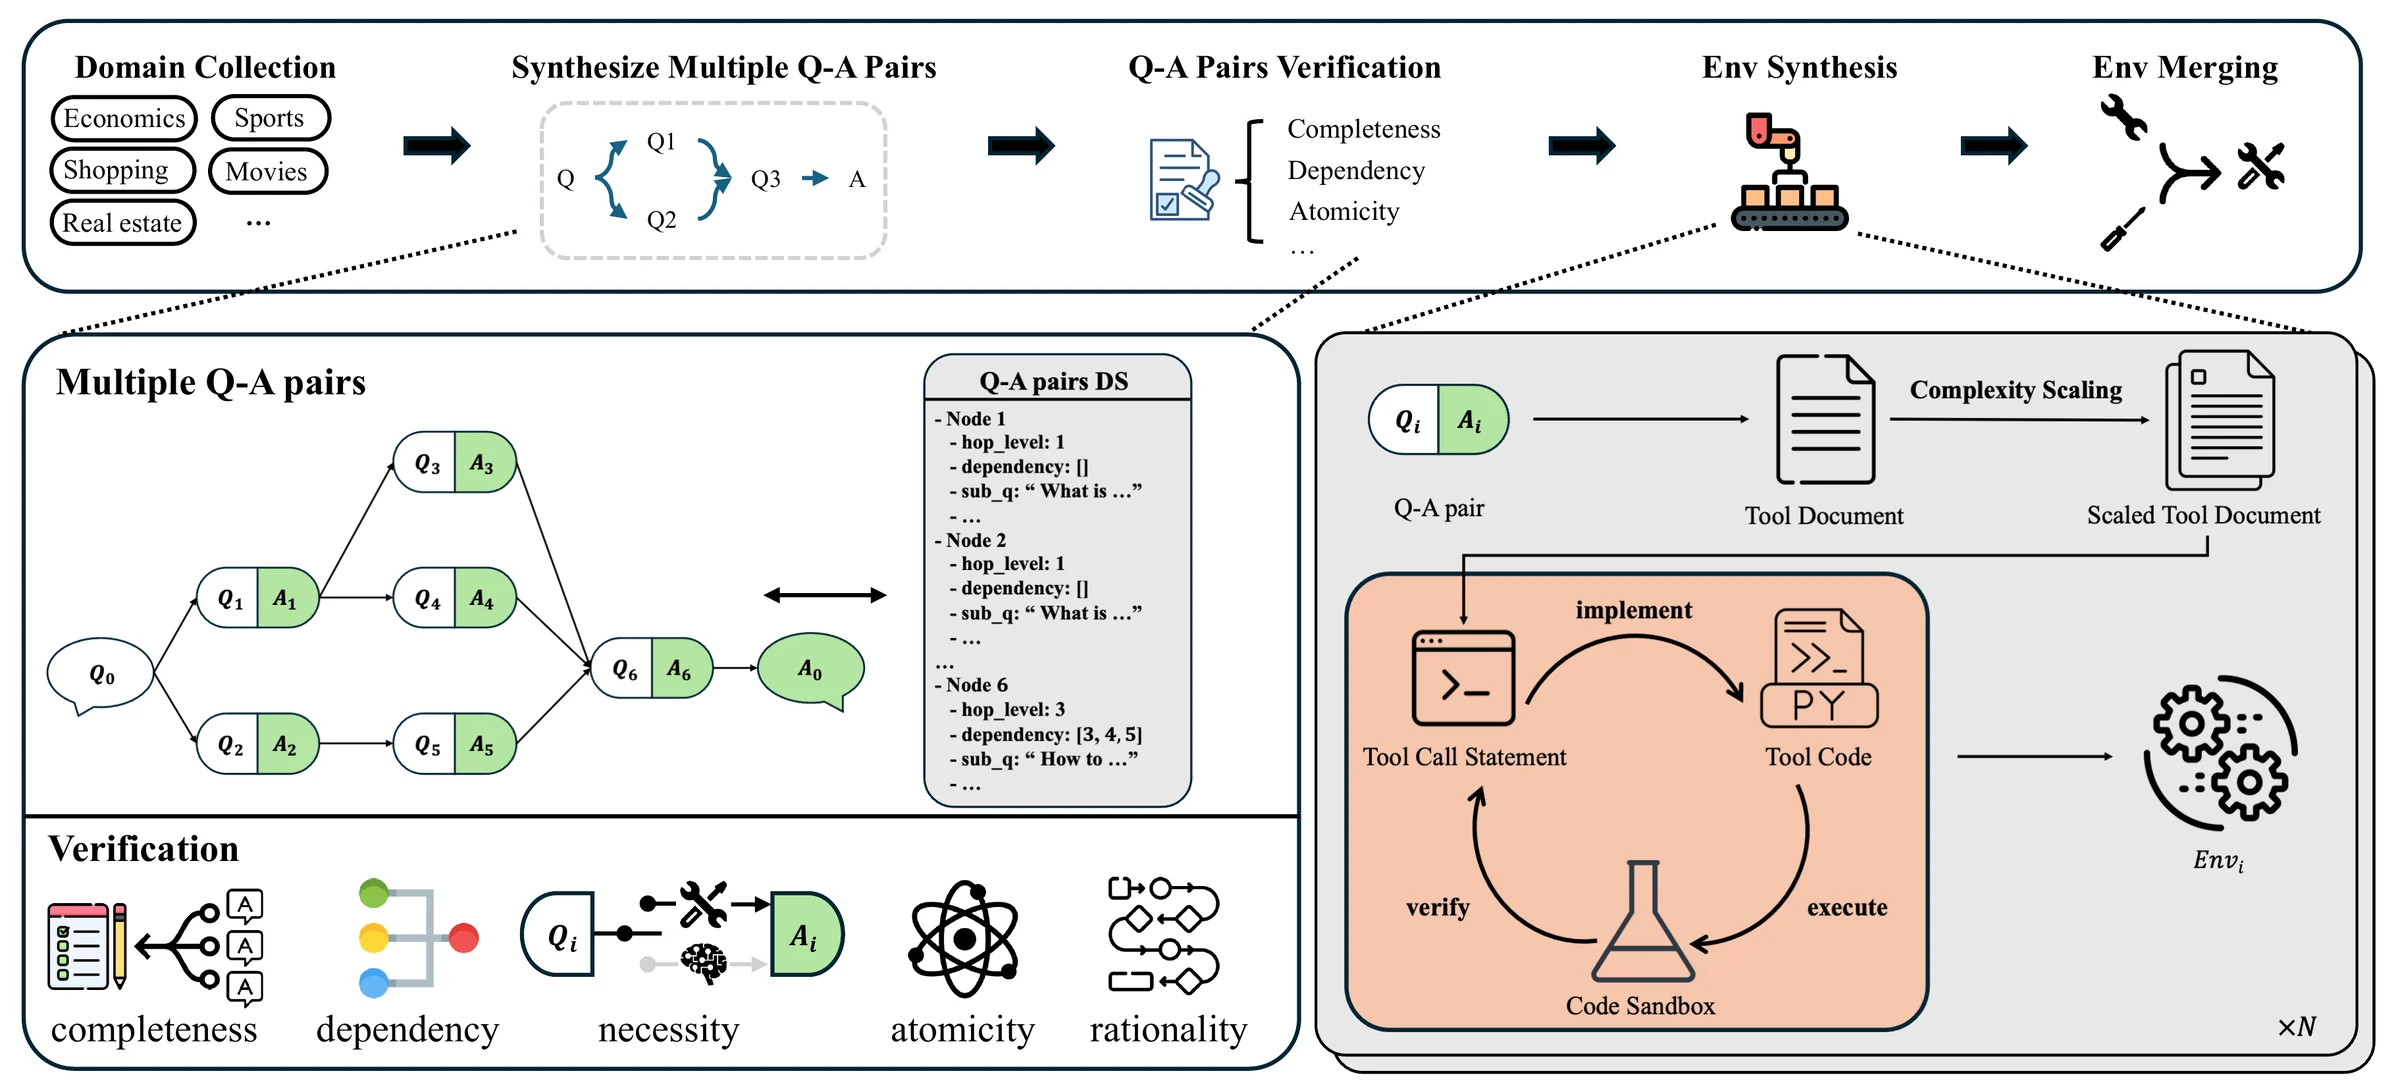
每个非叶子 sub-question 被编成一个 Python tool;通过条件只是 stdout 包含目标 answer
生成 main QA 与带 dependency 的 sub-QA。
dependency、atomicity、order、completeness。
tool doc → 增加参数 → call statement → Python code。
运行代码,检查 stdout;失败则重生成。
同功能 sub-question 合并到一个带更多记录的 tool。
call_ans = get_code_sandbox_ans(final_code)
if call_ans["status"] == "Success":
    if q_a_pairs["answer"] in call_ans["run_result"]["stdout"]:
        is_success = True
这能证明生成代码对目标输入返回目标字符串。它没有外部 database 或真实 API 作为 oracle,也没有验证其他输入是否合理。
reward 只看命中了多少 sub-task,以及为此发了多少次 tool call
4 / 4,调用 4 次
r = 1,p ≈ 1,F1 ≈ 1。每次调用都解决一个需要的 sub-task。
4 / 4,调用 6 次
r = 1,p ≈ 0.67,F1 ≈ 0.80。答案全了,但两次调用没有增加已解 sub-task。
3 / 4,调用 4 次
r = 0.75,p ≈ 0.75,F1 ≈ 0.75。公开 baggage row 的 payment mismatch 会落在这类边界附近。
示例忽略 ε 的极小修正。n̂ 如何由 sub-QA 命中判定,依赖合成环境的目标字符串。
每题额外混入三档 irrelevant tools,逼 policy 学会“不要调用”
High similarity > 0.85
近似功能的 near-miss 最难排除。同 domain 候选会先被剔除,以免直接重复。
Medium 0.4-0.85
有部分语义重叠,但不能完成当前 sub-task。
Low similarity < 0.4
明显不相关,提供容易的负例。
同组 rollout reward 全相同时,GRPO advantage 变成 0;ASTRA 用 buffer 补齐有效样本
同一 query 采样 G 条 trajectory。
Std(R) > δ 才算 valid,说明组内有可比较的好坏。
valid 超过 batch size 时,余下样本留到下一轮。
每步凑够 n 个 learning-active samples 再更新。
论文设置
batch = mini-batch = 256,learning rate 2e-6;prompt 25,600 tokens,response 49,152 tokens,最多 32 turns。
目标函数细节
基于 GRPO,省去 KL regularizer 与 entropy bonus,并使用 batch-level token loss averaging。
三项 agentic benchmark 的重复次数、temperature 和 user simulator 并不相同
| Benchmark | 测什么 | 论文 protocol | 结果汇总 |
|---|---|---|---|
| BFCL-v3 MT | 多轮 function calling,含 missing function / parameter / long context | vLLM,temperature 0.6 | 四个子项平均为 overall |
| τ²-Bench | agent 与 user simulator 共同控制状态 | 排除 airline;GPT-5.1 user simulator;temperature 0;4 trials | 报告 pass^1 |
| ACEBench | multi-turn 与 multi-step tool use | agent split 50 题;GPT-4.1 user simulator;temperature 0.6;重复 4 次 | mean accuracy |
| AIME 2024/2025 | 非 agentic 数学推理保真 | temperature 0.6,top-p 0.95;top-k=20 与 -1 各 32 generations | 两个 pass-rate estimate 再平均 |
论文没有为 BFCL-MT 报告重复运行或置信区间;ACEBench 50 题即使重复 4 次,仍应谨慎解读小分差。
RL 带来最稳定的三榜提升;SFT 有明显 cold-start 收益,也有局部退化
一致的 headline gain
14B:BFCL 44.50→58.13,τ² 44.55→57.70,ACE 51.67→68.96。32B:47.88→64.25,49.70→63.70,59.79→71.88。
SFT 不是单调改善
BFCL Missing Func:14B 39.50→25.50,32B 52.50→40.00;RL 才分别升到 56.00 与 65.50。
AIME 基本保留
两个 decoding 设置下,14B 平均几乎不变;32B 一个设置 -0.05,另一个 +1.00。
F1 reward ablation
recall-only 让 turns 快速增长后训练崩溃;precision-only 让 policy 过早停止,也在后期崩溃。F1 曲线保持稳定。
还不能归因到单一组件
最终系统同时改变 SFT data、RL environment、irrelevant tools、reward 与 batching。论文没有完整 factorial ablation。
ASTRA 位于“轨迹合成”和“可执行环境扩展”两条路线的交叉点
| 路线 | 代表工作 | 主要对象 | ASTRA 的边界 |
|---|---|---|---|
| 大规模 tool trajectory | ToolLLM、ToolACE、Toucan | 从 API / MCP inventory 生成调用数据 | ASTRA 也从 tool docs 起步,但加上同 server transition graph 与第二阶段 online RL。 |
| 多轮轨迹生成 | MAGNET、ToolACE-MT、APIGen-MT | graph、blueprint 或 simulated human-agent dialogue | ASTRA 的 SFT 分支接近这一类;RL 分支不用固定 golden tool sequence。 |
| 数据闭环与 text-to-trajectory | LoopTool、GEM | 针对 model weakness 迭代数据,或从文本抽取隐含流程 | ASTRA 的差别在于把 QA decomposition 进一步编译成 Python environment。 |
| Environment scaling | EnvScaler、AutoForge、AgentScaler、CuES、GenEnv | 自动构造 executable environment、validator、task 或 curriculum | 这是最接近的路线;ASTRA 的组合点是 SFT cold start + isolated QA-derived tools + online GRPO。 |
值得复用的是训练系统的分层;最需要修的是 validation 的 fail-open 与公开样本一致性
论文已经给出
- 一套自动生成 SFT trajectory 与 RL environment 的端到端 pipeline。
- F1 reward 把 sub-task coverage 和 tool-call efficiency 放进同一个标量。
- 14B / 32B 在三项 agentic benchmark 上都有大幅阶段性提升。
- 代码公开到 pipeline 级别,并发布两个 1k 数据子集和模型。
仍需单独验证
- answer-in-stdout 只能证明自洽,不能证明 mock tool 的外部真实性。
- LLM judge 异常默认 1.0,可能让坏样本通过。
- 公开 RL row 0 存在同名 tool collision 与目标输出不一致。
- 公开仓库没有论文完整数据与 RL training scripts;实验也缺多 seed 和完整组件消融。