[2026-06-09] Self-Distillation Policy Optimization via Visual Feedback: Bridging Code and Visual Artifacts
模型写出代码后,训练程序执行它,让模型多看画面再判断哪些代码应该改。Visual-SDPO 还把遮挡、裁切等问题关联到源码,增加相关语句的训练权重。
模型写出代码后,训练程序执行它,让模型多看画面再判断哪些代码应该改。Visual-SDPO 还把遮挡、裁切等问题关联到源码,增加相关语句的训练权重。
答对选项也可能看错图。V-Rubrics 把视觉事实、推理和输出要求分开判分,再将每项训练信号分配给回答的相应前缀。本文用公开潮汐题复算奖励,核对原论文图表与代码边界。
GAGAR 如何比较多次通过测试的代码修改质量,再重新分配训练权重;拆解判分 Agent、计算公式、训练结果、带上限的实现与未公开证据。
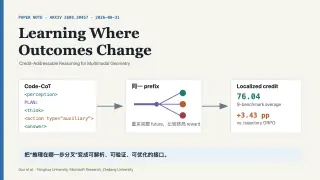
把几何解题过程写成带标签的步骤,固定某一步以前的内容,再从这里生成不同完整解法,用最终分数差训练后半段。结合等腰三角形真实案例,说明数据来源、评分、更新范围与实验限制。