让 Agent 操作原软件、写代码复刻,再用基于原软件的隐藏测试检查
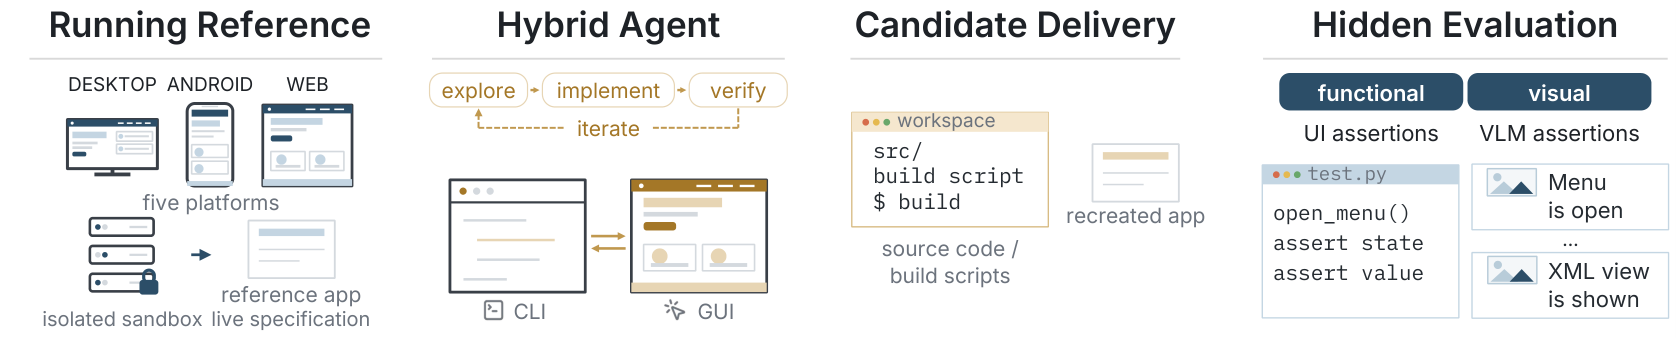
同一个 Agent 操作原软件、写代码、启动自己的版本,再观察差异继续修改。原软件叫 reference,新版本叫 candidate。RecreationBench 用程序读取和画面判断两条通道检查最终行为,分别记为 Prog 与 VLM。
同一个 Agent 交替探索界面、写代码并检查新版本
点击、输入、打开菜单;发现窗口、状态与计算结果。
写源代码、构建脚本与启动入口;选择自己的架构。
启动成品,操作并观察错误,再决定去哪里复查或修改。
复刻任务要求两类工具配合,也提供可重复的检查依据
两类能力都需要
只点界面无法交付代码;只写代码又不知道原软件真正怎样响应。
以原软件验证检查
先在原软件上得到结果,再把同一组输入、动作和观察条件用于新版本。
继续扩展训练记录
大量开源软件可转换成新任务,得分高的完整执行记录可筛选成训练数据。
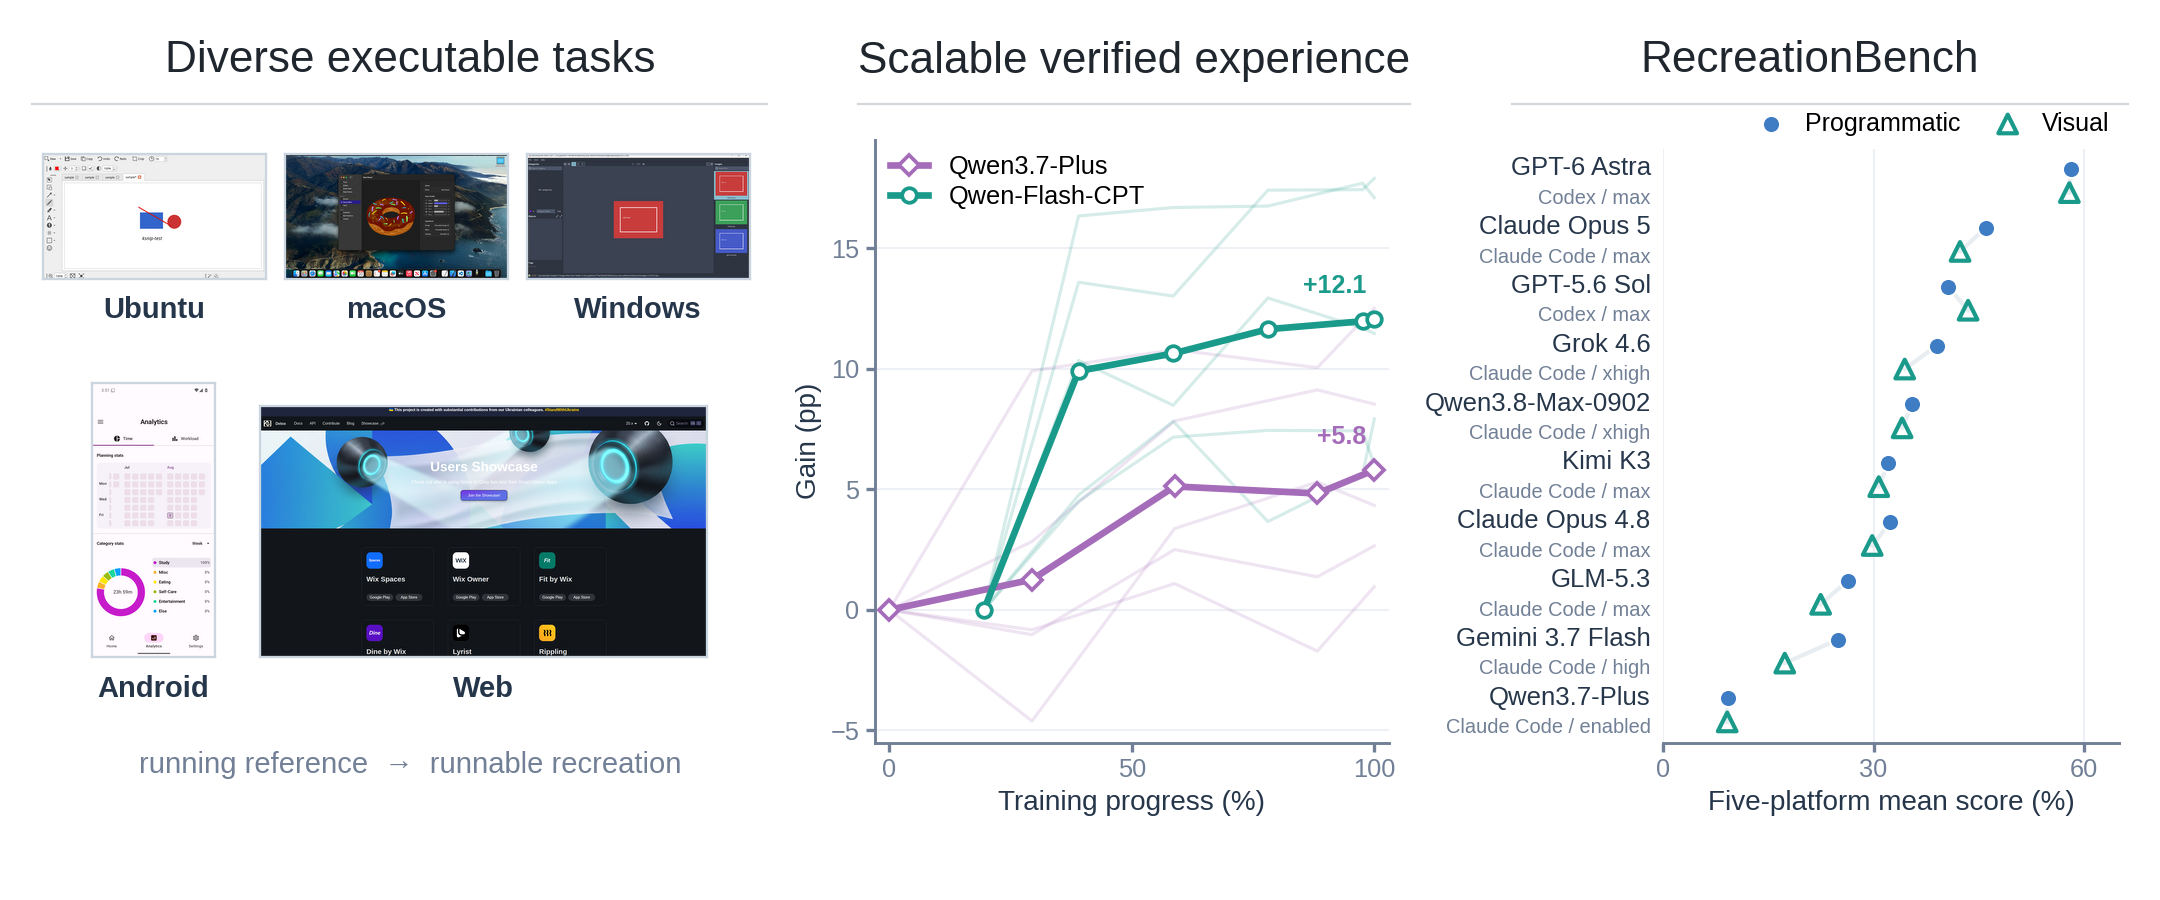

五个平台各 50 个任务,但来源和可见边界不同
| 平台 | 原软件来源与筛选 | 交付物 | 程序读取接口 |
|---|---|---|---|
| Ubuntu | 开源应用,固定上游版本;排除构建不稳定或依赖在线服务者 | 源码、构建与启动入口 | AT-SPI |
| macOS | 开源 AppKit / SwiftUI 等,也含菜单栏应用 | 源码、构建与启动入口 | AXUIElement |
| Windows | 开源 .NET / JVM 等,固定代码版本 | 源码、构建与启动入口 | UI Automation |
| Android | 不声明联网权限、核心状态在本机 | Gradle → APK | UiAutomator |
| Web | 44 个合成站点 + 6 个公开网站 | React 起始项目 → index.html | DOM / ARIA |
桌面与 Android 尽量隐藏原软件源码;Web 必然向浏览器发送网页代码,因此保护的是另行采集的参考结果与测试。
隐藏测试以原软件运行结果为准,先回放再人工复核
从源码或页面分析找功能入口与可测试状态。
实际操作原软件,记录指定动作产生的结果。
准备固定输入文件、动作序列与程序/视觉观察条件。
在重置后的原软件上跑;不稳定或不通过的测试淘汰。
人工检查输入、动作与预期观察,随后冻结。

程序与画面互补,但必须区分缺少画面与 judge 失效
Prog
用 AT-SPI / AXUIElement / UI Automation / UiAutomator / DOM-ARIA 等平台接口读取控件文字、状态、导航与计算结果。构建或启动失败使整个任务为 0。
VLM
在固定检查位置截取完整应用窗口,用 Qwen3.7-Plus、temperature 0 判断布局、颜色、绘图区和图例等观察条件。输出必须逐项给 JSON 判断。
SYSTEM_PROMPT: pass=true only when the assertion is clearly and fully satisfied

missing / incorrect / placeholder / visibly mismatched element → FAIL
论文 §4.4 要求传输或解析错误重测。Web 当前代码另有处理:缺截图记 0;judge 无判断记 None,排除视口并重算权重;全站无判断时退回图像相似度。不能据此确认历史榜单已全部重测。
程序与画面分母不同,58.06 不能当作整题通过率
桌面 / Android
Prog 按冻结测试 case 的通过比例;VLM 按视觉断言通过比例。两条通道的分母不同。
Web
功能检查按具体程度加权;视觉先按页面和视口汇总,再合并桌面与手机。
共同汇总
平台内对应用等权平均;五个平台再等权;最后取 Prog 与 VLM 的均值。

用保留变量的执行环境批量操作界面,质量近似不变、开销下降
质量
Prog 35.05→35.60;VLM 31.00→32.29。
实际时间
每任务 4.12→3.04 小时,下降 26.1%;输出 token 增加 15.7%。
证据边界
每个任务/配置只运行一次;完整配置一起变化,不是单变量因果实验。
资源统计来自 39 对完整记录,质量统计来自 50 对有效评分。成本按公开 API 价格、90% cache-read 假设估算,不是账单,也未包含机器开销。
用复刻记录训练后,五项未见评测都提升,但还缺关键对照
Qwen3.8-Max 生成五平台复刻软件的执行记录。
每个平台 7,000 条,组成 35,000 条监督数据;条数均衡,不是 token 权重均衡。
从两个不同初始模型分别训练一次。
五项未见评测;Flash 在 OSWorld 从 28.2→46.1,+17.9 是这一个子项,不是五榜平均。
看见的信号
两次训练的最后模型存档都高于第一个被评测存档;也更常检查自己的运行画面。
没公开
所选记录、训练后模型与完整超参数。
没控制
多个训练随机种子,以及等量普通代码记录的对照。
最完整的是可执行链路;最需要补的是 VLM 校准、重复运行和训练消融
论文已经讲清
- 一套五平台交付规则连接界面探索与写代码。
- 隐藏测试先在原软件重置回放,再经人工复核冻结。
- Prog 与 VLM 互补,五平台等权聚合。
- 强模型平均分较高,但程序检查全部通过仍罕见。
仍然不能推出
- 有限隐藏测试不能证明行为完全等价。
- 视觉判分没有人工校准或一致性报告。
- 无法排除模型预训练时已经见过这些公开软件。
- 单次执行不能说明小分差稳定,也不能把整套配置的节省归到单一组件。