给出“设计一间安静的卧室”,生成器要决定房间结构、摆床、让床头柜和阅读灯配套,还要发现挡门、碰撞与动线问题。Scene-Designer 的主张是:让模型积累逐步编辑的经验,也学会比较场景优劣,再用这些判断改善下一次编辑。本文重点追两件事:Scene-GRPO 相对普通 GRPO 具体改了什么;模型调用的场景工具究竟由谁提供。
1. Motivation:会摆物体,还不等于会设计与改错
难点是编辑的先后和场景关系。床、灯和柜子都放进房间,仍可能挡门、尺寸不对、阅读灯照不到座位,或反复移动同一物体。作者先让 GPT-5.2 在 SceneSmith 的场景构建流程中生成 100 个场景,统计每类错误要经过多少次修正。论文 Figure 2 中,交互朝向错误有 40% 的纠正案例花了至少五次编辑,窗户可达性阻挡为 18%。分母是各错误类别里的纠正案例,不能读成“40% 的全部场景失败”。
作者把目标拆为两种能力:design 决定下一步怎样改,critique 判断当前和候选场景的物理、功能、布局质量。这里的“会批评”并不是用一套显式 CAD 规则替代物理检查;Critic 主要学习渲染图中的偏好,几何工具仍执行硬约束检查。来源:论文 §1、Figure 1–3。
2. Related Work:与静态布局、SceneSmith 和普通 GRPO 的边界
这篇把场景构建过程本身当训练对象。静态场景数据告诉模型最终物体在哪;SceneSmith 已经能把自然语言变成多步工具操作;Scene-Designer 在它上面加入有效轨迹、场景偏好和 Critic 引导的 RL。
| 路线 | 模型看到什么、产出什么 | 如何判断与本篇差异 |
|---|---|---|
| ATISS / DiffuScene 等 | 条件或场景分布 → 静态物体布局 | 强调最终布局;不提供本篇使用的逐步工具纠错轨迹。论文 §2、Appendix A。 |
| SceneSmith | 文字需求、阶段状态和工具反馈 → 多轮场景工具调用 | 提供几何、资产、渲染及物理模拟底座;本篇在其上训练本地 policy 与 Critic。论文 Appendix F、公开集成代码。 |
| 普通 GRPO | 同一输入 → 一组候选回答和标量奖励 | 组内标准化、剪切策略更新。本篇专门定义“同一父场景的编辑分支”及场景奖励,目标函数仍采用 GRPO。论文 §3.2、Appendix C;公开代码的 grpo_objective.py。 |
3. Method:从工具轨迹到 Scene-GRPO
3.1 两种监督先把模型训练成 Scene-Builder
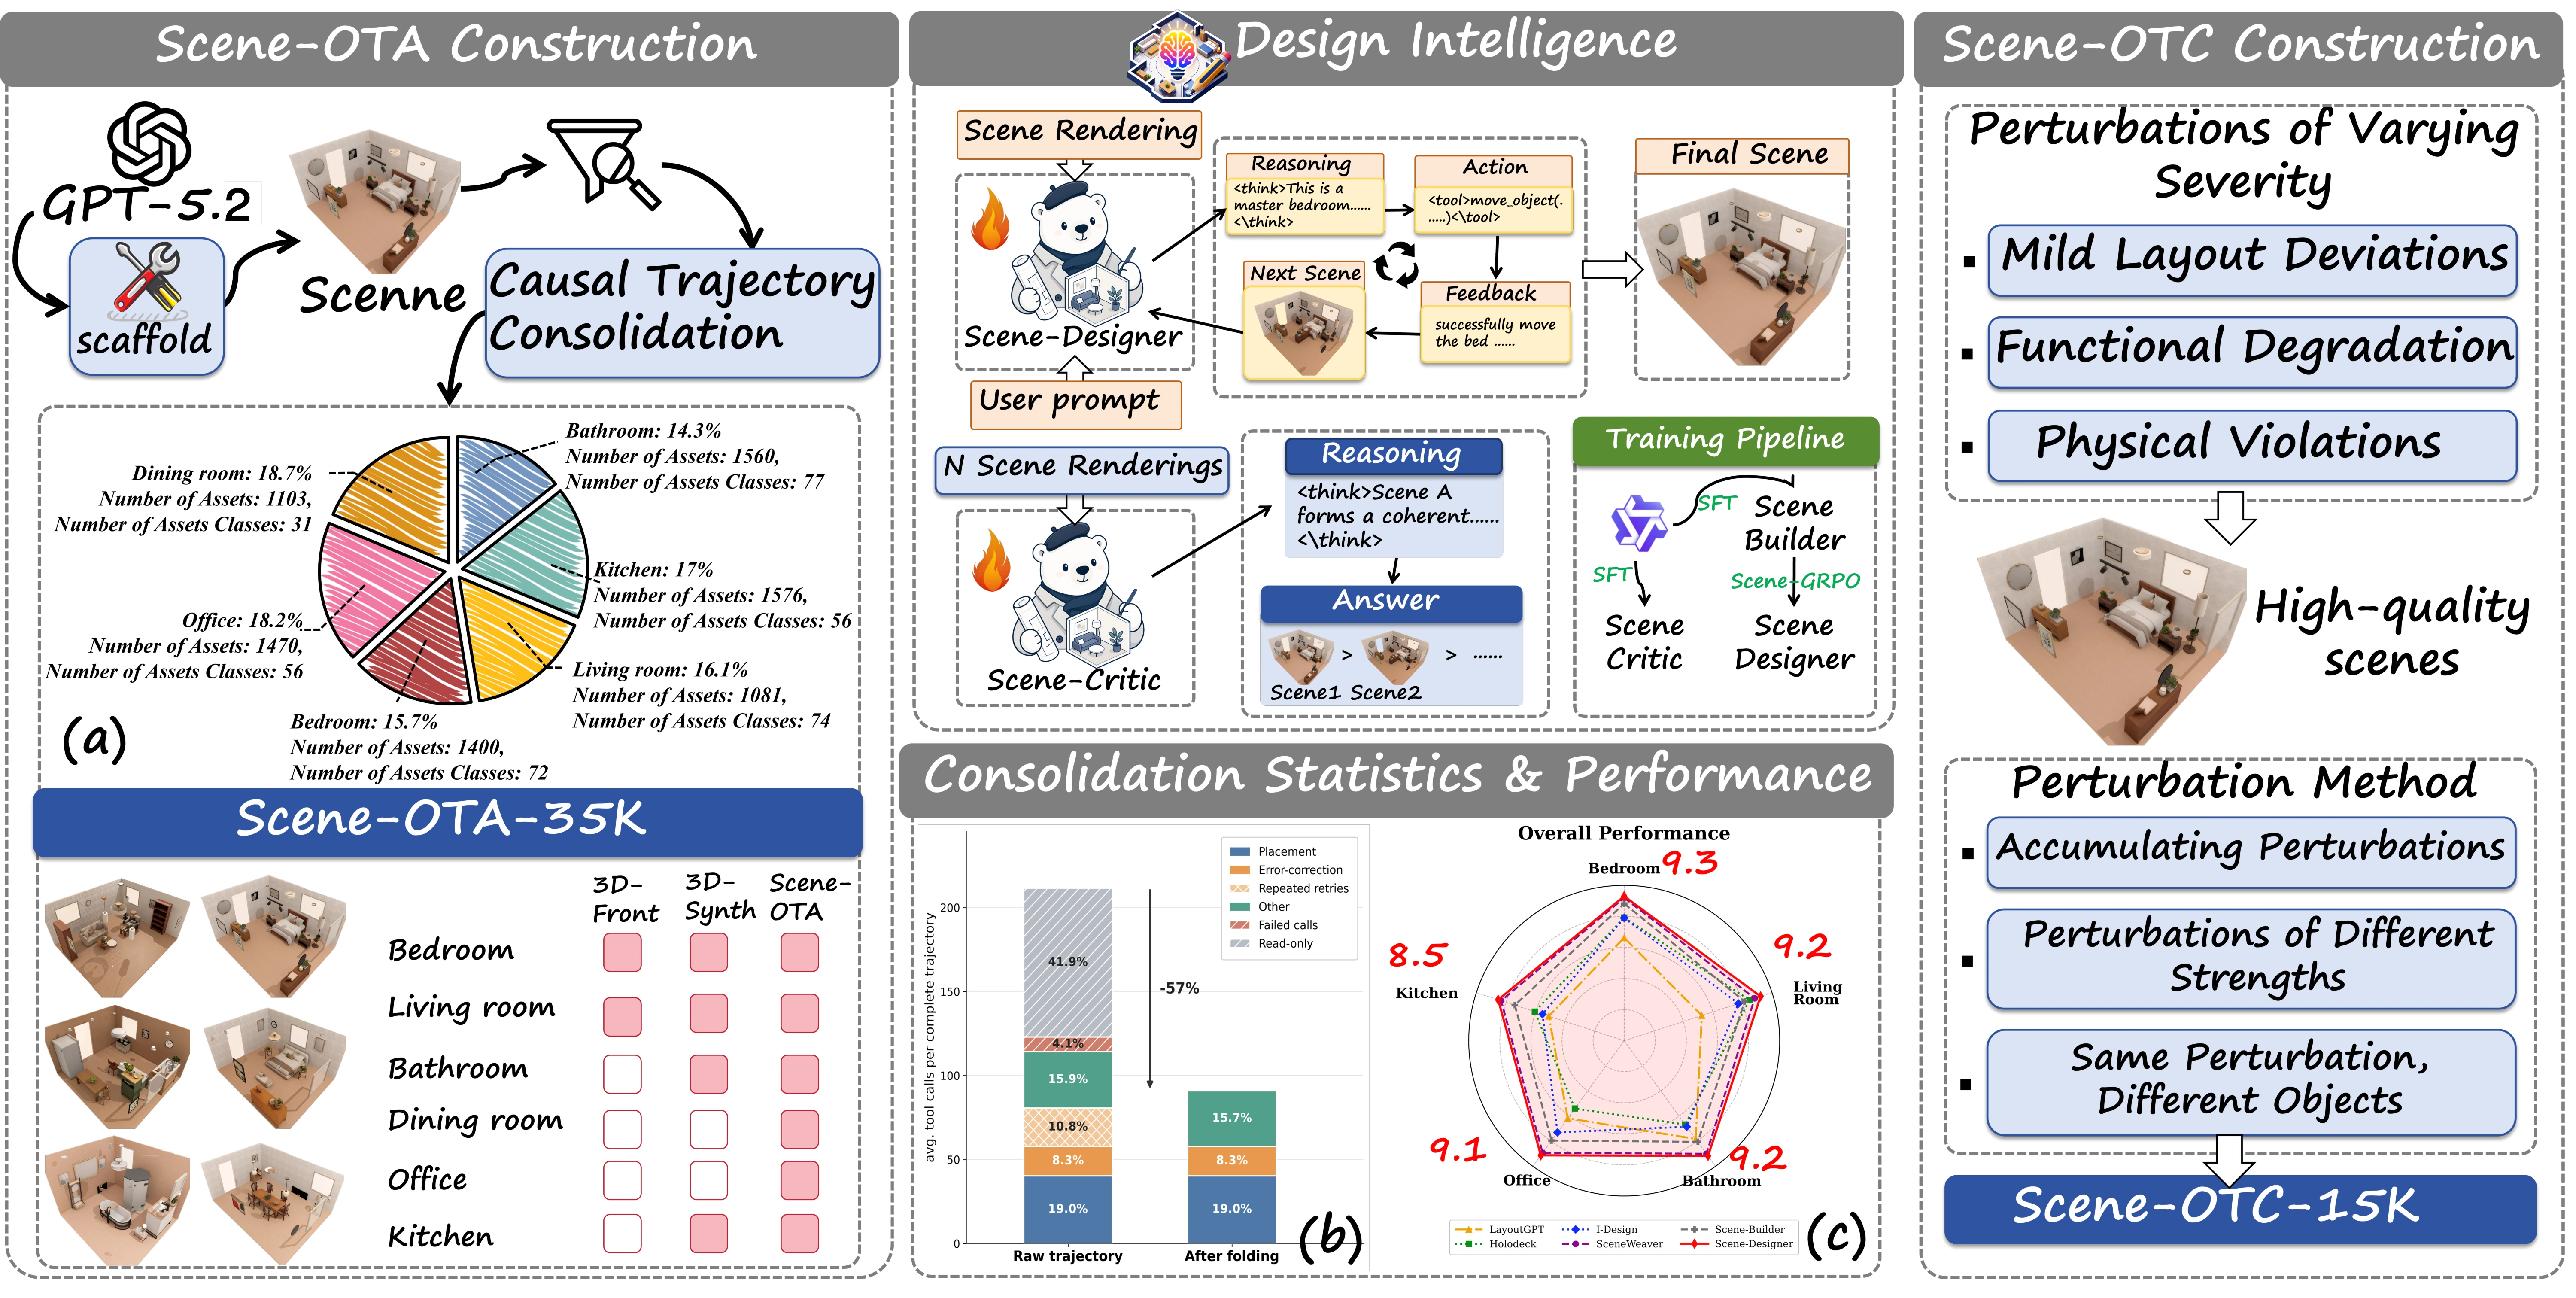
作者先借 SceneSmith 与 GPT-5.2 生成场景,人工挑出高质量结果,再处理原始动作。Scene-OTA-35K 是 1,000 个场景中的约 35,000 个“观察—思考—动作”步骤。轨迹压缩先找那些没有改善最终状态或错误数的可疑编辑,再请 GPT-5.2 根据上下文判断能否删除;作者回放压缩轨迹,要求最终场景状态保持一致,并人工复核。正文报告轨迹约从 110 步降到 30 步。它的用途是教模型怎样构建与纠错,不是 RL 阶段的 reward。
Scene-OTC-15K 从优质场景制造不同严重程度的布局、功能与物理扰动,让模型学习多图排序及理由。相同扰动施于不同物体时,影响需要人工标注;部分其它排序按扰动严重度自动生成。约 15,000 个比较样本用于 Critic 学习;另有 94 道二图比较和 55 道四图排序作为测试集。作者把两类数据联合监督微调 Qwen3-VL-8B-Instruct,得到 Scene-Builder,再复制为可训练 policy 和冻结 Critic。来源:论文 §3.1、Appendix D.2–D.3。
3.2 Scene-GRPO 到底在 GRPO 上改了什么
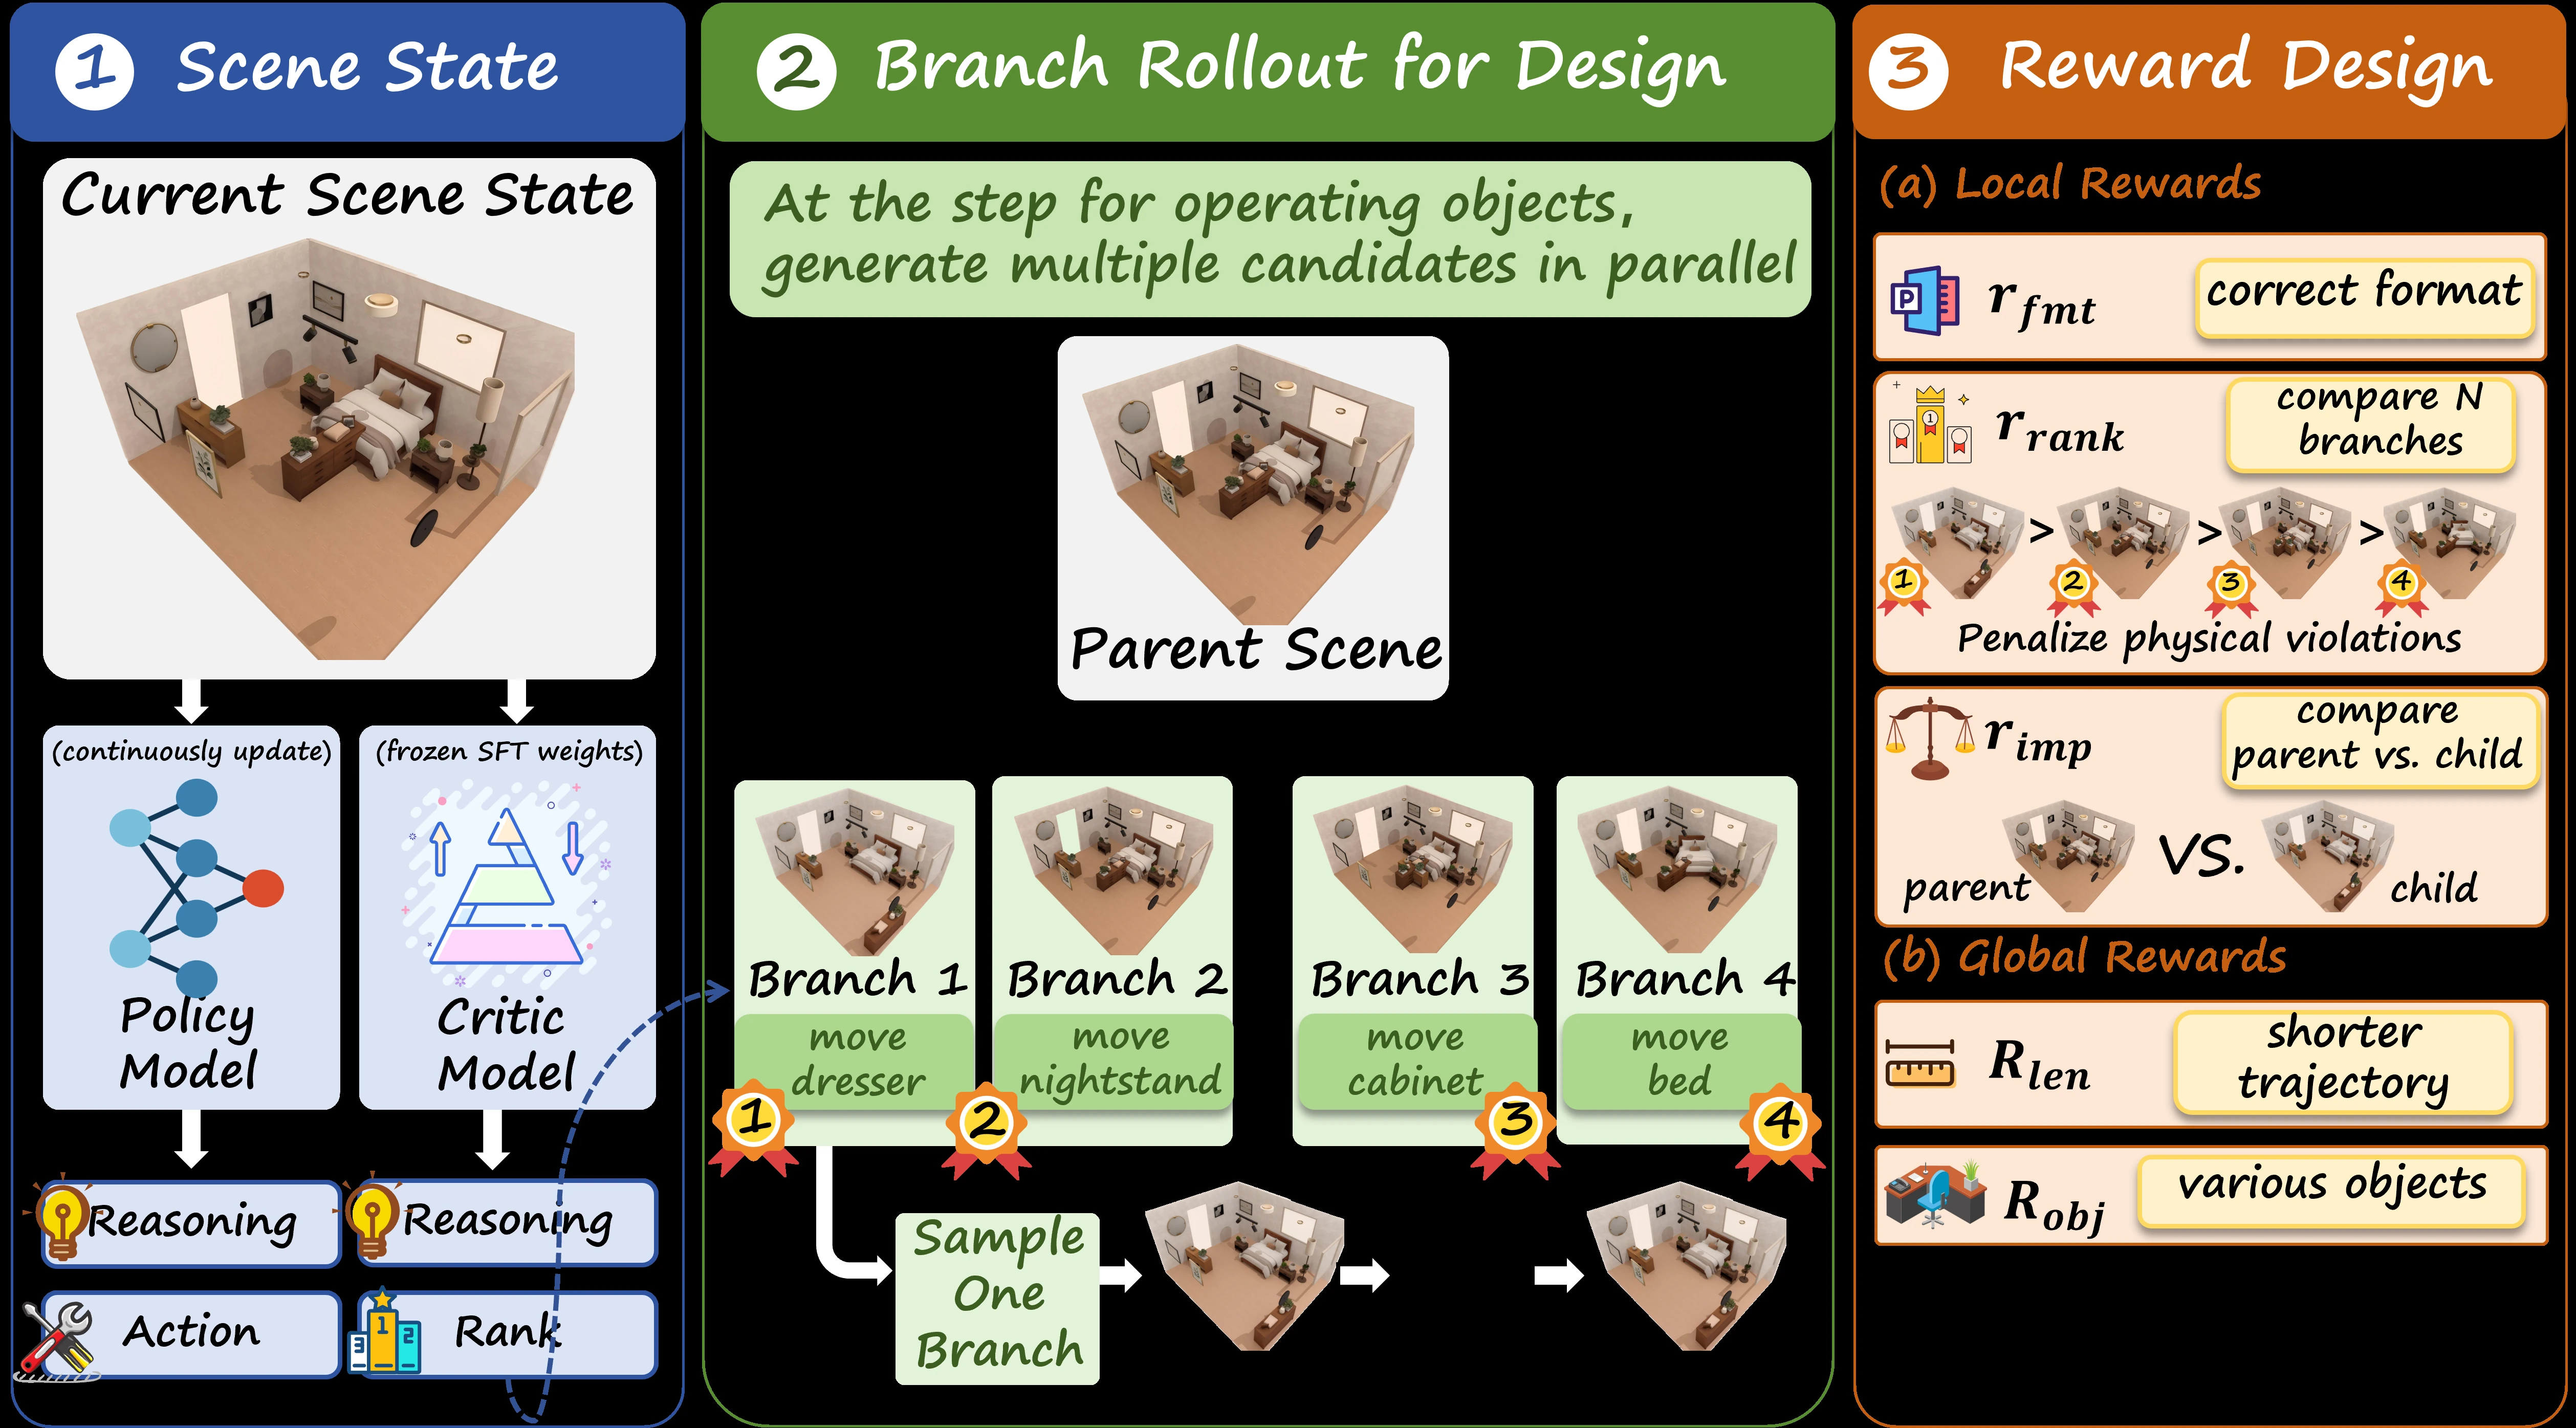
Scene-GRPO 改的是采样过程和奖励,沿用 GRPO 的策略更新目标。把这一步开始时的状态称为“父场景”,某个候选工具调用执行后的结果称为“子场景”。在一个家具编辑点,policy 基于同一父场景生成 K=4 条不同的候选输出。harness 让四条候选分别从相同的场景与记忆快照执行,再渲染四个结果;冻结的 Critic 对可渲染的子场景排序,选排名最高的一条继续构建。检查类工具调用不一定扩成四支。此外,同一个任务提示还产生 G=4 条完整轨迹,供全局奖励相互比较。论文报告每条轨迹最多 80 步,学习率 1×10⁻⁶。来源:论文 §3.2、§4、Appendix C。
| 环节 | 标准 GRPO 的骨架 | Scene-GRPO 的场景化做法 |
|---|---|---|
| 一组样本 | 同一输入的多个完成 | 同一父场景的 4 个可执行编辑分支;另以同一指令的 4 条完整轨迹算全局组 |
| 奖励 | 给每个完成一个标量 | 格式 + 候选场景排名(branch-ranking)+ 相对编辑前的改善(improvement);整条轨迹另看长度与物体数量 |
| 优势 | 组内奖励减均值、除标准差 | 局部组和完整轨迹组分别标准化,再相加;全局项广播到该轨迹中的编辑步 |
| 策略目标 | 对生成 token 做剪切更新并约束参考策略 | 沿用标准 GRPO 目标;发布代码是 token 级 clipped surrogate 加冻结参考模型的采样 KL |
3.3 奖励不是只问“这四个谁最好”
branch-ranking reward(候选排名奖励)只比较从同一父场景出发的候选结果:可渲染的 L 个子场景由 Critic 排序,奖励按名次从 1 线性降到 0;不可渲染的候选给 −0.5。improvement reward(编辑改善奖励)逐一比较每个子场景与编辑前的父场景:子场景更好给 +0.5,更差给 −0.5,不可渲染给 0。工具调用格式正确另给 +1。两个比较分别回答“几个候选中哪个好”和“这一步是否真的改好了”。来源:Appendix C.1,式 8–13。
按公式造一个教学算例,不是论文日志:四支 A、B、C、D 中前三支能渲染,Critic 排名 A > B > C,D 不能渲染;A、B 优于父场景,C 劣于父场景。四支格式均有效,则局部奖励依次为 2.5、2.0、0.5、0.5。均值为 1.375、总体标准差约 0.893,A 的局部优势约 1.26。D 的工具调用可以格式正确,却因场景不可渲染而得低分;“格式正确”不等于“设计正确”。
全局信号另看整条轨迹:长度 25 步以内给满分,45 步及以上给 0;最终物体数 25 件及以上给满分,10 件及以下给 0,中间线性插值。假设一条轨迹用 30 步、放了 20 件物体,则长度奖励 (45−30)/(45−25)=0.75,物体奖励 (20−10)/(25−10)≈0.667,合计约 1.417。它还要与同指令的另外三条轨迹相互标准化;论文最终将该全局优势加到轨迹中的每个编辑分支,权重 η=1。来源:Appendix C.2–C.3,式 14–21。
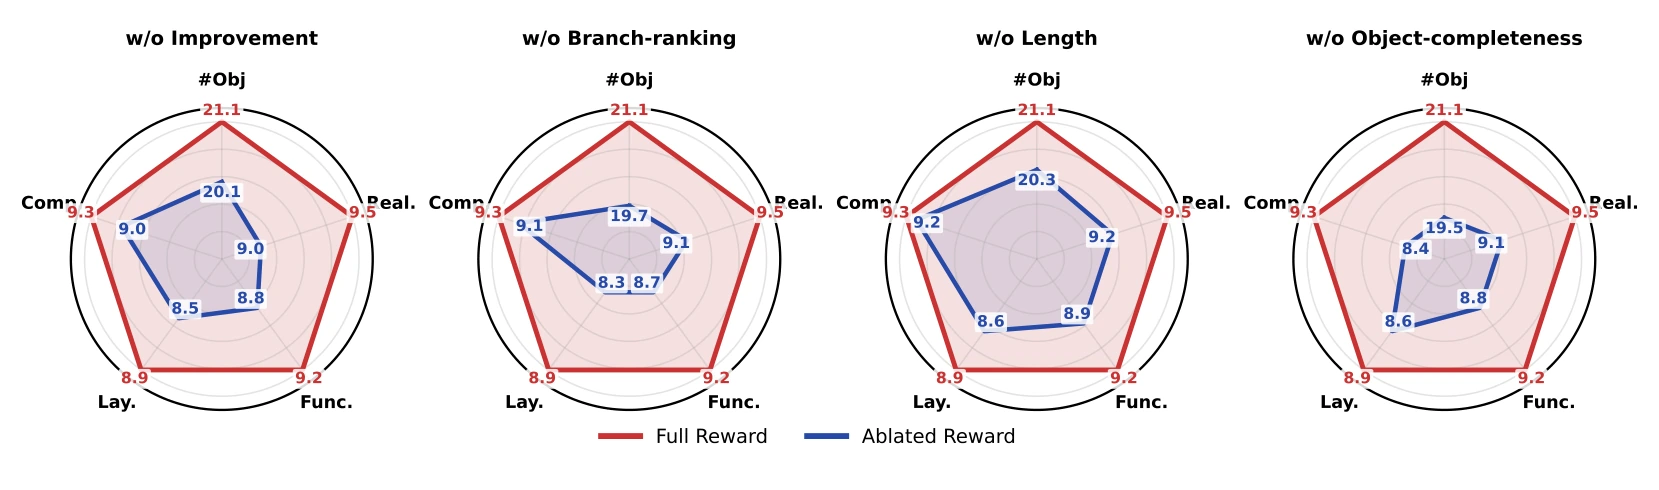
物体数只是防止太早停的代理指标,不保证每件家具都有用;长度奖励也可能鼓励草率结束,所以两项需要一起看。论文的 Figure 9 消融显示,去掉 branch-ranking reward(候选排名奖励)后,平均布局分数 8.9→8.3、物体数 21.1→19.7;去掉其它奖励也有下降,但这些是作者报告的消融,不证明每个环境都需要相同阈值。
3.4 公开实现怎样更新参数,以及论文与代码的差别
发布的 目标函数逐个完成取生成 token 的 log probability,与采样时的旧策略求概率比;剪切范围默认 ±0.2,再加对冻结参考模型的采样 KL,系数默认 0.05。训练循环把局部标准化优势与全局标准化优势相加。这里的“改 GRPO”主要发生在 rollout 和 reward 层。
复现边界要直说:论文 Appendix C 用长度 25/45、物体数 10/25;当前公开 CLI 默认却是 20/38、3/8,且 发布说明称 RL 入口只优化家具阶段,修订过 token 级目标和分支恢复,但没有重跑历史论文表格。当前代码能说明发布实现怎样工作,不能单凭它断言论文所有结果就是这些默认值跑出来的。
3.5 “写 code 用什么 harness”:SceneSmith 加自建层,场景输出是工具调用
论文 Appendix F 明说采用 SceneSmith 的场景构建 scaffold。作者并非从空白搭整套 3D 环境:SceneSmith 已有几何/资产/渲染/物理工具。Scene-Designer 的仓库另外实现了分阶段提示词与工具定义、内存快照、SceneSmith 兼容补丁、Python 场景适配器、FastAPI 工具服务、分支试跑与状态恢复、训练和推理脚本。安装说明要求另下固定版本 SceneSmith 并打补丁。
- 1 四阶段:房间平面 → 家具 → 墙面物体 → 天花板物体;各阶段换提示词和可用工具。公开版本不覆盖 SceneSmith 的可操作小物体阶段。
- 2 policy 是本地 Qwen3-VL-8B 系列模型。平面阶段读文本,视觉阶段读同一场景的俯视加南/东/西/北四张图,以及结构化记忆和工具反馈。
- 3模型输出带参数的
<tool_call>,例如移动家具或检查物理;src/tool_server.py调 SceneSmith 工具并返回更新后的场景和观察。 - 4GRPO 的每个候选先从同一个父场景快照执行;选中分支后恢复它已计算的场景和记忆,不把动作再执行一遍。代码见 branch_eval / branch_choose。
因此,若“写 code”指模型生成场景时的执行器,答案是 SceneSmith + 作者自写 Python harness,不是 Codex、Claude Code 等编程代理。GPT-5.2 主要用于生成原始轨迹、压缩时的因果判断和样本理由;它不是 Scene-Designer 推理时的本地 policy。若问题指研究者开发仓库代码时是否借助 Codex,论文和公开仓库都没有披露,不能猜。来源:论文 §3.1、Appendix F;仓库 README、USAGE、agent_rollout.py。
3.6 推理期 Critic 是额外搜索,不要算进普通单次推理
训练后的 Scene-Designer 可以直接逐步调用工具。名为 Scene-Designer w/ Critic 的变体在推理时每步又试四个候选,让 Critic 排序后继续。这给出更好的结果,同时增加模型生成、场景执行、渲染和 Critic 调用;论文未量化总时间、GPU 开销或每场景成本。不要把这组成绩归因于“训练后模型单次输出就能达到”。来源:论文 §4.1、Appendix E.2。
4. Experiments:提升在哪里,证据有多强
作者按房间类型生成场景,每种方法每类 10 个场景。物理指标为物体数、越界数和碰撞数;真实感、功能、布局、完整度由 GPT-4 各打 0–10 分。原表的数字没有置信区间,不能把小差值解释成稳健的统计优势。下面先保留 Table 1 的完整原始数字,再指出最有区分力的比较。
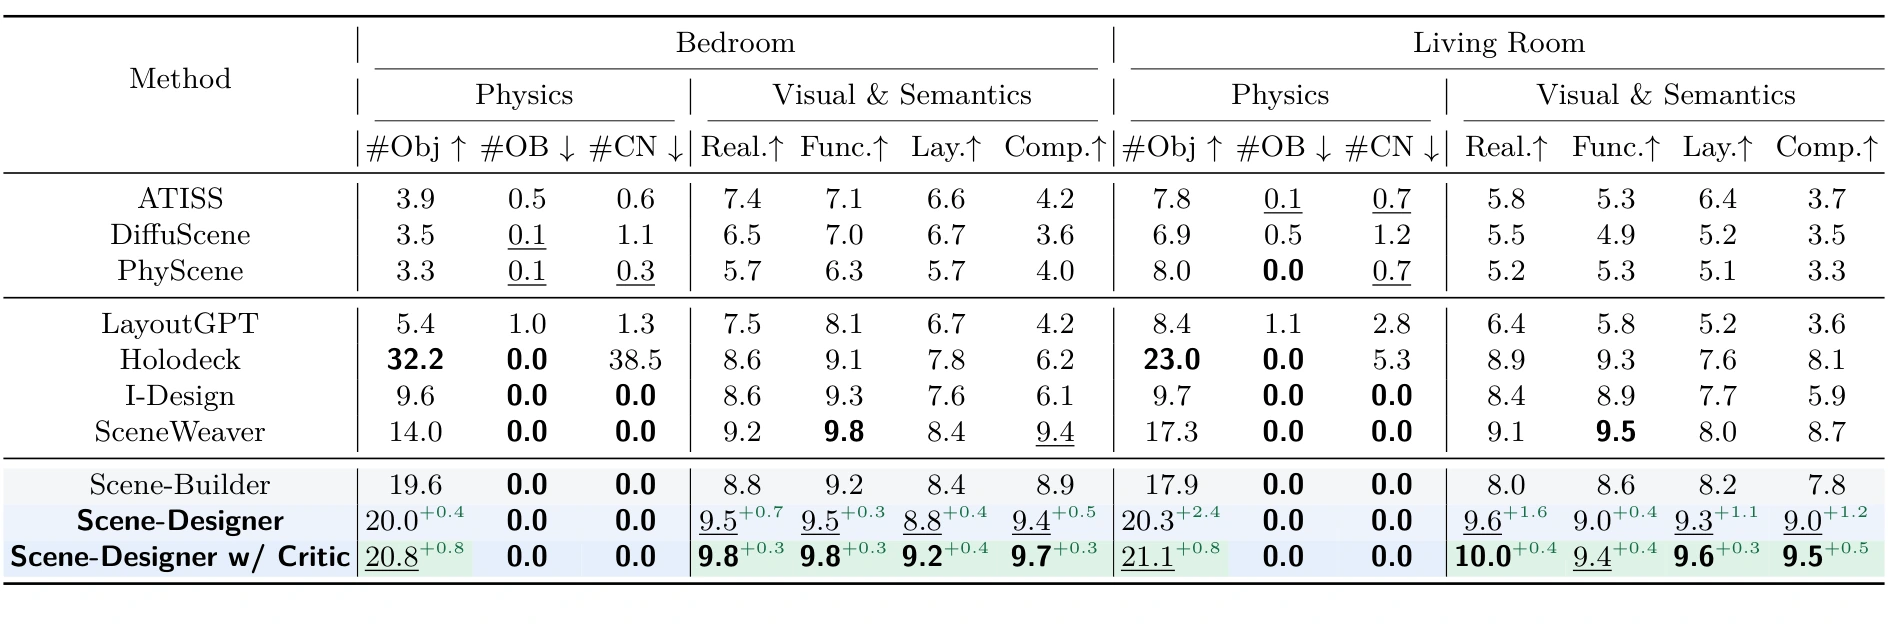
和 SFT-only Scene-Builder 比,Scene-Designer 的卧室功能 9.2→9.5、布局 8.4→8.8;客厅功能 8.6→9.0、布局 8.2→9.3。额外的推理期 Critic 把客厅功能推到 9.4、布局到 9.6。不过最近的 SceneWeaver 基线在卧室功能已有 9.8,高于不带推理 Critic 的 9.5;所以“所有指标全面胜出”并不是 Table 1 的准确读法。表 2 的浴室/办公室亦有提升,衡量方式相同。来源:论文 Table 1–2。
Critic 自身的 Scene-OTC 测试集上,联合 OTA+OTC 微调达到二图比较 89%(94 题)、四图完整排序 76%(55 题);GPT-5.2 分别为 72%、15%。作者改变图像与标签顺序五次后的平均是 90.00±2.07% 和 75.64±6.88%;这里的 ± 是五次顺序扰动的波动,不能当作跨训练种子的稳定性。来源:论文 Figure 10–11。
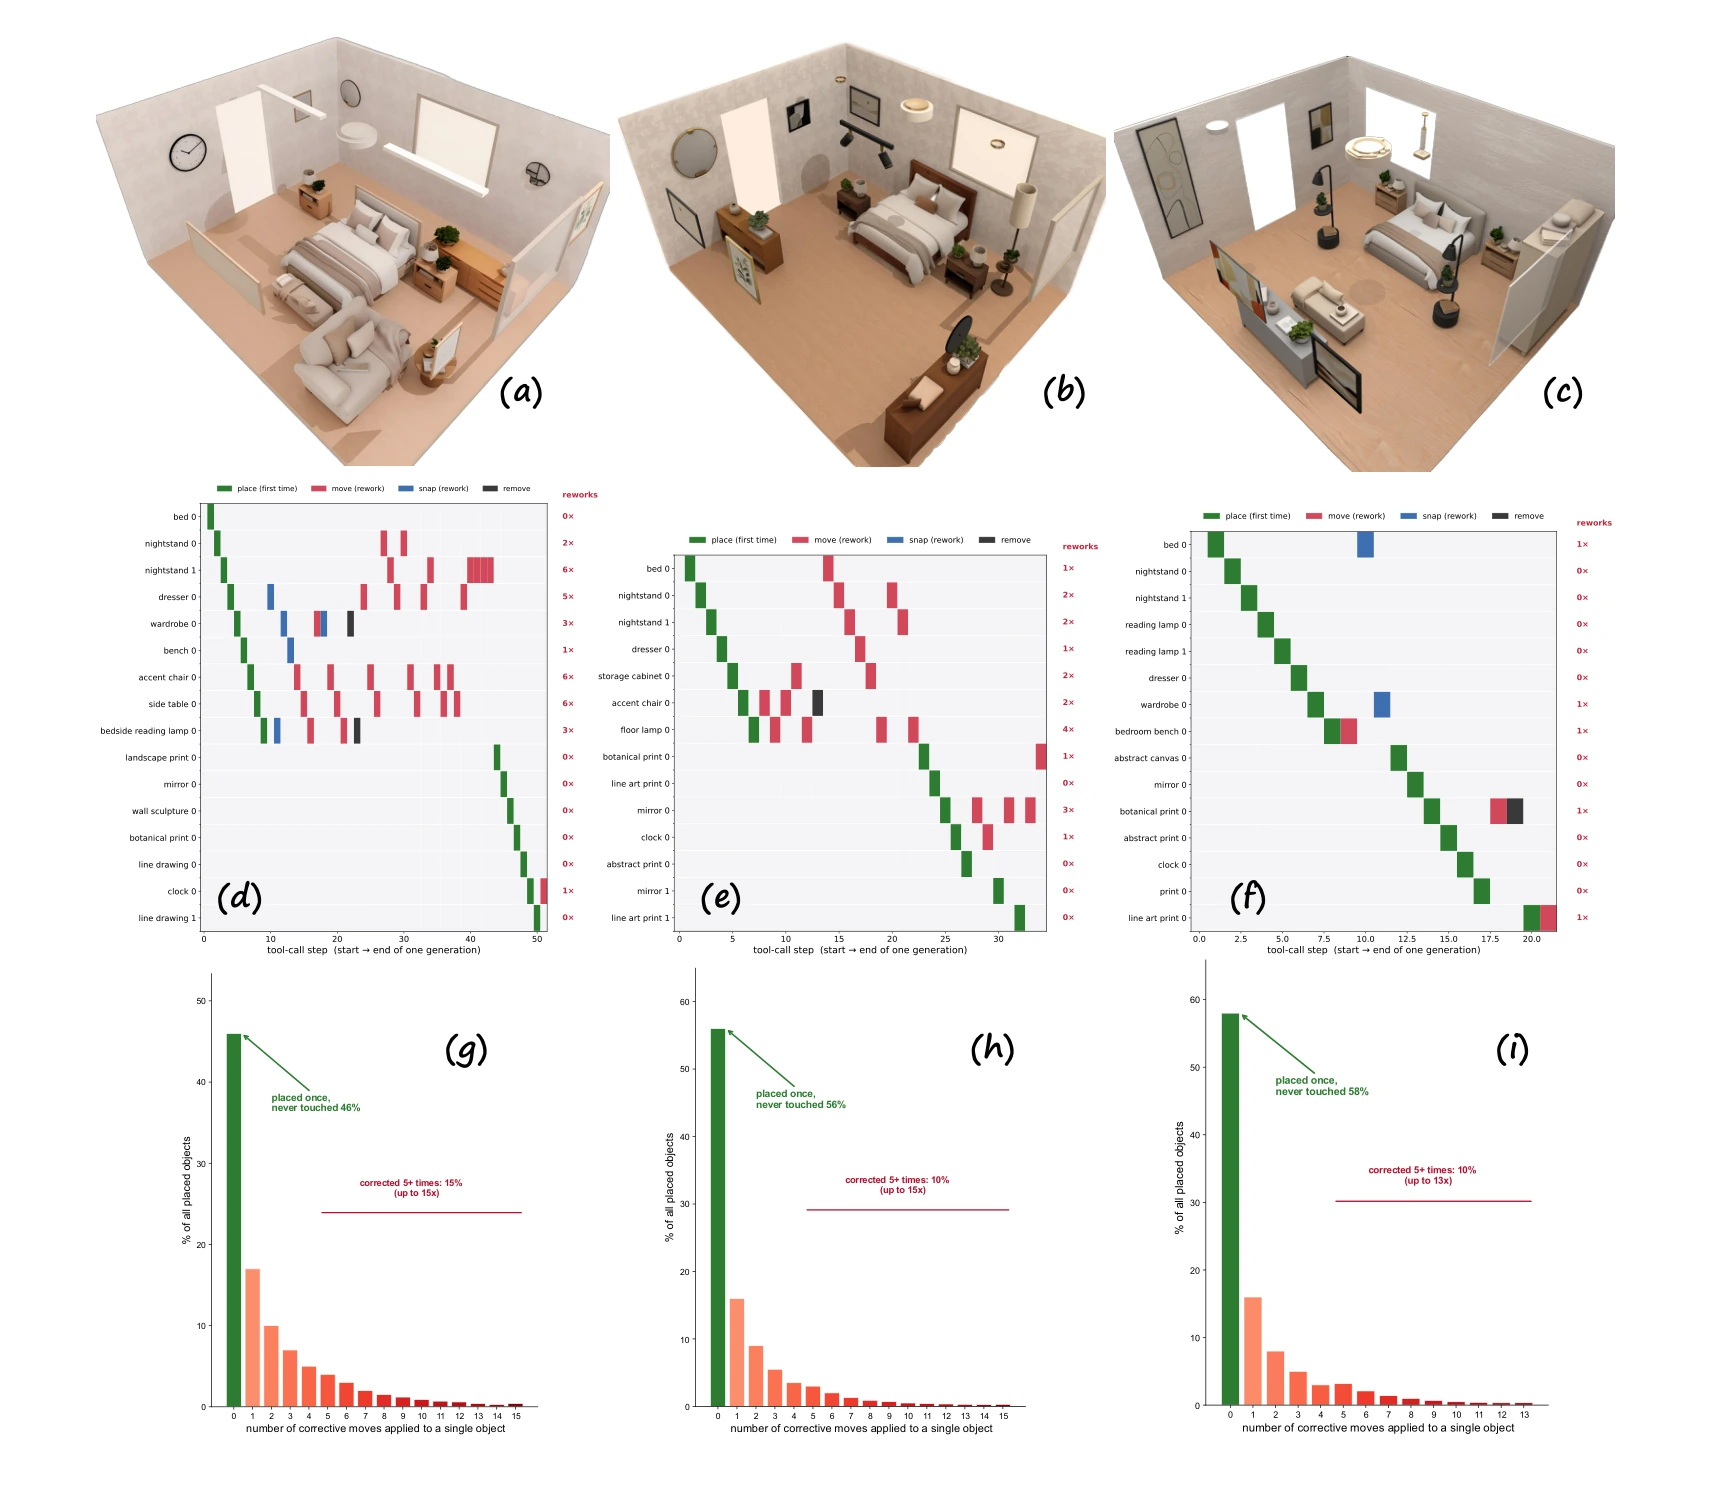
Figure 23 给出同一卧室需求的三条轨迹:Scene-Builder、RL 后 Scene-Designer、再加推理期 Critic。上排是最终场景,中排绿色为初放、红色为返工,底排是作者在 另 100 个生成场景上统计的物体编辑次数分布。这个案例帮助读者看见“少返工”的具体含义;底排的 46%→56%→58%“放一次不再改”不是这一间卧室的评分,更不能独立证明质量。
另外,论文 Figure 6 报告“某类错误需五步以上修复”的占比:窗户可达性阻挡从 21% 降到 5%,交互朝向错误从 40% 降到 7%,尺寸不匹配从 50% 降到 23%。这是相关错误类别的条件比例,而非整套任务成功率。Appendix G 的几何可达性指标为另一个证据:全可达率 FR@0.3 为 0.72→0.83→1.0(SFT→RL→RL+Critic),但样本量与不确定性没有在该表单独交代。来源:论文 Figure 6、Table 6。
5. Discussion:可以借鉴的设计,以及下一步该测什么
最值得迁移的是奖励的两个对照轴。候选之间比较能选出相对好的调用;再与编辑前的场景比较,才能发现“四个候选都让房间变差”的局面。完整轨迹奖励检验是否走得太久或太早停。这个分解适用于有可回滚状态、可执行工具和可比较中间产物的 Agent 环境。关键前提是 Critic 的排序可信,四个候选都能从同一状态公平试跑。
若要把结果外推到真实设计工作,应该补三类实验:一是独立人工设计师对功能与动线的盲评,核对 GPT-4 分数;二是固定总执行与模型调用预算,对比“多分支搜索”和“单次更强 policy”;三是在相同物体数条件下考察布局质量,排除“奖励更多物体”带来的表面提升。公开代码还需要对齐论文阈值、四阶段训练范围与历史 checkpoint,才能检验表格的可复现性。
6. Conclusion:记住方法,也记住证据边界
Scene-Designer 先从 SceneSmith 工具轨迹学习怎样造场景和改错,再从扰动比较学习怎样评场景。Scene-GRPO 在同一起点的四个候选上奖励候选之间排名靠前和执行后比编辑前更好,并用完整轨迹奖励约束步数与物体数;最终仍通过 GRPO 更新生成策略。推理时多试四支并用 Critic 选优,是另一项可选能力。
对 harness 的回答也很明确:这是依托 SceneSmith、由作者扩展的场景工具执行栈,不是 Codex 式文件编辑/终端编码 Agent。论文的“代码”主要是公开的训练和工具服务程序;生成器交付的是可执行场景工具动作及最终 3D 场景。当前仓库只公开 Scene-Builder 的 SFT 权重和部分数据/处理流程,发布说明明确没有重跑修订后的 RL 代码来复现论文表格,因此应把论文数字和现行代码默认值分开读。
取证范围:arXiv v1 全 39 页(含附录),项目官方页面、Scene-Designer 代码 commit a0565e50、SceneSmith commit e888297a。本文没有重训模型或复现 3D 场景。所用论文原图来自作者在 arXiv 以 CC BY 4.0 发布的版本;图题、英文标签和原始数值保留,按版面裁切的表格与图标明原编号。论文与发布代码不一致处分别标注。
留言