一间卧室可以物体齐全,却挡住门、阅读灯离座位太远;修复时又反复搬同一件家具。
Scene-Designer · Liu et al. · arXiv v1 / 2026-10-1601 / 10
把家具放进去,为什么还不等于“设计好房间”?
论文 §1,Figure 1–3原论文 ↗
Part 0 · 先看执行对象02 / 10
模型写的主要是工具调用,不是 Blender/Python 文件
Qwen3-VL policy 读当前场景、任务、记忆和反馈,输出 <think> 推理 + <tool_call> 工具调用;例如用 move_furniture_tool 请求移动家具。公开代码允许一次输出含多个调用;harness 执行后重新渲染。
视觉阶段的观察是 俯视 + 南/东/西/北四张图。Critic 比较的候选则是不同的场景,不能误认成五个相机角度。
公开版本四阶段;SceneSmith 原框架的 manipuland 阶段未包含在本 release。
论文 Appendix F;官方 USAGE.md “Observation contract”正文:harness ↗
Method · SFT 先于 RL03 / 10
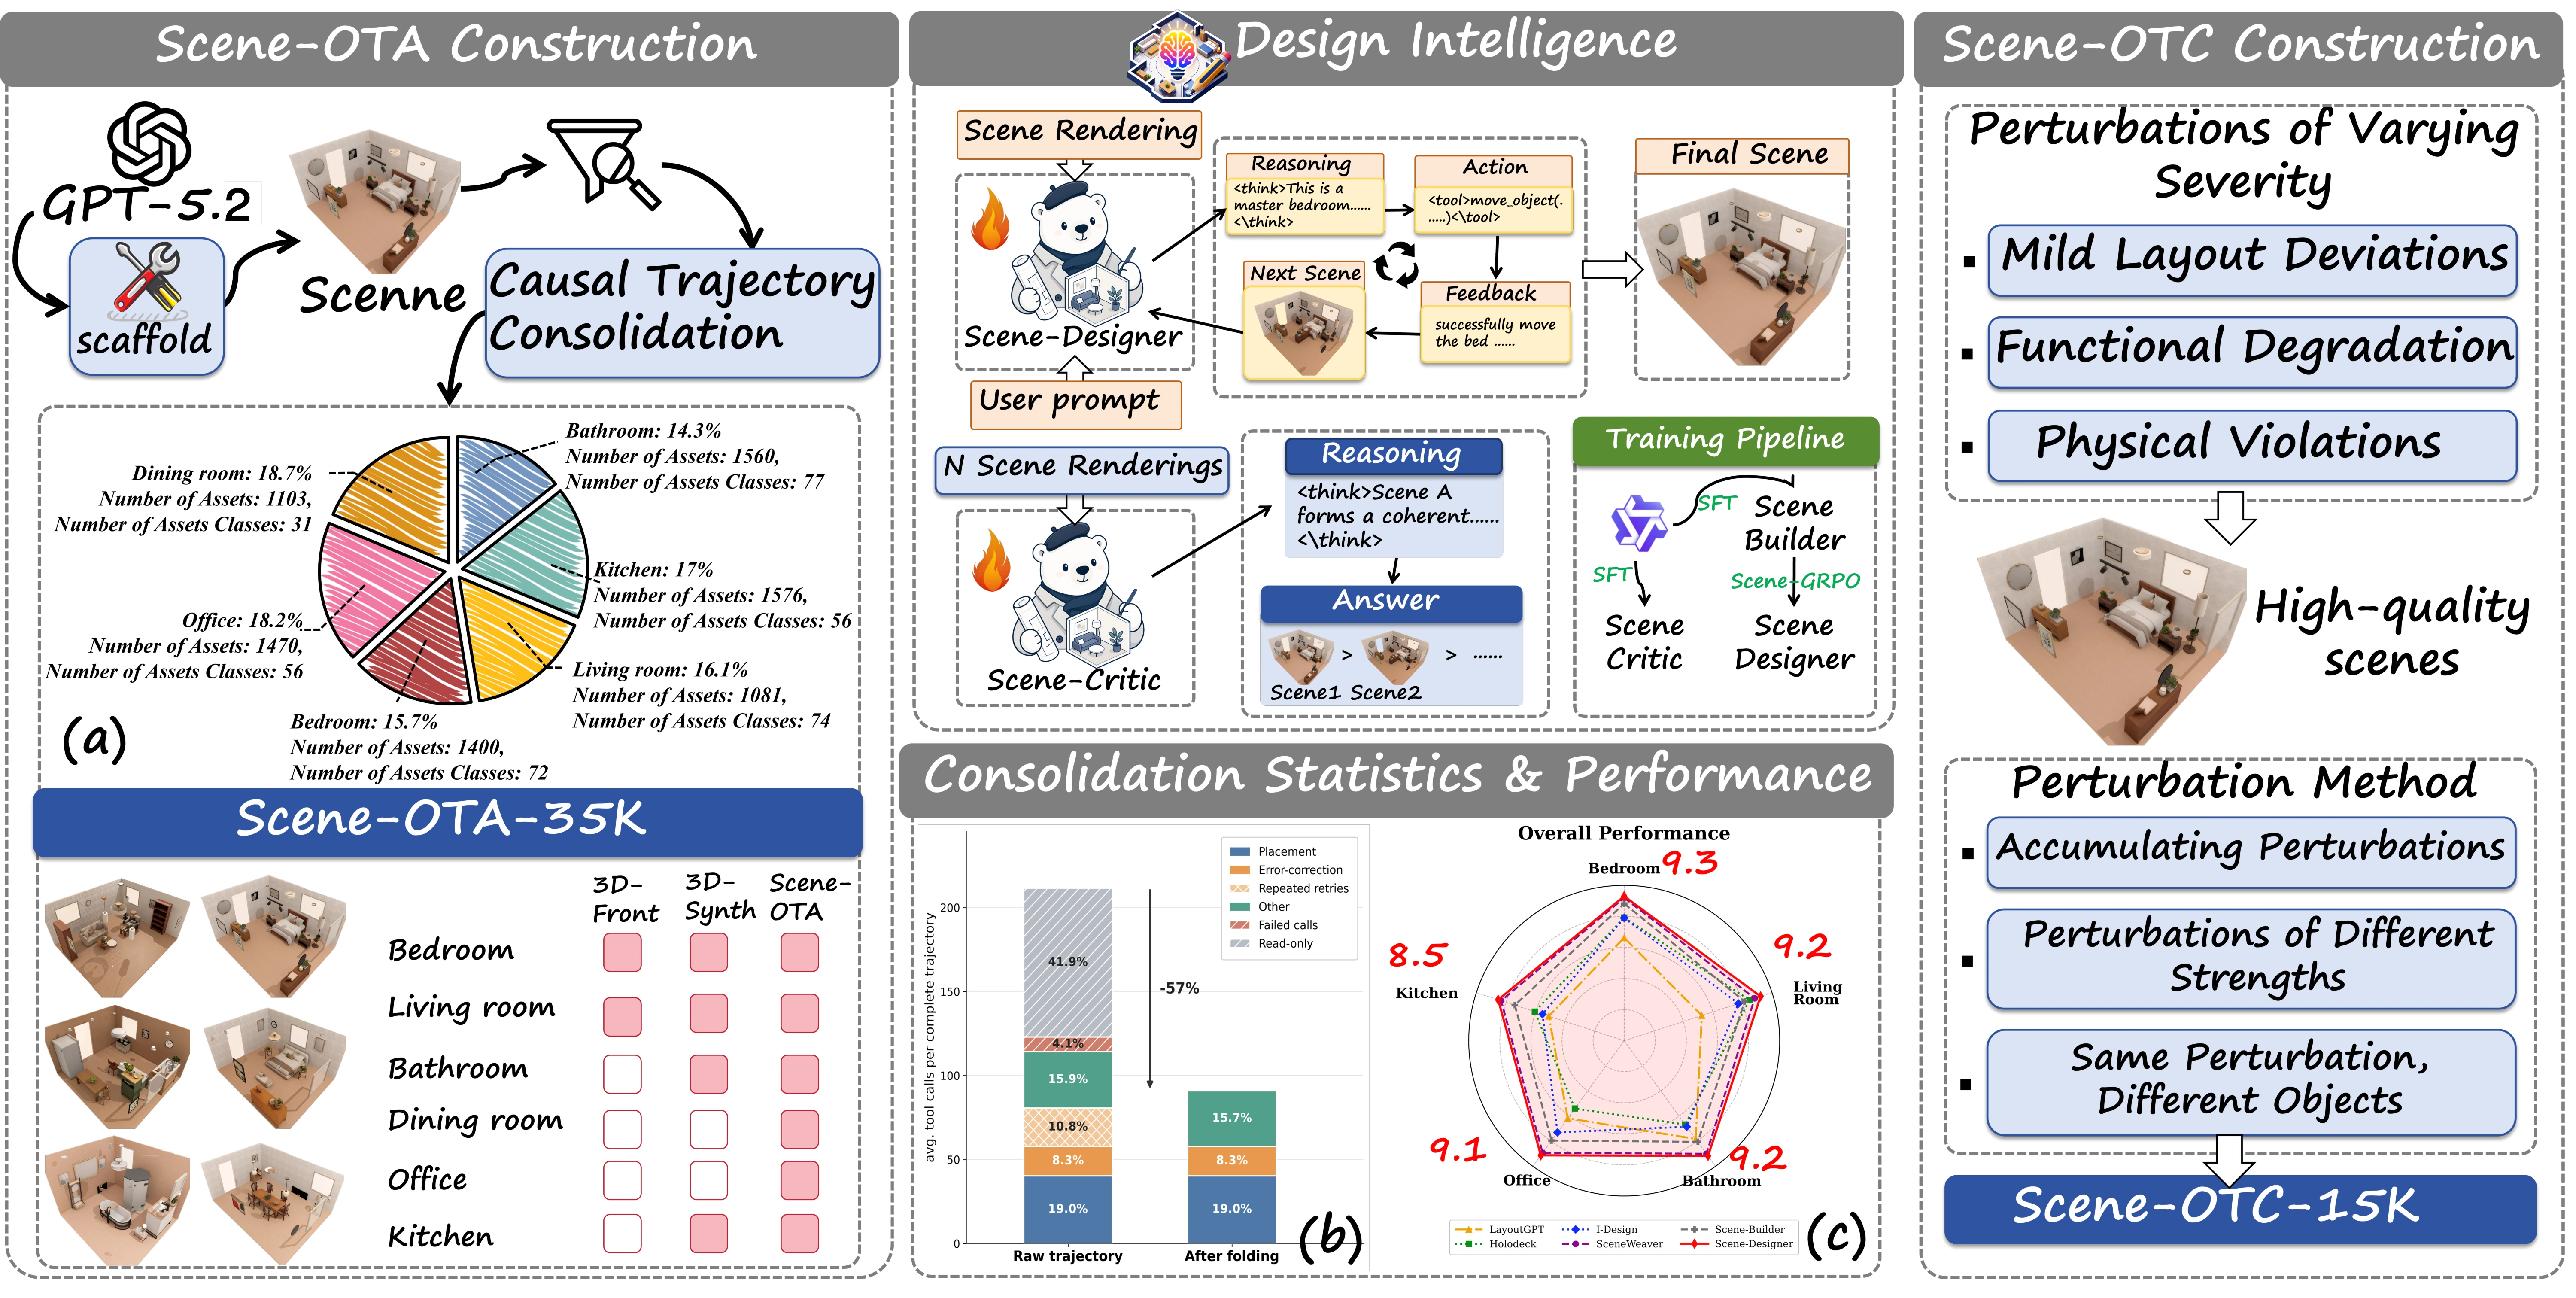
35K 步学编辑,15K 组学评价
论文 §3.1、Appendix D.2–D.3 · Liu et al.原论文 ↗
Method · 用户的核心问题04 / 10
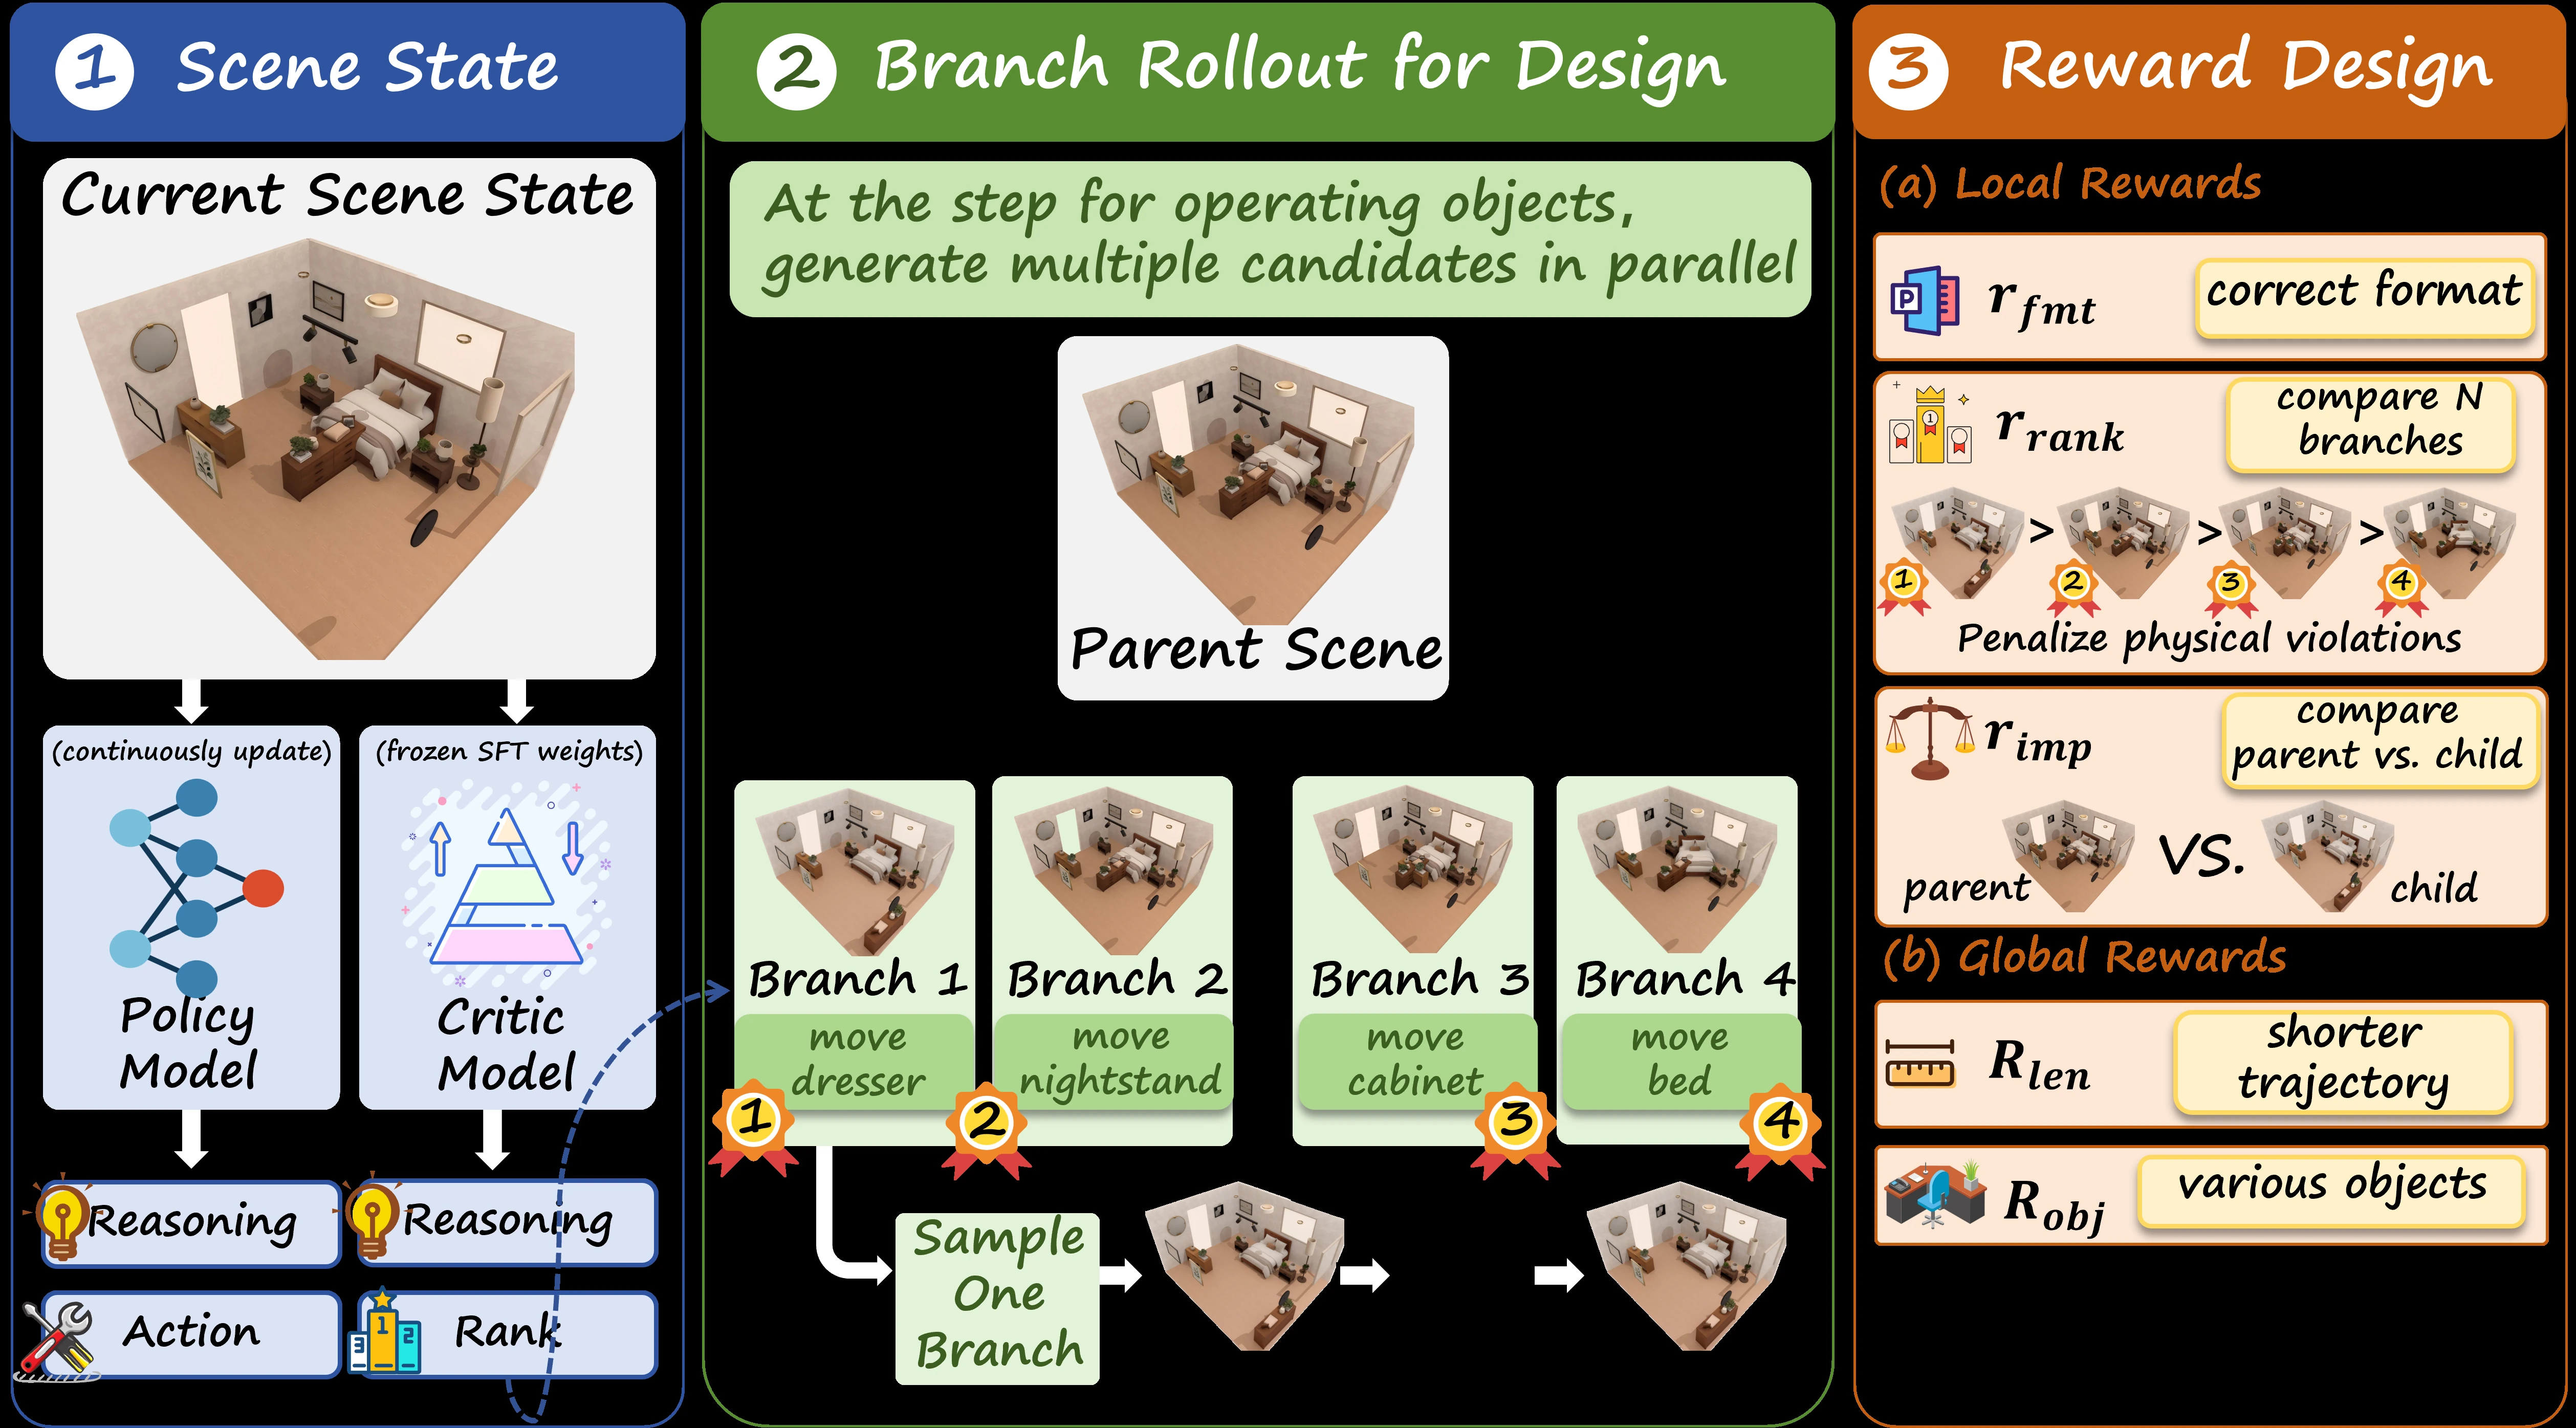
Scene-GRPO 改 rollout 与奖励,沿用 GRPO 更新目标
| 环节 | 普通 GRPO 骨架 | Scene-GRPO |
|---|---|---|
| 一组样本 | 同一输入的多个回答 | 同一编辑前场景、同一步的 4 条候选输出 |
| 奖励 | 每个回答一个分数 | 格式 + branch-ranking reward(候选排名)+ improvement reward(编辑前后改善);整条轨迹再看步数和物体数 |
| 优势 | 组内标准化 | 局部 4 支、同指令 4 条完整轨迹分别标准化,再相加 |
| 参数更新 | 剪切的策略目标 + 参考约束 | 仍是 GRPO;公开代码做完成 token 级 clipping 和采样 KL |
两个不同的“4”:K=4 是同一编辑前场景试出的候选结果,G=4 是同一任务指令下的完整轨迹。
论文 §3.2、Appendix C;代码 src/grpo_objective.py正文与公式 ↗
Method · 一次编辑迭代05 / 10
四个候选从同一编辑前场景试跑,再选一个继续
论文 Figure 5;公开代码 grpo_rollout.py、tool_server.py分支代码 ↗
Method · Appendix C.1 · 教学算例06 / 10
先排候选名次,再比较编辑前后
此表按论文公式自造,不是观测到的模型轨迹。均值 1.375,总体标准差约 0.893,因此 A 的局部优势约 (2.5−1.375)/0.893 = 1.26。
论文 Appendix C.1、C.3,式 8–13、17–18完整推导 ↗
Method · Appendix C.2–C.307 / 10
整条轨迹要短,也不能靠空房间骗分
长度奖励 R_len
25 步及以下给 1;45 步及以上给 0;中间线性插值。
物体奖励 R_obj
25 件及以上给 1;10 件及以下给 0;中间线性插值。
示例:30 步、20 件物体 → 0.75 + 0.667 = 1.417。同一指令的四条轨迹再相互标准化,得到全局优势。
全局优势会广播到该轨迹的编辑步;物体数只是防止过早停止的代理,不代表家具越多越好。
论文 Appendix C.2–C.3,式 14–21论文公式 ↗
Training ≠ Inference08 / 10
训练 Critic 打奖励;推理 Critic 是可选的额外搜索
Scene-Designer
Scene-Builder 经 RL 后得到 policy。普通推理按场景观察逐步输出工具动作。
Scene-Designer w/ Critic
推理时每步再采样四支,Critic 排序并选一支继续;结果通常更好,调用也更多。
每类房间每方法 10 个场景;小差值未附置信区间。不能把“w/ Critic”成绩说成普通单次推理成绩。
论文 Table 1–2、§4.1正文原表 ↗
Implementation · 固定代码版本 a0565e5009 / 10
SceneSmith 是底座,作者做上层编排;没看到 Codex 执行器
生成场景时:是 SceneSmith + 自建 Python 适配,不是 Codex/Claude Code 类的文件编辑 Agent。
研究者写仓库代码时:公开论文和仓库未披露使用何种编码助手,不能推断。
发布版 RL 只优化家具阶段;SFT 和推理支持四阶段。作者给出 FastAPI 工具服务和 SceneSmith 兼容补丁。
论文 Appendix F;README、USAGE、Designer/、src/tool_server.py官方代码 ↗
Results · 把结论放回实验条件10 / 10
奖励分解有效,但复现和成本仍有缺口
解释边界
卧室 SceneWeaver 功能分数 9.8,高于无推理 Critic 的 9.5;不能说每项都领先。
代码边界
论文奖励阈值与发布 CLI 默认不同;作者说明修订 RL 代码后未重跑历史表格。
下一步应报告推理成本、用独立人工设计师核对评分,并公开与论文配置一致的完整训练材料。
论文 Figure 6、9、10,Table 1–2;官方 USAGE.md / VALIDATION.md返回正文 ↗