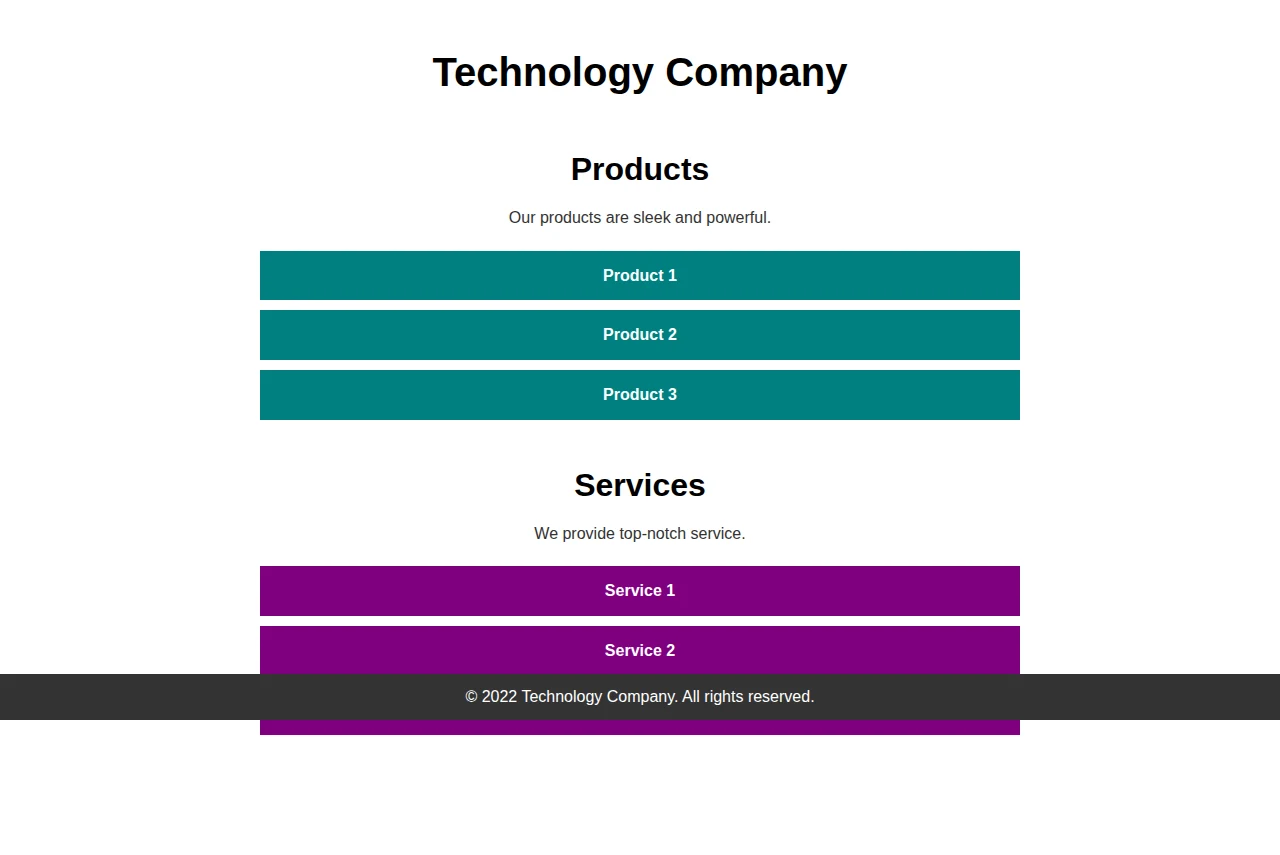
给模型一张网页截图,要它写出能还原页面的 HTML。代码里有第三个服务按钮,截图里却被页脚盖住了。PrismaCoder 关心的是这类“程序能运行,但结果不对”的问题:如何批量造出涵盖网页、图表、SVG、化学结构等格式的训练样本,并用同一套可细分的检查办法筛选数据、给强化学习打分。下文沿着一个样本从来源到训练的路径,核对“是否蒸馏了大模型”。
1. Motivation:代码能运行,画面仍可能错
可执行性只是第一关。绘图脚本可能画错刻度,SVG 能打开但图形错位,网页 DOM 有按钮而截图把按钮遮住。单一“整体相似度”难以说明错在哪里;为所有领域手写统一规则,又覆盖不了每道题的具体要求。论文的目标是让检查项随指令变化,同时区分代码证据与视觉证据。来源:论文 §1、§3.1、Figure 3。
这种任务也说明“多模态代码”与传统文本代码补全的差别:输入可以是文字或截图,输出是可执行程序,最终质量还取决于浏览器、绘图库或编译器产生的可见结果。论文 Figure 1 展示的格式范围很广;实际训练集各类任务数量见 Table 1,不能把它理解为单一网页数据集。
2. Related Work:与已有视觉代码数据和固定判分的边界
新意主要在跨格式的数据筛选与奖励复用。JanusCoder、VisCoder2、VinciCoder 等已经覆盖部分视觉代码任务;PrismaCoder 收入更多格式,并让每条指令有自己的代码检查和图像检查。公开代码或论文中的“固定 verifier”适合某一格式的确定性规则,但网页视觉质量、图表布局等还要看渲染结果。论文 Appendix B Table 5 给出各工作的格式覆盖;覆盖广不等于每个格式都领先,也不表示数据来源全为新创。
3. Method:一条训练样本怎样被造出来
3.1 先找种子,再把代码变成能独立运行的候选
作者从绘图数据集、GitHub 绘图脚本、arXiv 论文图片、WebCode2M / MCD 网页、PubChem 化学结构和 3Blue1Brown 的 Manim 视频代码等收集种子。这里的 seed 是后续改写任务的来源材料,不等于最终入选的训练样本。长绘图脚本和 Manim 文件由 AST 解析成“一张图”或“一个 Scene”对应的自包含代码单元,保留依赖的导入与语句,去掉源仓库私有辅助函数。来源:论文 §4.1、Appendix A.1、Table 4。
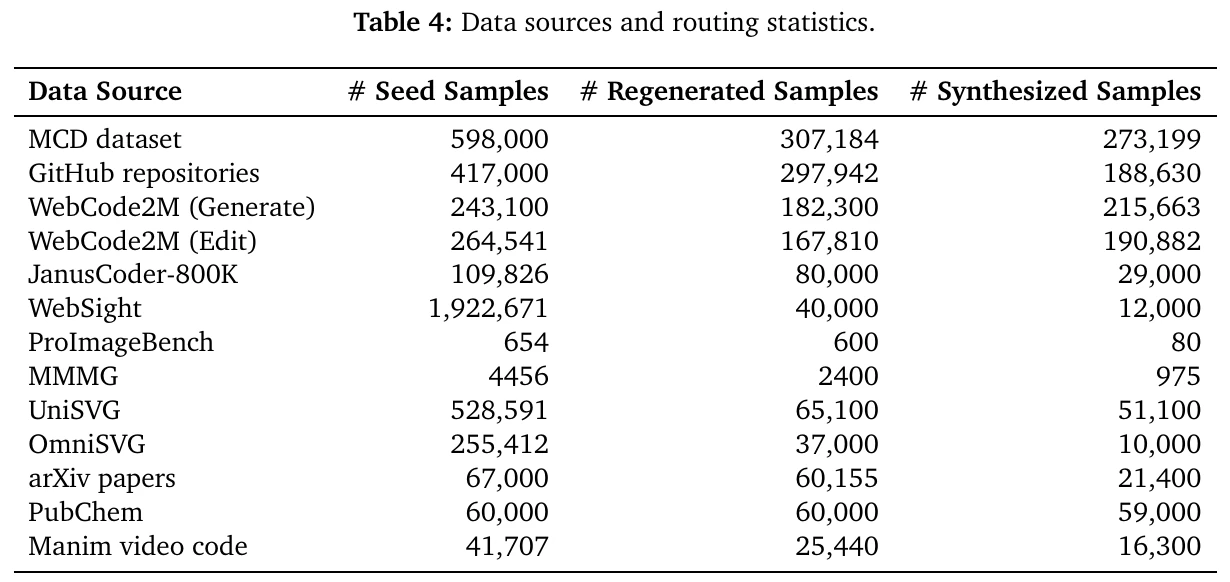
例如 Table 4 的 GitHub 行是 417,000 个种子、297,942 个 regenerated、188,630 个 synthesized;WebSight 虽有 1,922,671 个种子,后两列只有 40,000 和 12,000。这些数说明不同来源经过不同强度的再处理,不能推断“所有 GitHub 样本最终都保留”,也不能把三列求和当教师生成比例。最终 SFT 的任务分布中,WebUI Generation 约 357.1K(17.8%),Chart-to-Code 约 196.5K(9.8%);总量约 2M。来源:Table 1、Table 4。
3.2 Claude 补代码,执行器把失败样本挡在评分前
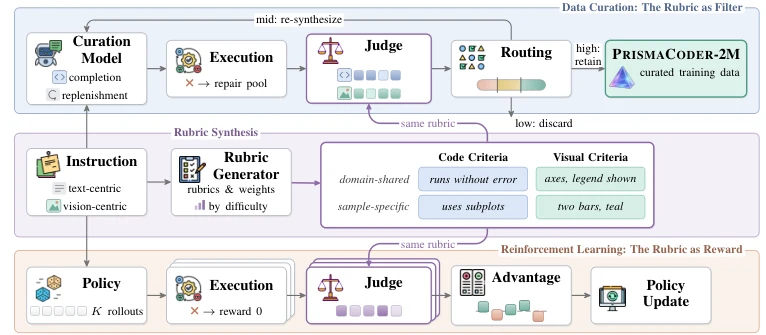
种子若没有可用代码,作者让代码整理模型补全或再生成;论文 §5.1 指定这个 curation model 为 Claude Opus 4.6。候选随后进入按格式区分的执行器:Python 必须保存图,HTML 在无头浏览器里截图,SVG、LaTeX、Mermaid、Manim 等调用相应渲染或编译程序,化学结构要能解析成有效分子。错误、超时或空产物会失败,仍修不好的候选进入 repair pool。执行成功只表示有产物,不能保证产物符合任务。来源:§4.2、§5.1、Appendix A.2。
3.3 逐题 rubric 怎么造,怎么把低分样本送回去
作者先按任务难度决定检查项数量,再让 rubric generator 为当前指令写两套带权重的是非题:一套从代码检查结构与内容,一套从渲染图检查布局和可读性;每套又含领域通用项与当前题特有项。论文 §5.1 指定 Gemini 3 Pro 生成这些标准,Gemini 3 Flash 作为独立的 judge 逐项判分。Appendix C 的成本说明有一句“Gemini-3-Flash for rubrics”,与 §5.1 的生成器型号写法不一致;本文按 §5.1 区分角色,并保留这处文内歧义。
低于下阈值的候选丢弃;中段候选带着失败的检查项反馈再次合成;高分候选保留,也可当新样本的种子。每次新生成的代码重新经过执行与评分。最终是否进入 SFT 还要满足该领域自己的阈值。论文没有给出所有阈值的可直接复现配置,也未披露最后 2M 中各来源、各教师模型输出的精确交叉比例。来源:§3.1、§4.2、Appendix C。
3.4 一次实际判分:代码全对,页脚盖住按钮
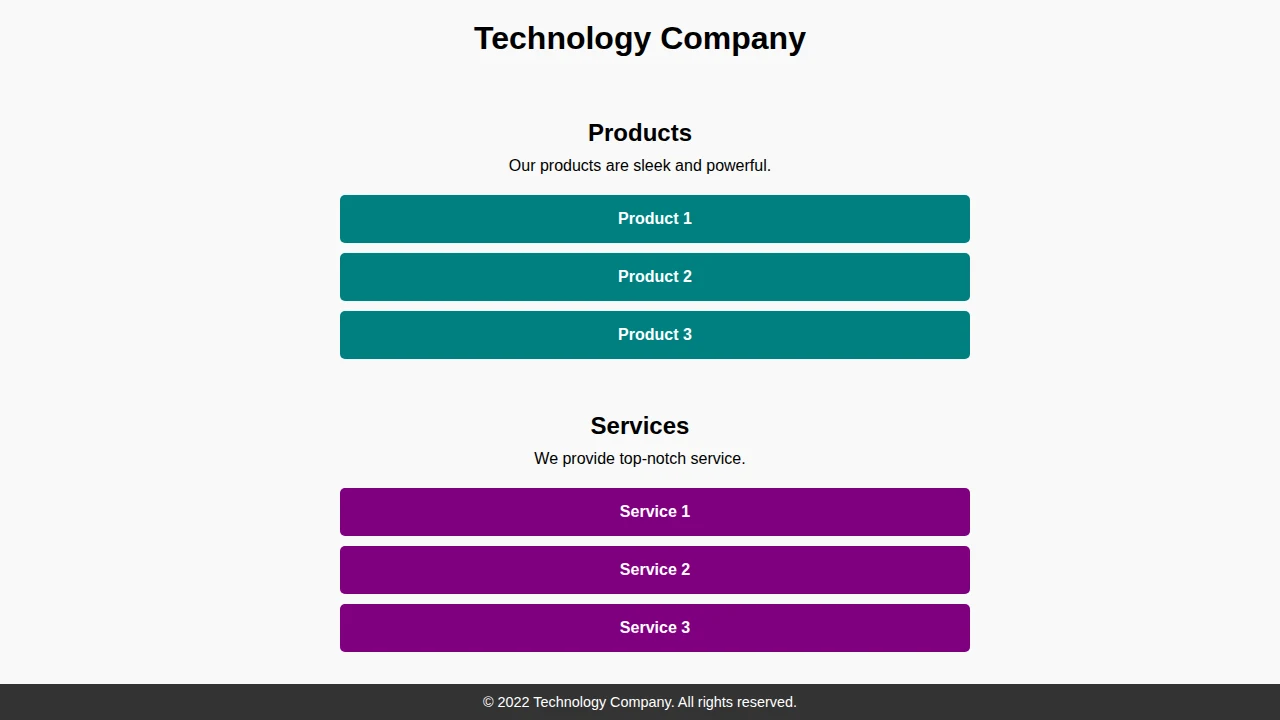
论文 Figure 3 的任务是参照网页截图生成页面。候选 HTML 含要求的产品区、服务区、颜色和版权文字,因此代码 rubric 的 5 项全过,得 1.00;渲染出来后,页脚悬在服务区中间,遮住第三个服务按钮,按钮形状也错了。视觉 rubric 的 5 项只过“水平居中”一项:0.8 ÷ (1.0 + 0.8 + 0.9 + 0.9 + 0.8) = 0.182。一个整体判分器仍给 78/100。逐项结果见 Appendix C Table 6;0.182 是视觉分,不能冒充这条样本的最终加权总分。
3.5 到底有没有蒸馏某个模型
有教师生成答案供学生模仿的成分,不能把整个训练概括成“蒸馏 Claude”。Claude Opus 4.6 负责部分代码的补全、重生成和扩增;保留下来的指令与代码进入 SFT,学生从 Qwen3.5-9B / Qwen3.5-35B-A3B 初始化并做全参数训练。因此若“蒸馏”泛指用强模型造监督答案,答案是有。若特指以教师概率分布为目标的 logits/KL 蒸馏,论文没有报告这种损失。也不能说全部 2M 条都是 Claude 输出:原始公开代码、不同来源的再生成样本和新合成样本混在一起,论文没有给出最终 Claude 占比。
Gemini 3 Pro 是造评分标准的模型,Gemini 3 Flash 是判分模型。后者给 SFT 数据做筛选,还在 RL 阶段给模型新生成的答案打奖励;它不等同于“把 Gemini 的代码答案蒸馏给学生”。判分器对最终能力的影响仍值得实验隔离,论文目前没有这样的教师来源分解。来源:§4.2、§5.1、Appendix F。
3.6 SFT 之后的 RL:同一张 rubric 换成奖励
作者对 Python、HTML、SVG 各预留 20K 条中高难度指令,SFT 不看这些题。SFT 模型先对每题试 5 个答案;每个答案按 rubric 打分后,作者以五个分数的方差挑每领域前 5K 题。它挑的是“有时会、有时不会”的题,而非最高分题。正式 RL 时每题采样 8 个回答:从回答抽代码,执行并渲染,按代码和视觉 rubric 求 0–1 奖励,组内减均值、除标准差得到优势,再用 GRPO 更新;MoE 模型使用 GSPO 与 Rollout Routing Replay。无代码、执行失败或判分失败且重试后仍无法评分的回答得 0。来源:§3.2、§4.3、Appendix D、F。
论文 Appendix F 报告 SFT 训练 5 epoch,RL 训练 1 epoch;32 张 H200,ms-swift 的 Megatron 后端,rollout 由 vLLM 生成。这里的执行器是按语言调用渲染器和评分插件的训练环境,没有披露 Codex/Claude Code 式的多轮文件编辑 harness;数据类型里也没有 PPTX。公开仓库的 RL toolkit 当前只覆盖 text-only Python/SVG/HTML verifier,完整 PrismaForge 合成筛选及 SFT/RL 训练脚本仍列为后续发布,不能按论文描述直接复跑完整流程。来源:Appendix A、D、F;官方仓库 README(固定 commit 666ab0c)。
4. Experiments:哪些数字支持这套方法
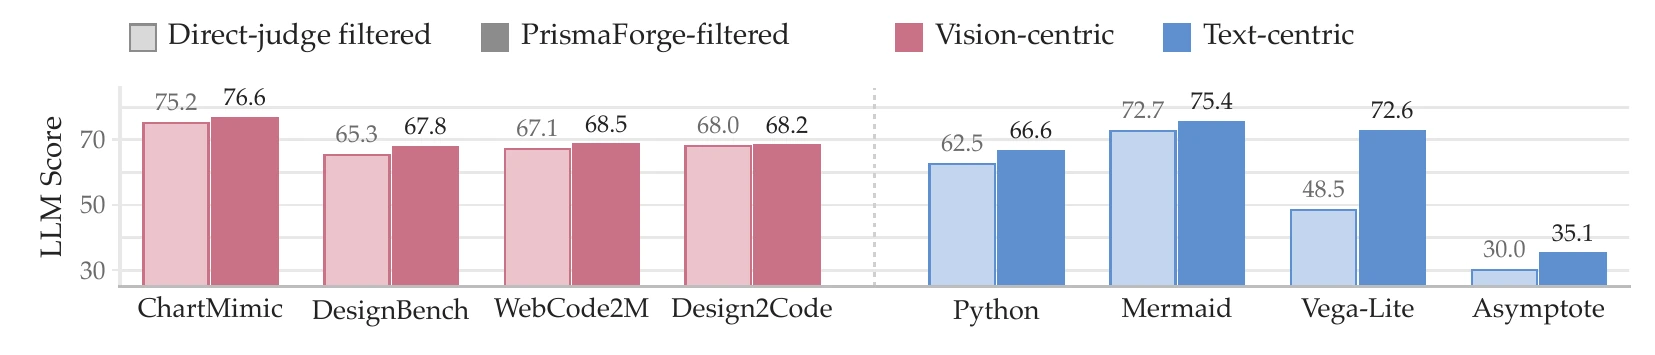
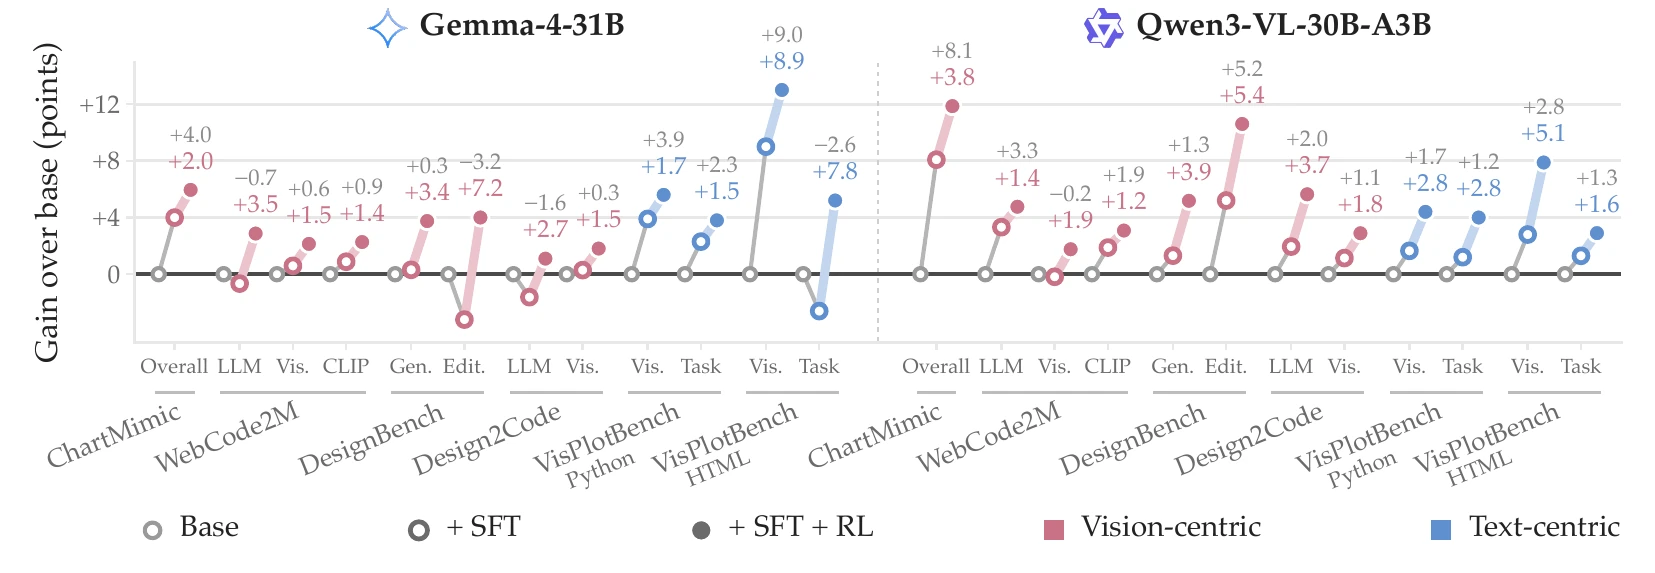
多项结果较强,但各实验支持的结论不同。在 ChartMimic Low-Level,9B 模型从 Qwen3.5-9B 基座的 58.35 提升到 81.57;High-Level 从 55.55 到 73.82(论文 Table 2)。Figure 5 的等量训练数据对照,是“用逐项 rubric 筛 SFT 数据”与“整体分数筛 SFT 数据”的比较;它显示所有列有提升、Vega-Lite 最大约 24 点,但不能单独证明 RL 奖励也优于直接打分。Figure 6 对 Gemma-4 和 Qwen3-VL 的迁移实验支持跨基座有效;Appendix H Table 19 里 Gemma 的 HTML Task 在 GPT-5.5 judge 下却是 SFT 77.8 高于 RL 75.4,不能写成任何 judge 下每项 RL 都更好。
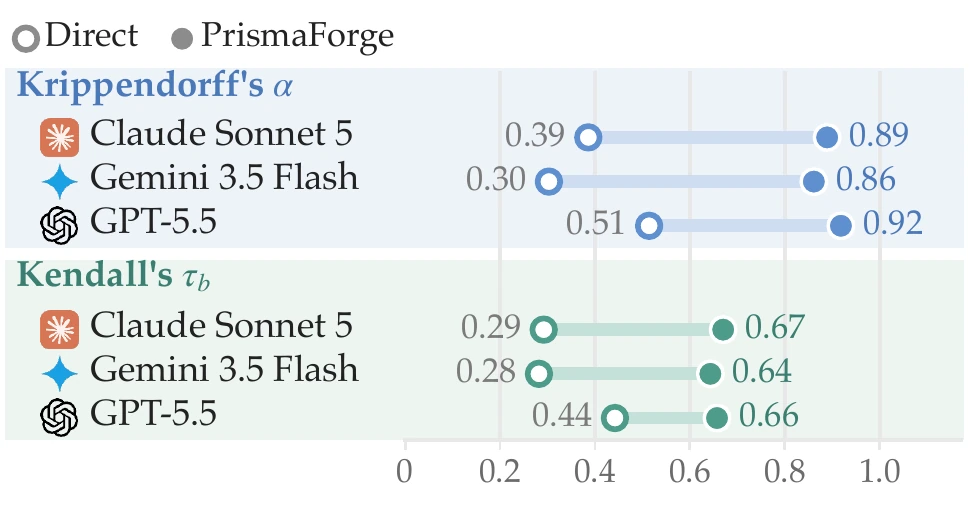
在人工一致性实验中,100 个 SFT 样本由 20 名标注者评价,三种模型判分器与人类评分的 Krippendorff α 从整体打分的 0.303–0.514,提高到 rubric 打分的 0.861–0.918;排序一致性 Kendall τb 也从 0.282–0.442 到 0.643–0.670。不同模式下每名标注者看的样本不完全相同,实验比较的是两种判分方式与相应人类评分的一致性,不是给出了实际训练收益的因果证明。来源:§6.3、Appendix H.2、Table 20。
5. Discussion:最值得补做的实验
应把教师答案、筛选器和 RL 奖励的贡献分开量。最直接的对照是固定相同种子、训练样本数与计算量,报告原始代码、Claude 重生成代码、Claude 扩增代码各占最终集多少;再分别拿掉 Claude 生成、逐项筛选和 rubric 奖励。这样才能回答“能力来自强教师代码,还是来自筛选与 RL”。当前 Figure 5 只隔离了 SFT 过滤方式。Appendix D 说明完整 GRPO 的 rubric 与直接打分对照因约 808K 次判分请求未做,仅 Python plotting 局部实验报告 ChartMimic +6.91 点;逐项判分的 API 成本约为只看视觉整体打分的两倍,网页任务还更贵。
另外,论文只用长 n-gram 指令重叠做去污染(Appendix A.3),不足以排除视觉上相似、文字不同的公开网页或图表。独立 judge、人工评审和完整数据来源账本都能增强结论。数据页与训练脚本的发布进度也需要继续核对:论文描述的是完整 2M 流程;页面当前展示的可下载行数与完整规模之间有差距,仓库 README 仍把完整管线列为待公开。
6. Conclusion:如何给这篇论文下准确判断
PrismaCoder 的方法主线是“种子 → 候选代码 → 执行产物 → 逐题分项判分 → SFT / RL”。它把代码里“写了什么”和最终图像里“看到了什么”分开检查,再把同一标准用于数据过滤和 RL 奖励。Claude Opus 4.6 的确参与了监督答案生成,所以宽义上存在蒸馏成分;论文没有证明学生单靠 rubric 就获得能力,也没有给出 Claude 生成比例或 logits 蒸馏。想复现时,还须等待完整合成与训练代码发布,并单独验证数据来源和判分器带来的偏差。
取证范围:arXiv:2610.20538v1 全 38 页(含 Appendix A–I)、官方项目页、GitHub commit 666ab0cfb49ad3508e4e5575e29960dada090724 和官方数据页。本文未重训模型。论文原图按作者在 arXiv 标注的 CC BY 4.0 许可引用;局部裁切仅用于 Table 4 页边,原英文、数值和编号保留。
留言