GAMELOGICBENCH · PAPER WALKTHROUGH

游戏最后没出错,
不代表中途没违规则

从 Godot 的 scene tree 与 physics tick 开始,理解 72 个 gameplay-logic 任务怎样被构建、校准和逐帧验收。

72Godot 任务
403手工 scenario
1,451test case
52.78%最佳单次结果
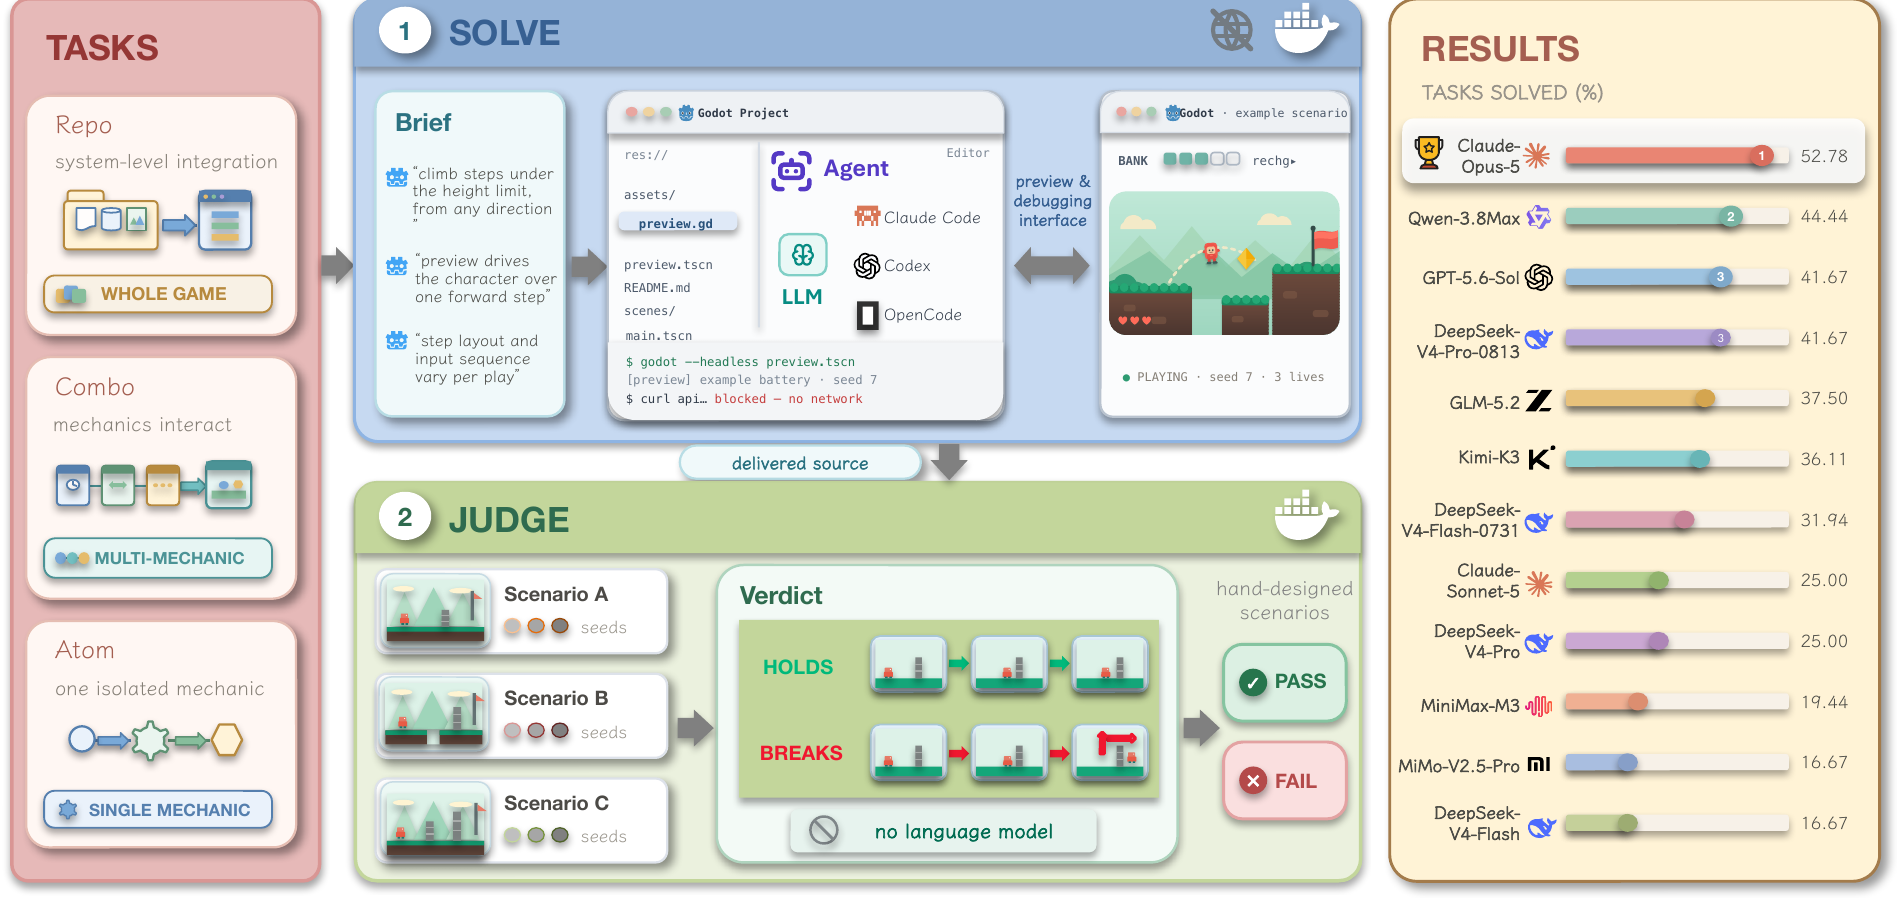
论文 benchmark 总览
GameLogicBench · arXiv:2609.21562v2 · 2026-09-21
02 · PART 0 / GODOTScene 是 Node tree

先把 Godot 想成一棵会运行的组件树

Level.tscn
├─ Player · CharacterBody2D
│ ├─ Sprite2D
│ ├─ CollisionShape2D
│ └─ Camera2D
├─ Enemy · CharacterBody2D
└─ HUD · Control
Node渲染、碰撞、相机、声音和输入等职责由不同节点承担。
Scene保存后的节点树可以像一种新节点那样被重复实例化。
Script脚本挂在节点上,通过回调和 signal 与整个 scene tree 协作。
Godot 4.4 官方文档:Nodes and Scenes。
03 · PART 0 / GDSCRIPT一段可挂到 CharacterBody2D 的脚本

输入、物理帧、状态与 signal 在同一段代码里相遇

extends CharacterBody2D

signal health_changed(value: int)
@export var speed := 220.0
var health := 3

func _physics_process(_delta: float):
    var d := Input.get_vector(
        "left", "right", "up", "down")
    velocity = d * speed
    move_and_slide()

func take_damage(amount: int):
    health = max(health - amount, 0)
    health_changed.emit(health)
每个 physics tick读取输入、更新 velocity,再让引擎处理碰撞与移动。
Signal角色发出 health_changed,UI 可以订阅,而不用被写死在角色逻辑里。
为什么难测同一个结果可能跨多个 node、回调和物理状态共同产生。
示例为本文整理;语义依据 Godot 4.4 官方文档。
04 · PART 0 / TICK一次物理更新就是一个可检查时刻

只看终局,会把错误轨迹压成一个正确数字

只看最后一帧

t0
10
t1
0
t2
10
END
10

资源先被错误扣空,又被补回。终点与正确实现相同,过程已经违规则。

逐 tick 断言

t0
t1
t2
END

在第一次破坏守恒或事件顺序时就失败,不让后续状态掩盖它。

论文 §1、§3.1。tick = 一个离散的游戏仿真更新步。
05 · MOTIVATION现有评测缺少哪三件事

评测需要同时看到更多场景、更完整轨迹和可复现 verdict

固定示例不够

一条 preview 能通过,不代表换布局、输入顺序或数值后仍然正确。

最终状态不够

跨帧规则可能中途被破坏,最后又回到看似合法的状态。

录像不够

资源守恒、内部时序和状态继承问题未必直接出现在画面里。

模型 judge 不够稳定

交互选择和打分都含模型判断,重复运行可能给出不同 verdict,成本也高。

论文 §1。作者的目标不是评价美术与体验,而是确定性验证 gameplay logic。
06 · RELATED WORK比较单位:运行中产物的判定方法

GameLogicBench 把范围收窄,以换取逐帧和确定性

Benchmark
项目形态
判定
Tick-level
Scenario
GameDevBench
Godot patch
Test scripts
部分
1
JAMER
Godot / 两类
Engine verify
1
GameCraft-Bench
完整 Godot 游戏
VLM judge
1
GameEngineBench
UE5 patch
Tests + LLM
部分
1
GameLogicBench
Godot patch / 两类项目
Engine assertions
全部
2–12
根据原论文 Table 1 重排。完整原表见正文证据图册。
07 · ORIGINAL FIGURE 2任务 → 求解 → 判分 → 结果

Agent 在公开 preview 中调试,judge 在隐藏 scenario 中验收

原论文 Figure 2
原论文 Figure 2。求解容器和判分容器均断网;评分路径不调用语言模型。
原论文 Figure 2。
08 · TASK TIERS分的是 integration scope,不是游戏品类

从一个机制,到多个机制,再到真实项目

ATOM

隔离一个机制

在为 benchmark 新做的最小游戏中实现寻路、冷却、碰撞等一个功能。

21
COMBO

机制相互作用

时间、空间或同帧请求互相影响;只把每个部件单独做对仍可能失败。

28
REPO

真实项目集成

补回一个真实开源项目的组件,必须读懂调用方、资源和共享状态。

23
论文 §2、Table 2。
09 · INFORMATION BOUNDARY隐藏的是实例,不是规则

Agent 知道行为契约,但不知道 judge 会怎样组合条件

Agent 可见

  • 任务 brief 与可修改文件
  • 项目代码和接口
  • 一个 baseline scenario
  • 可更换 seed 的 preview

Agent 交付

  • 指定 GDScript 文件
  • 允许范围内的 helper
  • 不交自评报告
  • 不修改冻结 judge
论文 §2.1、§3.1;官方 harness README。
10 · ORIGINAL FIGURE 3人类把关两端,Agent 完成中间工程

一个候选机制要经过筛选、试验、构建、校准和复审
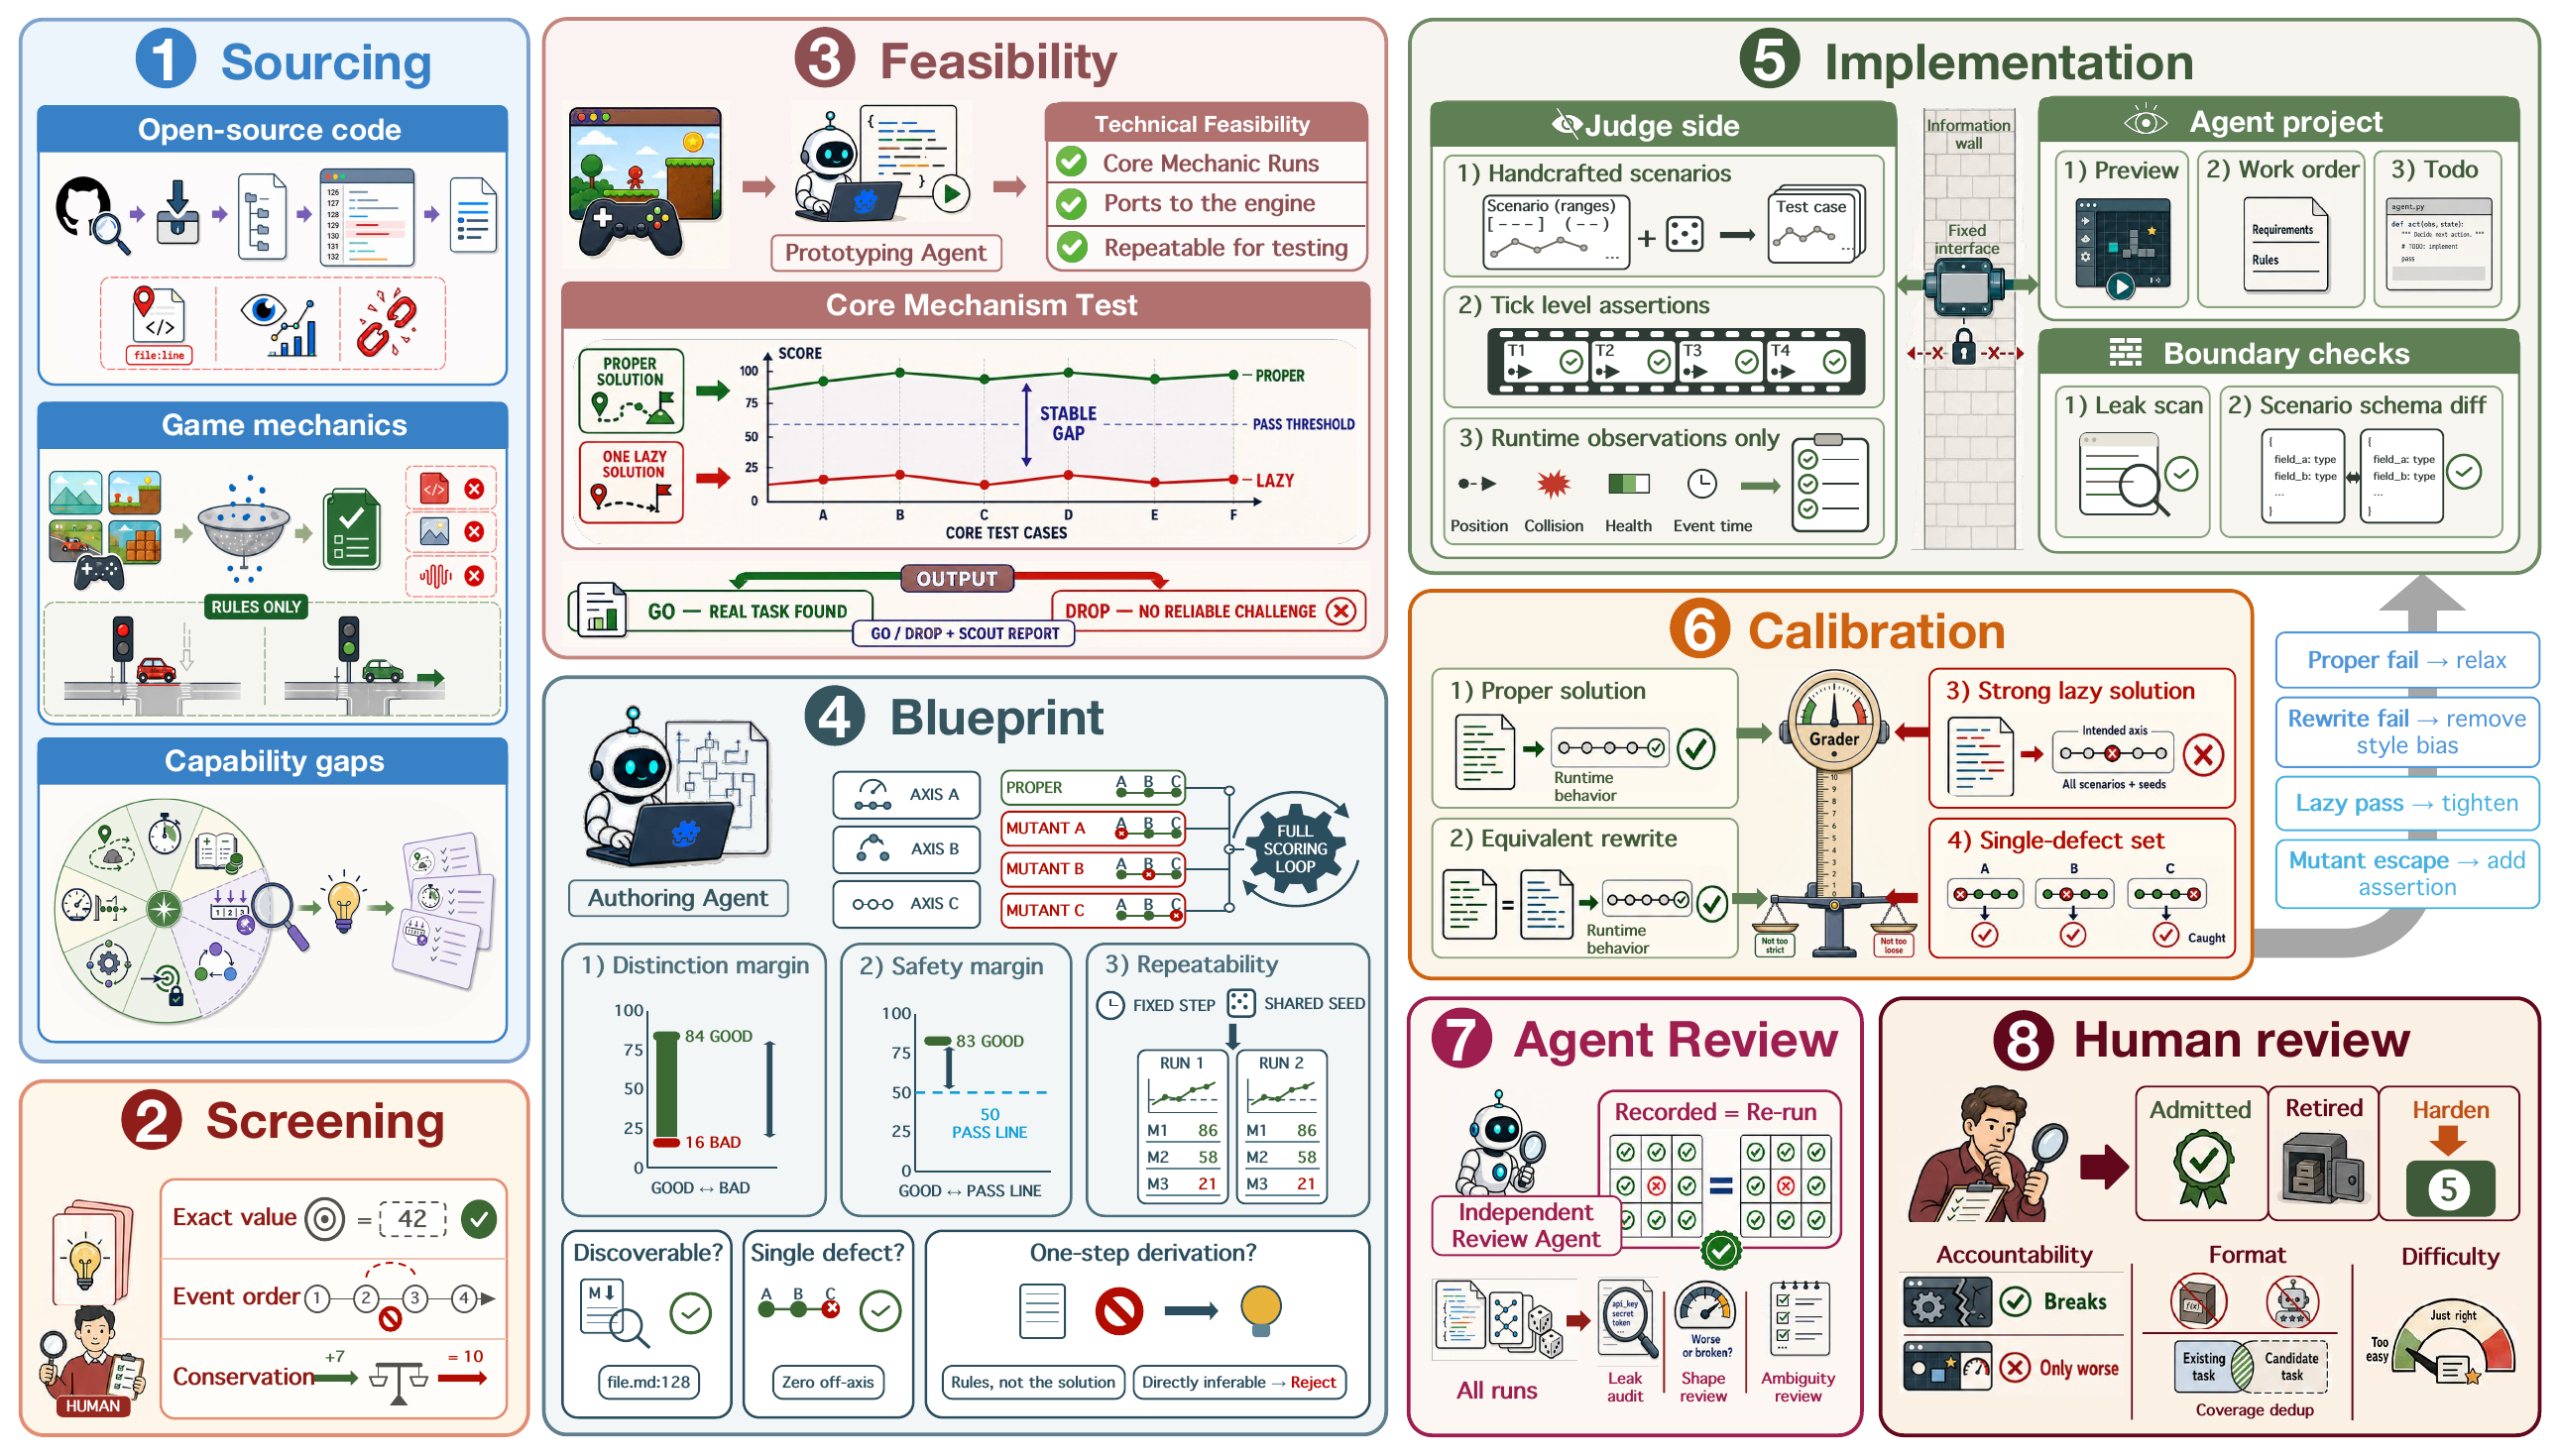
原论文 Figure 3
原论文 Figure 3。约 200 个候选想法 → 122 个完成构建与 Agent review → 72 个被人工录取。
原论文 Figure 3、§2.2–2.3。
11 · CRITERION VALIDATION先验证 judge,再拿 judge 评模型

既要放过不同的正确实现,也要抓住缺一项能力的错误实现

POSITIVE

Proper solution

所有 scenario 与 seed 都通过,并远离容差边界。

MUST PASS
NEUTRALITY

Behavior-preserving control

内部写法不同,但可观察行为相同。

MUST PASS
COMMON ERROR

Naive solution

包含常见逻辑错误,用来证明测试不是只看能否运行。

MUST FAIL
TARGETED ERROR

Single-capability mutant

每次只删掉一项能力,必须被对应 scenario 抓住。

MUST FAIL
论文 §2.3。
12 · WHY MUTANTS MATTER正确解通过,不代表 judge 没有漏洞

未用 mutant 反查时,127 个错误实现通过了原 criterion
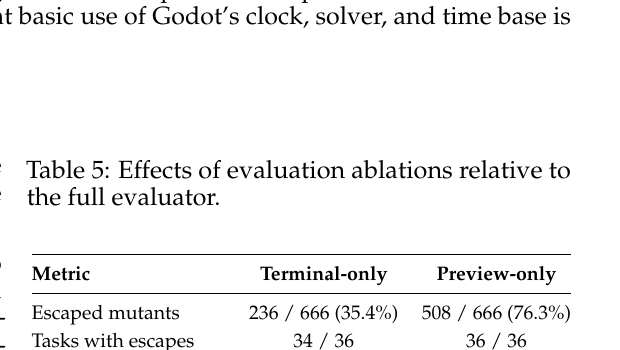
原论文 Table 5
127 / 666控制版 criterion 放过的 mutant,暴露 19/36 题中的 24 个缺失检查。
Terminal-only236/666 个 mutant 逃逸,34/36 题至少漏一个。
Preview-only508/666 个 mutant 逃逸,36/36 题全部有漏网。
论文 §4.6、Table 5。127/666 是修补前 criterion 的独立审计结果。
13 · EVALUATION PROTOCOL两个断网容器,两套权限

Agent 能运行公开 preview,不能接触冻结 judge

SOLVE container

  • 项目、brief、一个公开 scenario
  • 可以启动 Godot、换 seed、读调试输出
  • 模型 API 可用;其他 outbound access 被封
  • 最终只提交允许的脚本
godot --headless --fixed-fps 60 ...

JUDGE container

  • Agent workspace 的副本
  • 冻结的隐藏 judge
  • 固定 timestep
  • 每个 scenario × seed 逐 tick 断言
same submission + scenario + seed
= same verdict
论文 §3.1;官方 harness README 说明 judge 通过复制顺序覆盖冻结文件。
14 · TICK-LEVEL ASSERTIONS示意代码,不是官方 judge 源码

同一组规则要在每个隐藏 scenario 和 seed 上保持成立

for scenario in hidden_scenarios:
  for seed in scenario.seeds:
    var run = launch_fixed_timestep(
      scenario, seed)

    while not run.finished:
      run.advance_one_tick()
      assert(resources_are_conserved(run))
      assert(event_order_is_legal(run))
      assert(no_collision_violation(run))

    assert(run.completed_required_goal())
Scenario定义结构:地图、输入计划和要施压的能力轴。
Seed实例化数值参数,一个 scenario 可展开成多个 test case。
Tick在错误刚发生时失败,不让后续状态掩盖它。
按论文 §3.1 写成的等价伪代码;公开仓库未提供具体任务 judge。
15 · CASE / ATOMEnemy Navigation

到终点还不够:整条轨迹不能碰墙

decide(state)
→ Vector2

Agent 每个物理帧只返回一个移动方向。地图、门洞、起点和终点会随 scenario 与 seed 改变。

Source论文 Appendix F.2 的完整 brief。
Setup程序化生成带墙和门洞的 arena。
Action每个 physics tick 调用 Agent 的 decide
Observe当前位置、到达状态、圆形身体是否碰墙。
PASS:所有 seed 都在时限内到达且从未触墙。先穿墙再到终点仍然 FAIL。
原论文 Appendix F.2。
16 · CASE / COMBOPlatform Guard

巡逻、视线、跳跃和返回必须在同一条运行轨迹里兼容

Platform Guard

每帧返回 move、jump 和 chasing。平台宽度、gap、tower、访客时序都会变化。

巡逻安静期覆盖 home platform 至少 34%。
可见性距离够近且视线无阻挡;不能追墙后的目标。
对峙落地后接近到 130 units 内,空中掠过不算。
返回失去目标后,离开 home 不得超过 6 秒。
逐帧检查:坠落、ghost chase、未真正落地接近和逾期不归都能在发生时被定位。
原论文 Appendix F.3;数值均来自公开 brief。
17 · CASE / REPOAMSG Character Movement

补一个组件,要同时守住整个角色 rig 的运行契约

CharacterMovement
Component.gd

类、导出属性、状态字段和方法签名都已冻结;动画、相机和控制器依赖它们。

Preview从 +X 方向走上一个合法高度的台阶。
Hidden scenario从 −X 接近,远处再放一堵超过限制的高墙。
Behavior爬合法台阶,不能把高墙也当成台阶。
Whole-game state步态、蹲伏、跳跃、减速和 0.1 秒离地确认还要继续正确。
Repo 的难点:先读懂周围代码怎样消费组件状态,再补回逻辑;不能只按 brief 写一个孤立函数。
论文 §2.1、Appendix F.4。
18 · ORIGINAL FIGURE 472 题、七类能力与 token 规模

空间、决策承诺和状态机是覆盖最多的能力
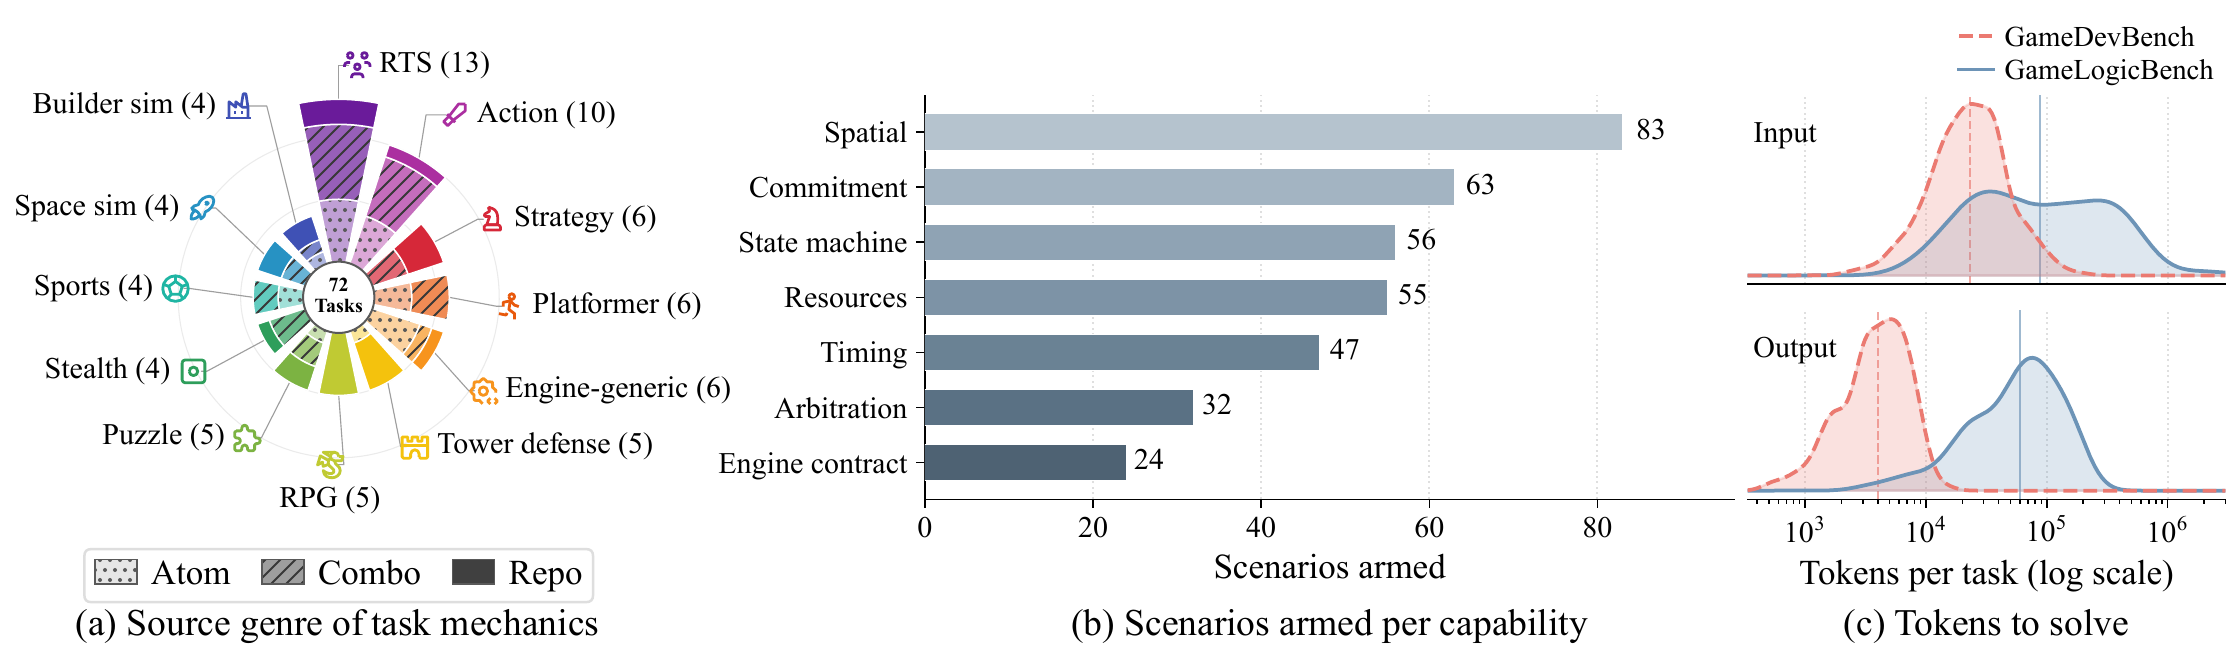
原论文 Figure 4
原论文 Figure 4。一个 scenario 可以属于多个能力类别,所以中间柱状图不能直接相加成 403。
原论文 Figure 4、§2.4。
19 · ORIGINAL TABLE 320 个 model + scaffold 组合

最佳单次结果 38/72;同一模型换 scaffold 可差 18 个百分点
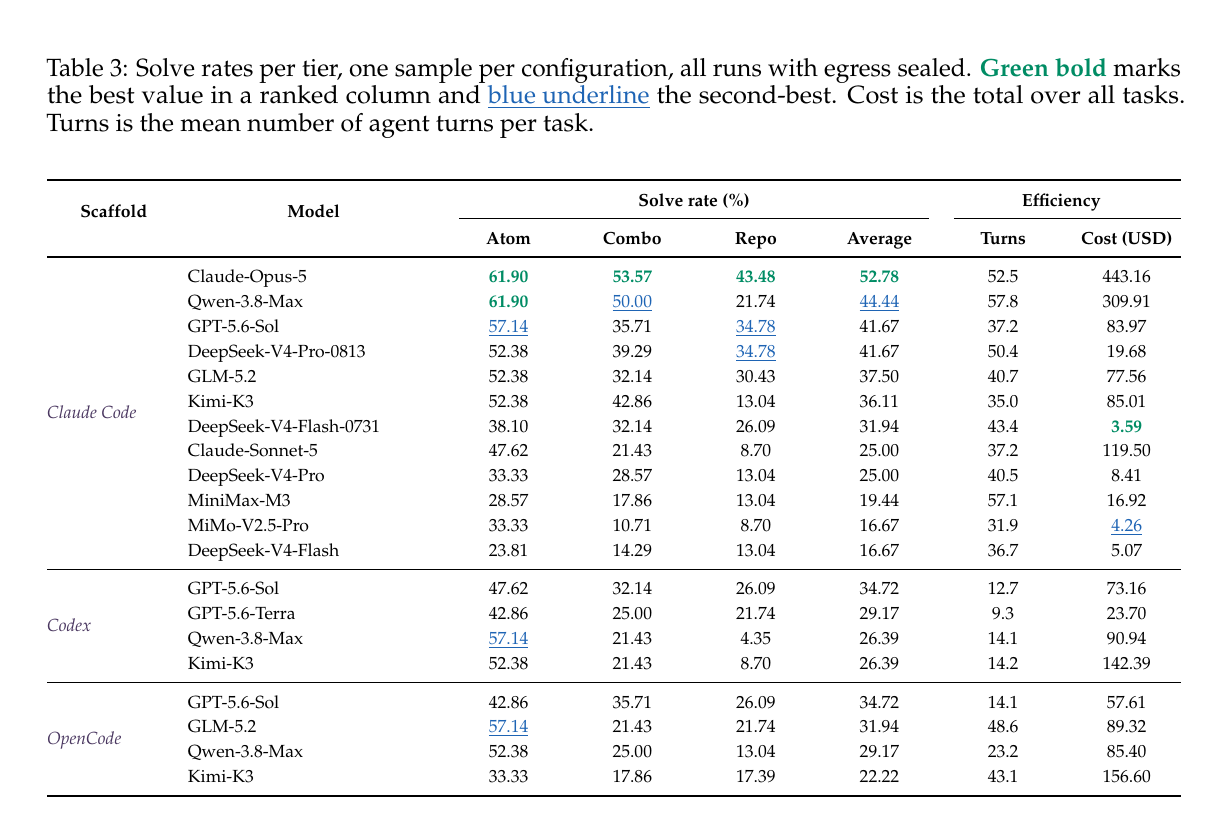
原论文 Table 3
Claude-Opus-5 + Claude Code:52.78%。每个组合只跑一次,不能当作稳定能力排名。
原论文 Table 3、§4.1。
20 · ORIGINAL FIGURE 1更贵不稳定对应更高成功率

相同 solve rate 的配置,总成本最多相差 25 倍
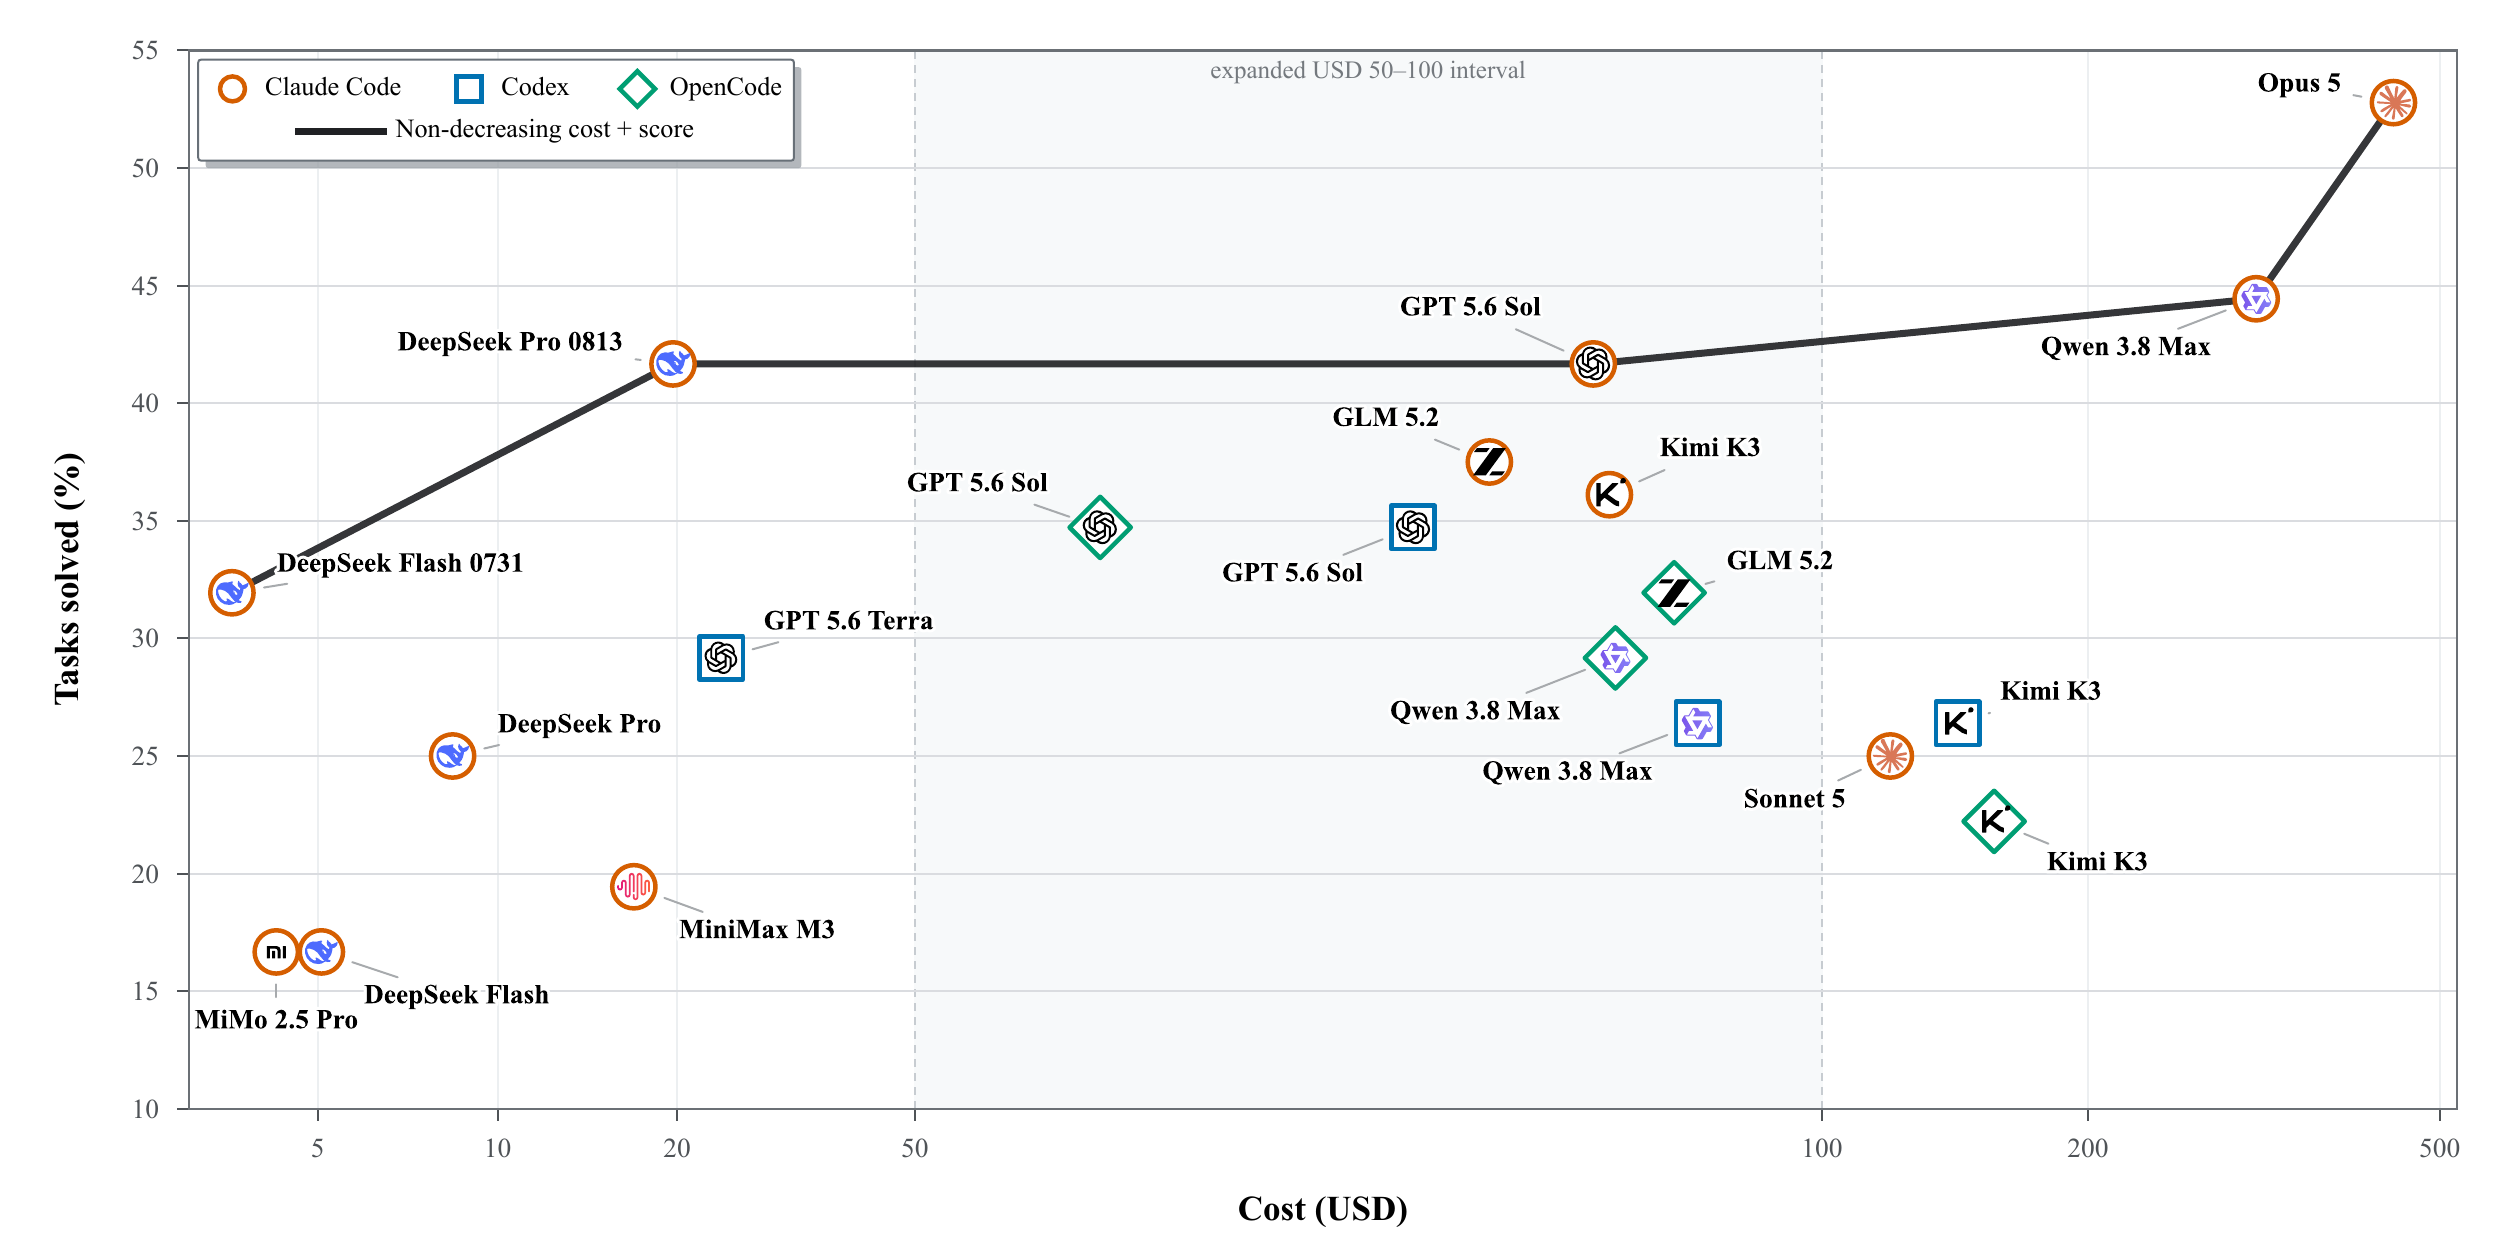
原论文 Figure 1
原论文 Figure 1。标线是观察到的 cost–performance frontier,不是新的评分标准。
原论文 Figure 1、§4.1。
21 · ORIGINAL FIGURE 5Atom → Combo → Repo

范围扩大后,Agent 做了更多运行实验,成功率仍持续下降
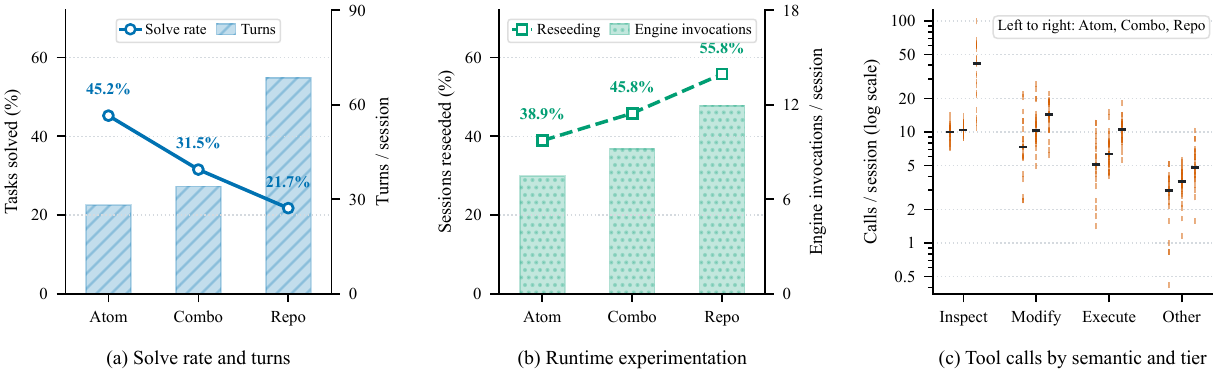
原论文 Figure 5
Claude Code 下聚合 solve rate:45.2% → 31.5% → 21.7%;Repo 的代码检查调用明显增加。
原论文 Figure 5、§4.2。
22 · ORIGINAL FIGURE 6工具界面改变调用模式

交互更少不等于一定更好或更差
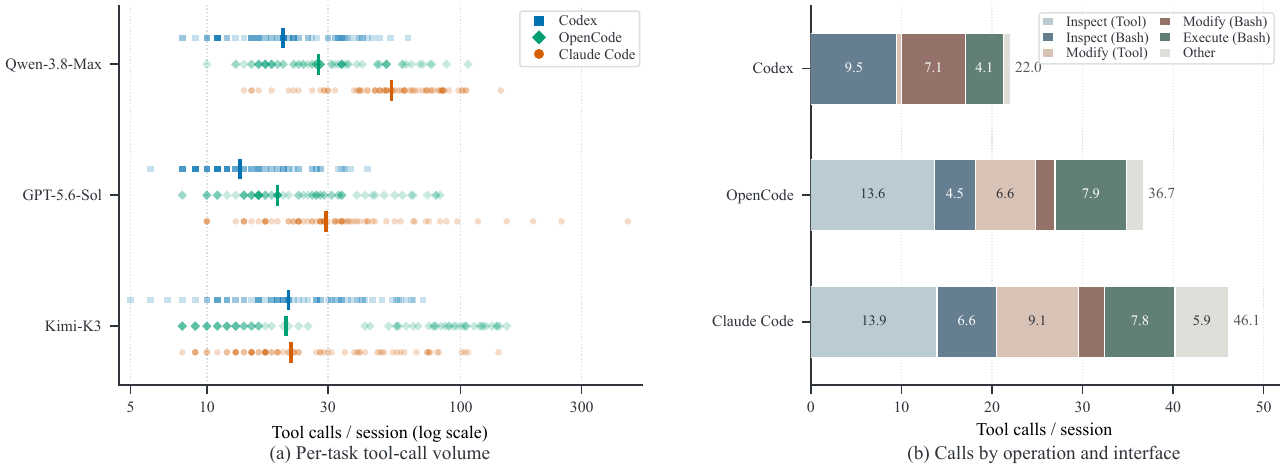
原论文 Figure 6
Codex 的调用量较少,并把检查与执行主要放在 Bash;Claude Code 与 OpenCode 有专用读写工具。
原论文 Figure 6、§4.3。
23 · ORIGINAL FIGURE 8多数失败项目能运行,只是行为不对

Engine contract 最容易;Commitment、Spatial、Timing 最难
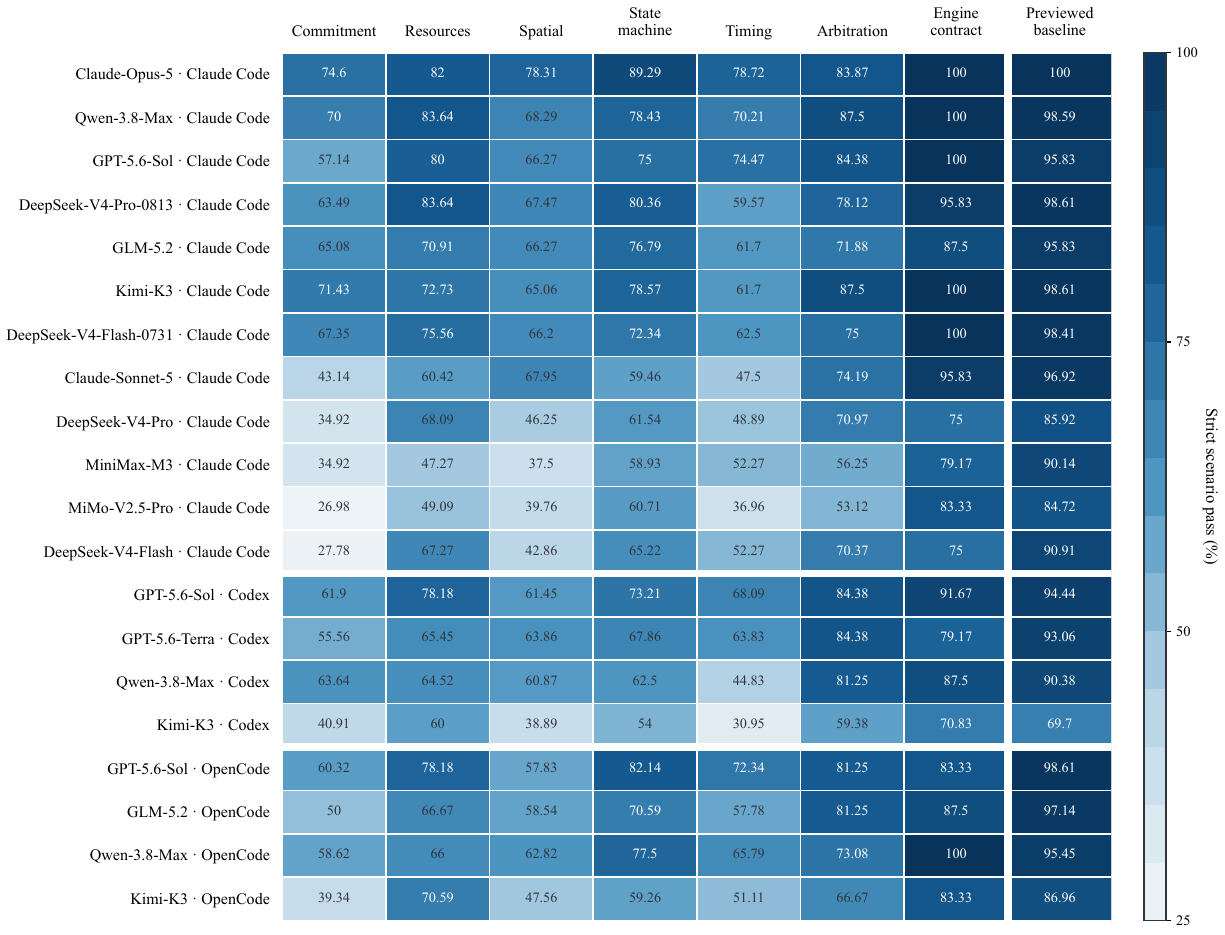
原论文 Figure 8
20 个配置 pooled:Engine contract 88.75%;后三类能力在 53.4%–58.57% 之间。
原论文 Figure 8、§4.5。
24 · ORIGINAL FIGURE 7开放网络后,Repo 题可能退化成检索

四个配置找到并直接复用了上游源码,成绩全部上升
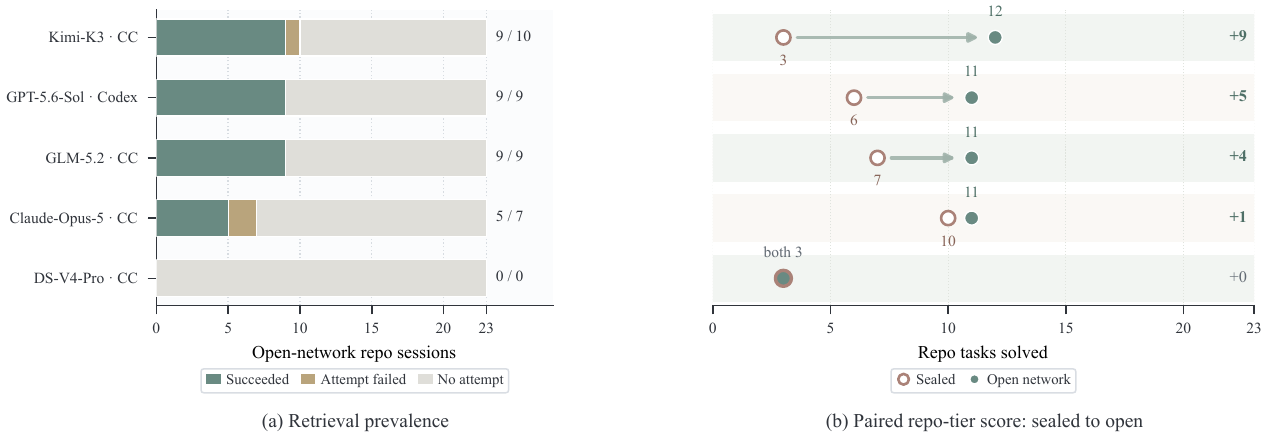
原论文 Figure 7
最大变化:Kimi-K3 + Claude Code 从 3 个 Repo 题增至 12 个(+9)。
原论文 Figure 7、§4.7。
25 · ORIGINAL FIGURE 9同一总分背后,解出的题可能完全不同

Repo 不只是平均更难,很多具体任务几乎没人解出
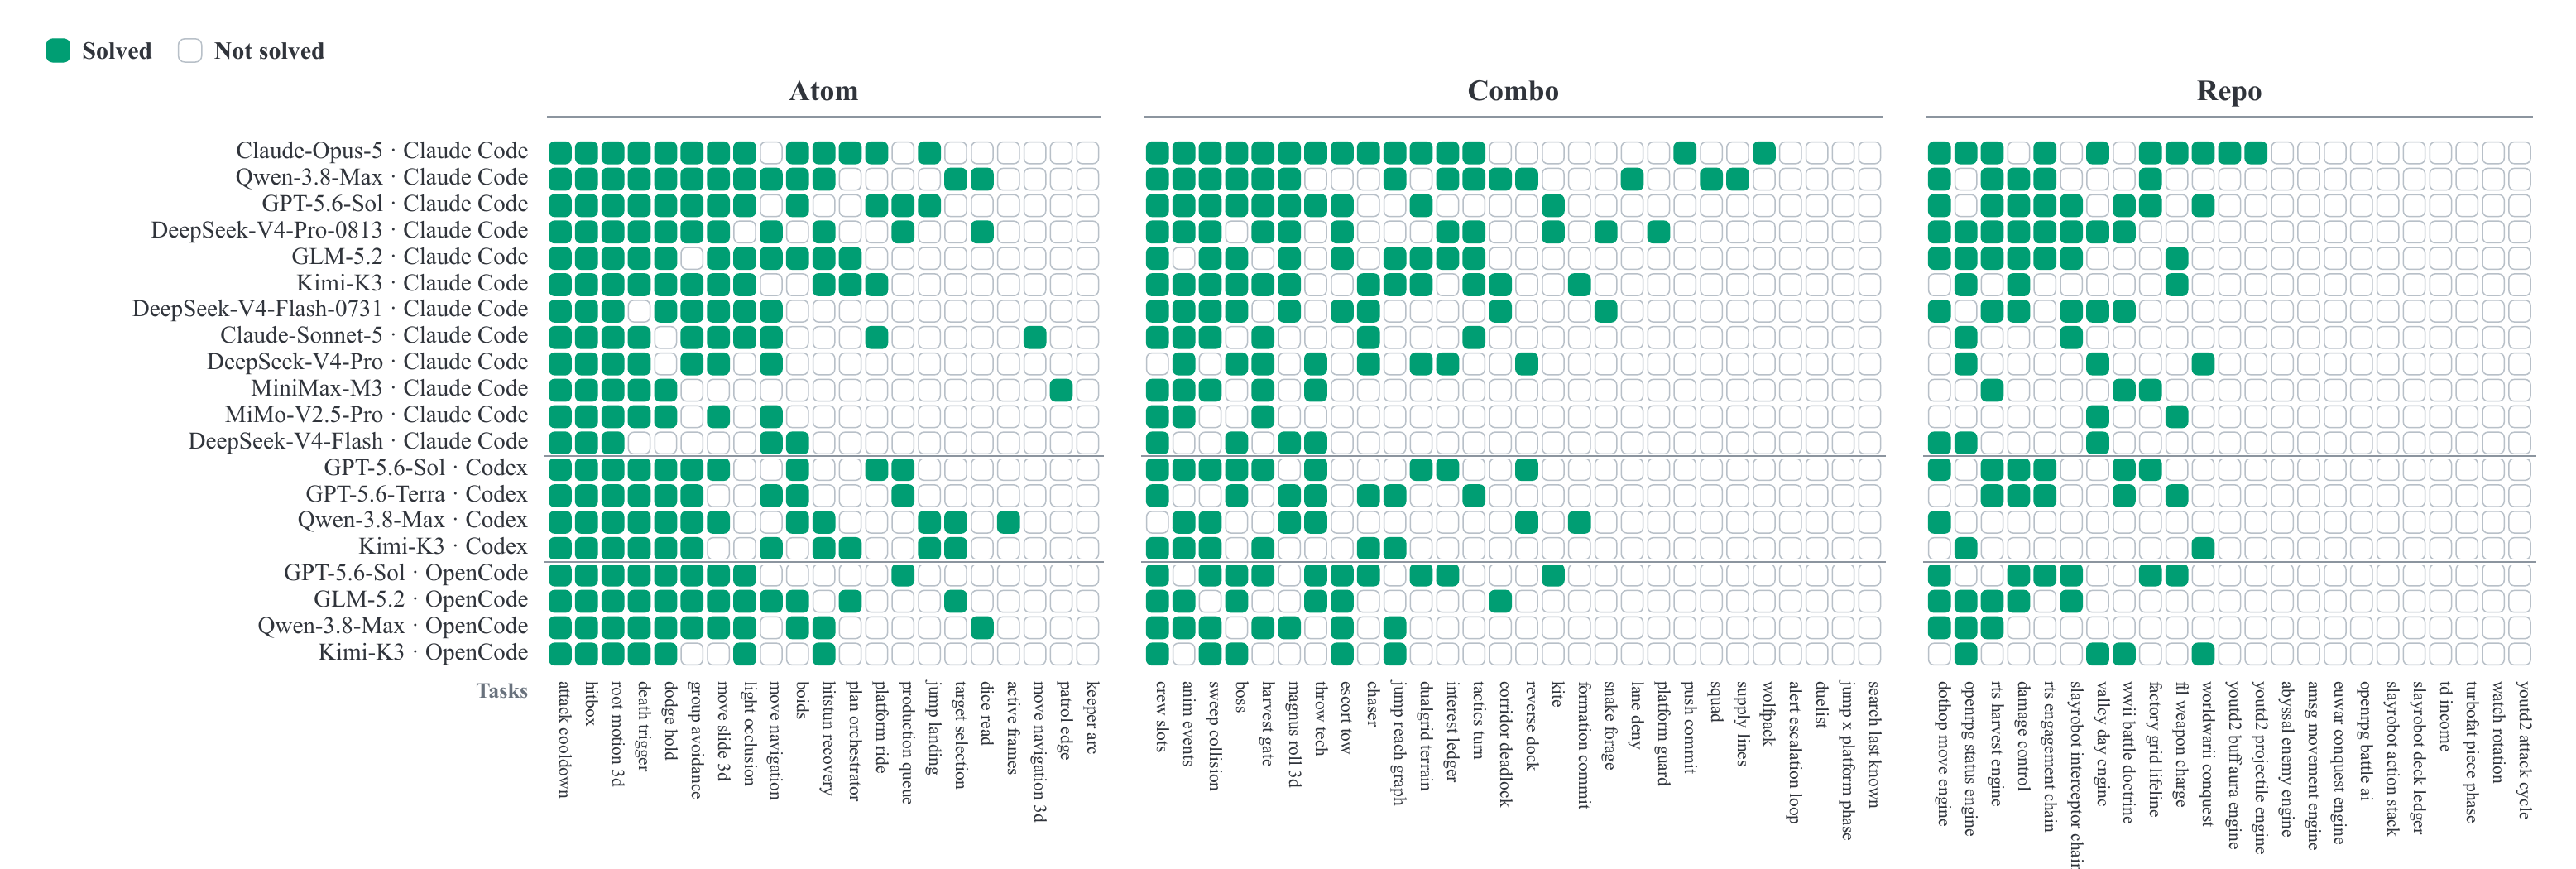
原论文 Figure 9
每列是一道任务,每行是一个 model + scaffold 配置,绿色表示该次运行通过整题。
原论文 Figure 9、Appendix C。
26 · TAKEAWAYS把 leaderboard 放回测量方法里理解

可信的 runtime benchmark,要同时验证提交和 judge

多个 judge-selected scenario 防止只对公开示例过拟合;tick-level assertion 防止终局掩盖过程错误;mutant calibration 防止 judge 本身漏掉缺失能力的实现。

74.3%失败 scenario 中,项目能运行但机制违约
21.7%Claude Code 下 Repo 聚合 solve rate
它不测什么美术、内容深度、整体玩家体验。
当前范围Godot 4.4、GDScript、单容器,无网络同步。
统计边界主表每个配置只有一次完整运行。
公开性边界harness 可见;论文所链接的 task repo 在本文核查时返回 404。
论文 · 官方 harness · 图表按 CC BY 4.0 引用
封面 1 / 26