ExeWorldBench 让模型写 Blender 程序,搭出能运动的三维机械装置:看一张图还原齿轮与连杆,接通多级小球装置,或者只根据文字设计一个放行机构。作者关心的是,模型能否把对机械结构的理解落实到可执行的程序里。装置中的后续运动应由碰撞、约束、重力等实际作用产生,不能给每个零件单独安排动画时间表。
本文对博客作者本人的兴趣程度:9 / 10。下文保留论文使用的模型名称。图表来自 Peng et al., ExeWorldBench v1,许可为 CC BY 4.0;除标明的裁切外,不翻译或改绘原图内容。
1. Motivation:程序能运行,机械装置未必能工作
作者要测的是:模型理解了一个装置之后,能否把它真正搭出来并运行完整过程。一张齿轮机构图可以被复刻成漂亮的三维模型,但连杆可能绕错轴,齿轮可能没有啮合。程序也可以正常运行,甚至让所有零件按顺序动起来,却没有任何机械传递。这些结果分别通过了外观或执行检查,但没有回答装置能否按要求工作。
多级装置把问题放大了。斜坡末端的小球要碰到第一块多米诺骨牌;最后一块骨牌要推动下一级机构;各级的高度、朝向、距离都要支持接触。某一级单独做对,不保证它能接入整条链。只提供目标时,模型还得先决定用什么机构,再确定几何和参数。
贯穿本文的公开任务 053 很能说明这点:两件运载物 A、B 都要经过同一个路口。B 必须先开始接近,但 A 要先通过;A 完全离开后,还要靠机械作用放行 B。等待 A 走完才启动 B,会违反“B 先开始”的要求。按预设时间打开门,也会违反物理依赖要求。下面是论文展示的 Codex 输出片段,完整案例和评分在 §3.5。
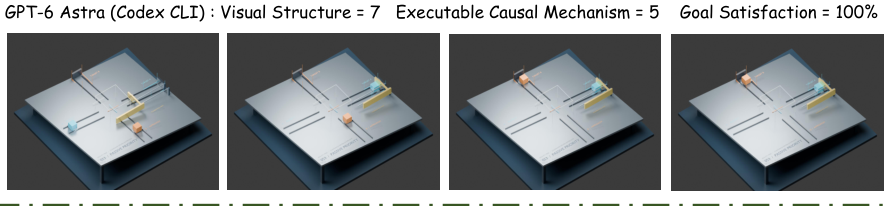
论文把“推断结构、运动与依赖”称为 world understanding,把“将这种理解写成能运行的系统”称为 executable realization。benchmark 将二者放在同一任务里测,但没有分别给出二者的独立能力分。因此,低分说明生成的装置有问题,不能仅凭分数确定问题发生在理解、规划还是实现阶段。
2. Related Work:任务更强调机械组合,评分仍有自己的边界
ExeWorldBench 的特色是复杂三维机构、连续机械传递,以及从视觉还原逐步走向自主设计。写物理模拟代码并不是它首次提出的任务,读取运行状态来验证物理行为也已有前作。理解这篇的贡献,需要分别比较任务内容和评价证据。
| 工作 | 输入与产出 | 评价证据 | 与这篇的区别 |
|---|---|---|---|
| PhysCodeBench | 物理现象的文字描述 → Genesis / MuJoCo 模拟代码;v2 有 1,200 个专家验证样例 | 执行、视觉指标,以及直接读取引擎状态的物理断言与守恒量检查 | 更适合验证物理量是否正确。ExeWorldBench 更集中于多组件装配与逐级传递,但其帧评分无法替代状态断言 |
| WorldCoder-Bench | 自然语言及可选 3D 资产 → 浏览器中的 Three.js 世界;2,026 个任务 | StateProbe 执行动作并读取内部状态,用隐藏规则检查变化;规则通过故障注入校准 | 突出交互、物理量与界面状态同步。ExeWorldBench 的 Blender 场景突出关节、接触和机械组合,不能把浏览器 3D 一概说成没有因果评测 |
| VisPhyWorld | 视觉观察 → 可执行模拟;209 个场景、108 种模板 | 重建外观与运动是否符合物理过程 | 重心是从观察推断动力学。ExeWorldBench 还包括不给视觉参考、只给组件或目标的设计任务 |
| MPMWorlds | 二维物理视频与不同量的辅助信息 → 模拟代码或视频预测 | 能否恢复动力学并稳定外推;包含变形体、流体等 | 二维不等于物理内容简单。它关注材料与动力学参数,ExeWorldBench 关注三维机械装配和传递 |
| 3DCodeBench | 文字 / 图片 → 三维建模程序;测试 12 个视觉语言模型(VLM) | 生成几何、渲染质量及 3DCodeArena 的人工成对偏好 | 核心是程序化建模。ExeWorldBench 进一步要求生成结构执行完整机械过程 |
| PACE-Bench | 已能在原环境工作的一份设计 → 在变化后的环境中修正设计;144 对任务 | 有限尝试预算下,用模拟反馈检查目标是否完成 | 关注条件变化后的机制改造,不是从零生成;与这篇“结构设计比改对 API 更难”的发现相呼应 |
这里最值得对照的是前两篇。PhysCodeBench v2 的专家把题目里的物理要求写成可执行的真假检查,称为物理断言(assertion),再由第二位专家复核;执行失败的程序,其断言也算失败。WorldCoder-Bench 要求生成程序提供状态接口,评价器执行动作,检查位置、速度、碰撞和界面读数是否同步;作者还往参考实现注入错误,检验规则能否抓住错误。它们尝试把“画面看上去合理”进一步落实到可审计的状态变化。
ExeWorldBench 的评分提示则强调:相邻机构应真实碰撞、推动、释放或传递,不能独立播放动画。这让题目的机械要求更明确,但评分模型没有直接检查这些依赖在代码里怎样实现。它的任务设计和评分模型掌握的证据需要分开评价。“首次全面评测”的措辞是作者的贡献声明,本文不将其当作已经独立证明的结论。
对照依据:ExeWorldBench §2;另核查 PhysCodeBench v2 §3–4 的数据与 PhysCodeEval,以及 WorldCoder-Bench §2–3 的任务、StateProbe 和隐藏规则。其余四篇的范围与规模来自各自原始摘要,不跨论文比较分数。
3. Benchmark / Protocol:从任务包到一份评分
这篇没有训练新模型,而是规定四种生成任务,再评价生成代码和动画。理解流程时,先看模型交什么,再看作者怎样构建题目,最后跟随一次提交进入评分。数据构建时用过的参考动画和检查信息,并不自动成为被测模型的输入。
3.1 四种任务,逐步减少搭建提示
论文分为 T1、T2、T3 三个主任务,T3 再分两种设计设置;下文按四种设置讲解。公开数据中的独立题目数量可由固定版本的任务文件逐个数出。T1、T2 还提供加入运动参考帧的变体,但它们是同一道题的另一种输入设置,不能再次计入总题数。
这些是评测题,公开版本没有另设训练、验证和测试划分。不同设置的参考图、运动帧和任务文件已在同一公开数据集中,因此未来用它训练模型时,需要重新划分并控制参考材料的泄漏,不能直接把现有结果当作未公开测试集上的成绩。
| 任务 | 独立题数 | 模型看到什么 | 模型还需决定什么 |
|---|---|---|---|
| T1 · Mechanism Executability | 50 | 单个复杂机构的静态参考图;主要设置不给运动帧 | 还原几何、关节与约束,并推断完整运动 |
| T2 · Compositional Executability | 100 | 多级装置的静态参考图;另测加入运动帧的设置 | 还原各机构,并调布局接通整条机械链 |
| T3-1 · Component-Constrained Synthesis | 63 | 组件名称与定义、组件数、球数;没有参考图片 | 组件顺序、布局和连接;每个指定实例恰好用一次 |
| T3-2 · Goal-Constrained Synthesis | 60 | 目标、物体、状态与事件定义、初始条件、规则、最终条件 | 连机械实现本身也要自行设计 |
T2 允许调整组件的高度、距离和朝向,使前一级确实接上后一级,不要求死抄图片里的像素位置。T3-1 则把输入列表打乱:重复出现两次的斜坡是两个独立实例,列表的前后顺序不代表执行顺序。允许必要的地面、支架和轴,但不能新加功能级来绕过原组件;评分提示还会惩罚通过辅助结构过度简化原动作的实现。
3.2 数据与要求是谁写的
作者采用模型辅助构建、过滤与人工复核,而不是把全部任务和检查都称为人工标注。Figure 1 汇总了不同路径。图中的 Evidence Generation 等操作是制作和验证 T1 题目的过程,不是正式评测时让被测模型依次运行的步骤。
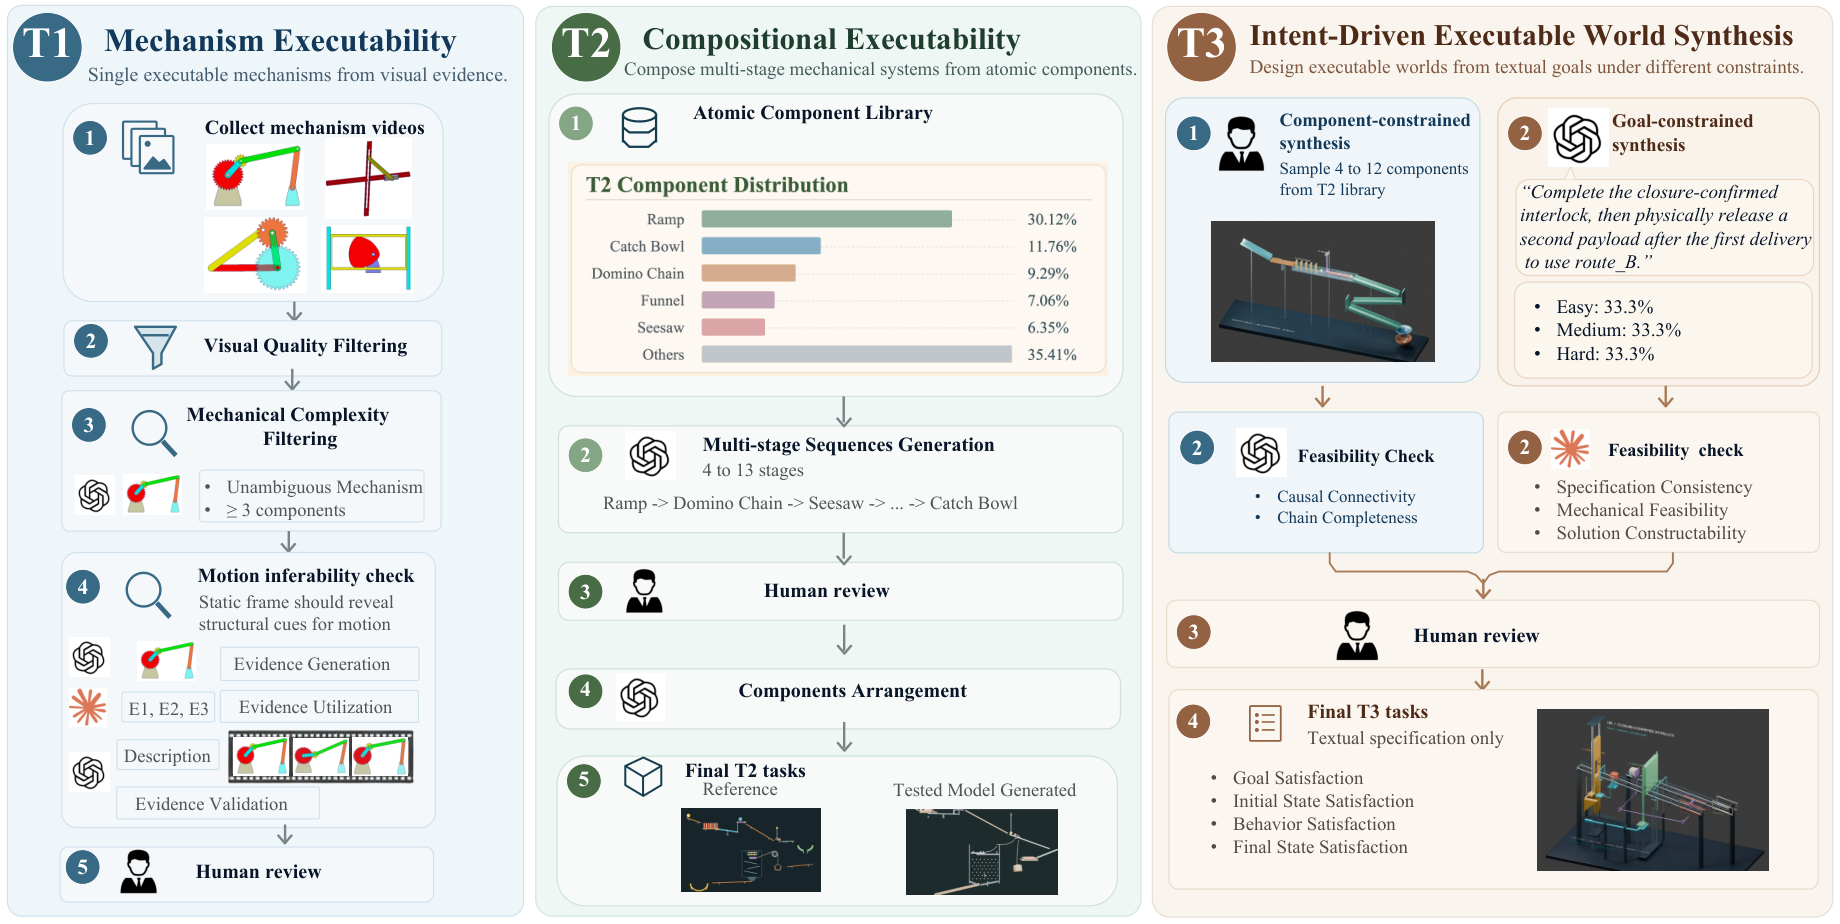
T1 从公开机械动画中采样。作者先过滤模糊、压缩失真等低质量图,再由 GPT-6 Astra 排除遮挡严重、组件边界含糊、机械活跃组件少于三个的案例。接下来,他们检验“只看静态结构,是否有足够线索推断运动”:Astra 同时看到静态图和完整运动帧,经过三轮生成三条只描述静态结构的线索;Opus 5 只看静态图与这些线索,写出运动描述;Astra 再把描述与参考动画核对。最后五名人工标注者排除仍然难以推断或有歧义的题目。
这条路径证明的是题目经过了运动可推断性的筛选。三条构建线索不在公开 T1 主设置的模型输入中,正式任务仍主要给静态图片。论文也未报告这五名标注者的逐题分歧或一致性系数。
T2 由作者先制作有预定义运动的原子组件代码库。Astra 提出 4–13 级组件序列及相邻级的传递关系,人工审核顺序和连接是否符合物理。之后 Astra 在 Codex CLI 中组合已有组件实现、调整空间布局,生成连续参考动画。这里不是让 Astra 从零发明每个参考组件。这份组件代码库尚未出现在公开仓库里,也不能只凭“预定义运动”判断参考实现内部用了何种物理求解或动画代码。
T3-1 从 T2 的组件库抽取 4–12 个组件,Astra 检查是否存在连贯顺序、所有组件能否参加同一条链,再保留可行集合。被测模型只拿到名称和定义,不拿到作者的实现代码。T3-2 则按 easy、medium、hard 各三分之一,让 Astra 按统一字段格式(schema)生成完整规格;Opus 5 核对规格是否一致、机械上可解、可构建有效参考解,最后人工复核。论文没有公布全部筛选失败样例、复核分歧或完整参考实现。
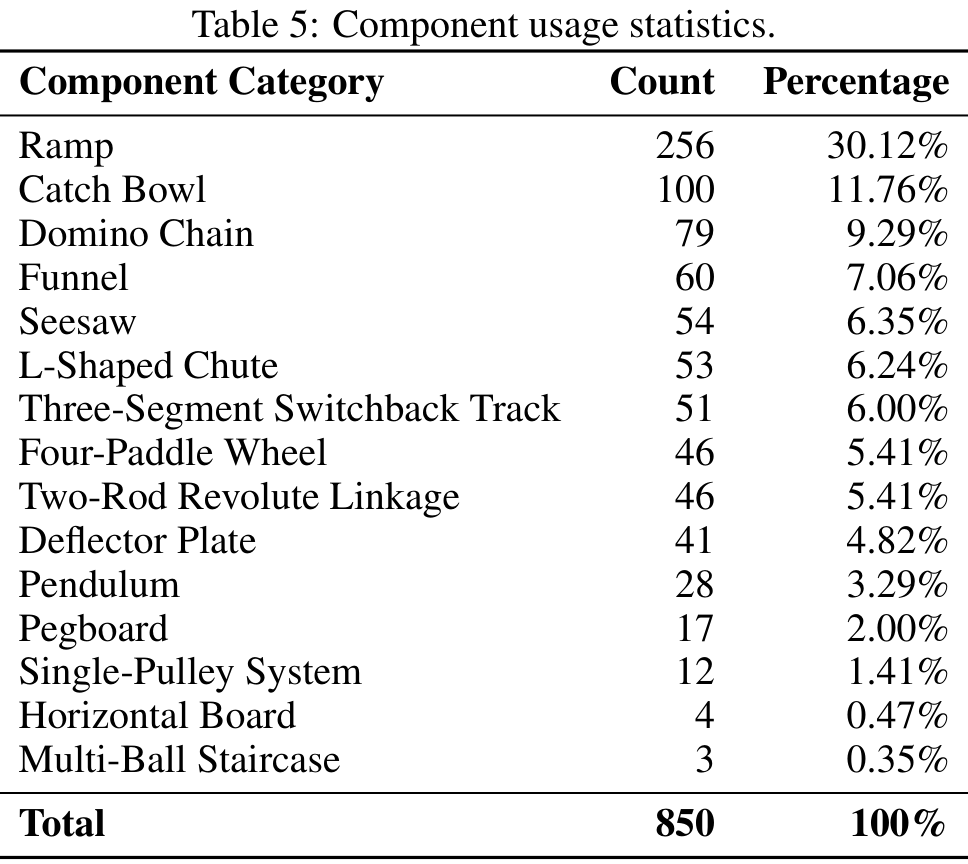
Table 5 也说明了数据分布:题目大量围绕斜坡、小球、骨牌、漏斗、跷跷板等装置。它适合检验机械组合,不能自动代表流体、柔性体或所有三维世界建模任务。公开 T1 动画来自已有资源,也应单独考虑模型是否接触过这些机制;当前公开版本没有给出足以量化污染程度的审计。
3.3 被测模型怎么生成,哪些信息没有给它
作者比较两类使用方式。把模型接到文件系统、shell、Blender 等工具并组织多轮执行的外层软件,在这里称为 harness;接入这些工具、能够执行任务的模型称为 Agent。论文的两个实例是 GPT-6 Astra + Codex CLI,以及 Claude Fable 5.1 + Claude Code:它们可以写脚本、执行、查看结果、继续修改,最后交出 .py 和由最终脚本生成的 .blend。
API-based 设置是直接通过 API 调用模型一次,输出可解析的 {"code": "完整 Blender 5.2 Python 程序"}。作者再用 Astra + Codex 修复技术性执行错误,分别记录修复前和修复后的结果。论文约束修复不得改变原场景结构或预期行为,但修复过程的执行代码和每轮代码改动没有公开,无法独立核查每次修复是否都遵守这一边界。
公开的 harness 提示禁止扫描其他目录、把文件当额外参考材料,但没有公开操作系统层的文件隔离配置。T1/T2 主设置不提供完整参考动画;T1 构建线索和 T2 组件实现也不提供给被测 Agent。公开生成提示没有将最终评分反馈交给 Agent 的步骤,不能据此认为它根据评分修改过设计。生成与 API 修复的预算也不同,论文没有给出严格匹配的总 token(模型处理的文本单位)数、工具调用次数、实际耗时,以及用多个随机种子重复运行的统计。
- 模型输入参考图或文字规格
- 生成提交Blender 程序与场景
- 评分输入动画采样帧及参考 / 条件
- 输出分数执行、结构、机械与目标
本文梳理的流程,不是原论文图。构建时用过的参考资料不自动进入生成输入;评分完成也不等于 Agent 已收到反馈。依据:论文 §3–4 与公开生成 / 评分提示。
3.4 动画如何被 judge 评价
论文用 Opus 5.5 作为 VLM judge:一次独立的多模态模型调用读取评分提示和图像,输出结构化分数。公开提示只要求根据可见帧判断,不读取生成源代码、碰撞日志或逐步状态断言。T1 明确用六张均匀采样的生成帧和有序参考运动帧;T3-1 用九张均匀采样的生成帧。T2、T3-2 的公开评分提示未统一指定帧数。
四个指标各有用途:
- Visual Structure(
V,0–10)看几何、连接、装配、物理合理性及是否清楚可见。它也包含相机、光照、材质与渲染呈现;提示规定结构正确但呈现普通通常不高于 8,出现明确机械结构错误一般不高于 5。因此不能把 V 解释成纯几何准确率。 - Mechanical Motion(
M,0–10)用于 T1,比较整体运动、约束和机械作用。参考帧与生成帧时间不对齐,不能逐帧按相同下标配对,也不要求相同速度或精确轨迹。未采到的短事件,如果邻帧能合理支持,可以被推断出来。 - Executable Causal Mechanism(
ECM,0–10)看组件动作是否完成,以及前一级是否通过机械作用触发后一级。T2/T3-1 每段 0–10,再平均;单纯先后运动不够。公开 T3-2 提示却输出一个整体 ECM 整数,和正文笼统的“各段均值”描述不同,不能擅自补出其分段实现。 - Goal Satisfaction(
G)用于 T3-2。judge 分别对初始状态 I、中间行为 B、最终状态 F 的每个条件给 0 或 1。部分满足、近似满足、时序错误或证据不足都算 0;同一条内有多个要求时必须全部满足。
T2 已给 judge 指定组件顺序;T3-1 则要求 judge 从动画推断实际顺序。N 个组件对应 N 段:initial → C1,再到 C1 → C2,一直到最后。A → B 一段同时评价 incoming handoff(A 对 B 的机械传递)和 B 的完整动作,不重复评价 A 的动作。某处断链后,无法由连续机械传递到达的后续段全部记 0;后来独立运动不能恢复得分。
例如四级装置中,前两级顺利执行,第三级只得到部分传递,第四级自行按定时器启动。用于讲解的段分可以是 [9, 8, 2, 0],ECM 为 19 / 4 = 4.75。这是本文构造的算术例子,不是任何模型的实测轨迹;其中第四段为 0 的原因是断链后独立启动,而不是它最后有没有动。
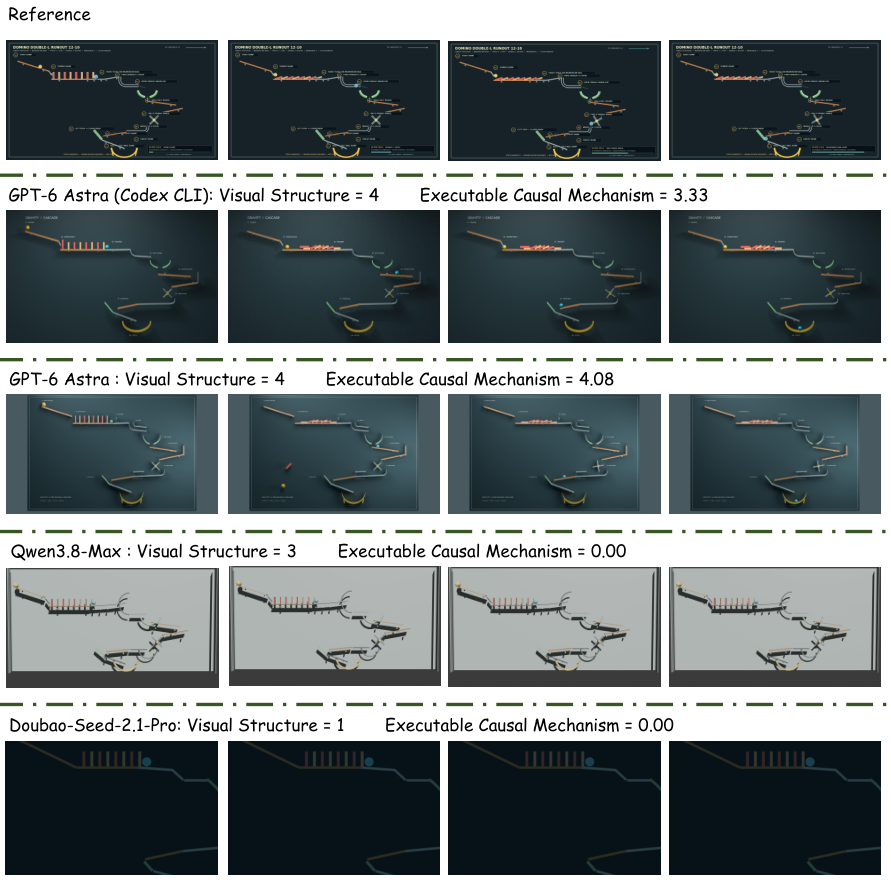
一个真实的 T3-1 例子是 12_10,同时列在论文附录:12 个组件、2 个球,包括 4 个斜坡(Ramp)、2 个 L 形滑槽(L-Shaped Chute),以及折返轨道、收集碗、挡板、五块骨牌组成的骨牌链、四叶拨轮和漏斗各一个。输入的列表顺序被打乱。两球都须参加同一条机械链,但可以由一个球推动机构,再释放另一个球接力,不要求同一个球走完全程。
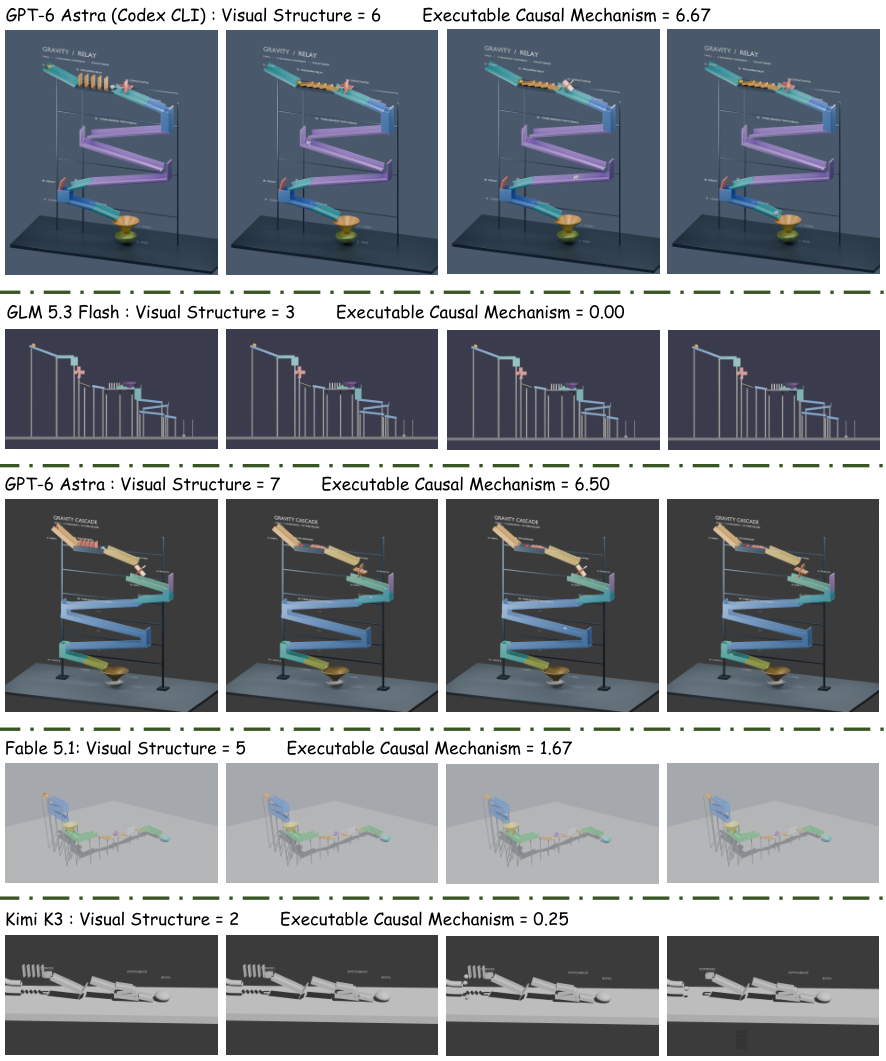
12_10。每行是同一模型输出的四个时间点,不是四种设计。Codex 的 ECM 为 6.67,Astra API 为 6.50,GLM 为 0;完整输入见论文 pp.20–21 和公开任务文件。来源:Peng et al., v1, p.18,CC BY 4.0。Figure 8 能显示是否形成连贯装置,但没有发布逐段 judge 输出;不能从四个缩略帧中编造“第几块骨牌在第几帧失败”的日志。评分提示中的“如果移除 A,B 是否仍会动”也是辅助推理问题,T3-2 提示明确说不需要真实干预实验。它不是评价器真的移除了零件再运行一遍。
3.5 真实任务 053:先开始接近,后取得通行权
这道题要求实现机械优先权,不能靠错开两条动画掩盖问题。输入来自公开任务 t3/task2/053/053.txt,规格与论文 pp.20–21 一致。它属于前述模型辅助生成、校验、人工复核的数据路径,但没有公开逐题署名的标注记录。
Agent 看到两个运载物 payload_A、payload_B,各自目标区域 target_A、target_B,共享路口体积 shared_region,两个内部检查平面,以及一个自行设计形状与连接的被动机械组件 object_A。这里的 payload 就是要运输的物体,未限定必须是球。object_A 控制 B 的进入;A 完全离开共享区时,应通过物理作用改变它的位置或姿态,从而放行 B。
题目开头的目标原文是:
1 | Start payload_B's approach before payload_A enters shared_region, |
初始状态要求 A、B 静止、都在共享区和各自目标外,object_A 处于预先声明的 state_A0。另一姿态 state_A1 也须在模拟前声明可测量范围,并与 state_A0 不重叠。共享区是预先画明边界的固定体积,不能运行到一半重新解释“哪里算路口”。
事件定义采用不同几何标准,这会改变是否满足时序:E_enter_A 是 A 的任意碰撞几何首次与共享区重叠;E_exit_A 是 A 的全部碰撞几何完全离开。检查点(checkpoint)要求物体中心正向跨过内部有方向的平面;到达 target 要求整个碰撞几何完全被目标体积包含。把中心离开当成全部离开,会过早放行 B。
- B 先从初始姿态持续开始移动,随后 A 才进入共享区。B 可以已在接近,但必须留在共享区外。
- A 按“进入共享区 → 正向跨 checkpoint_A → 完全离开共享区”的顺序通过。A、B 在整个过程中不能互相接触,也不能同时占据共享区。
- A 的完全离开通过真实机械作用使 object_A 进入 state_A1,object_A 再机械地允许已经运动的 B 进入。两次先后关系不能由软件定时器替代。
- B 同样按“进入 → 跨 checkpoint_B → 完全离开 → 到达 target_B”的顺序完成。A 离开后也要到达 target_A,且两者不能再进入共享区。
- 最后持续保持 A、B 完全在各自目标中,以及 object_A 处于 state_A1;只在最后一张图短暂达到不够。
其中最容易漏掉的是 R13 与 R05/R06 的组合:
R05 允许“离开”和“机构改变”、或“机构改变”和“B 进入”落在同一模拟步,但仍要求真实物理依赖。R06 又单独要求 A 完全离开严格早于 B 进入,因此不能据 R05 把两者设为同时发生。这些约束来自规格,不是本文额外加入的验收要求。
进入评分时,judge 看到动画采样帧、物体/事件/状态定义,以及整理后的 I/B/F 条目。它要检查早期静止与位置、中途接近和放行顺序、最后是否持续停留,同时独立给 V 和 ECM。公开评分提示是视觉判断,未提供读取这些几何事件的程序实现。规格也没有给出统一的运动阈值、最终状态需保持多久(final hold interval)或采样方案,无法据此复现完全相同的一次判分。
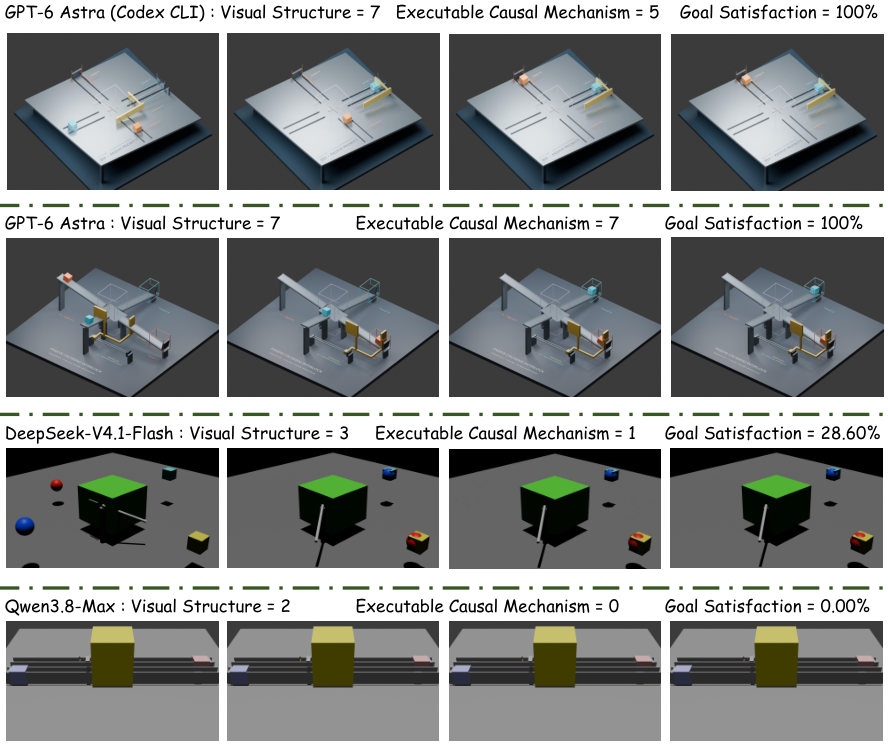
053 的原始结果。Codex:V=7、ECM=5、G=100%;Astra API:V=7、ECM=7、G=100%;DeepSeek:V=3、ECM=1、G=28.60%;Qwen:V=2、ECM=0、G=0%。作者展示的代表例,不是随机抽样的完整失败日志。来源:Peng et al., v1, p.19,CC BY 4.0。读图时有两个重要边界。第一,Codex 和 Astra API 的 G 都是 100%,ECM 却不同:明确条件全部被 judge 判定满足,仍可以有机械执行缺陷,两个指标不能合成“整题成功”。第二,原始规格有 7 条 Initial、13 条 Rules、3 条 Final,共 23 个编号条目,但Rules 如何转换成评分提示的 B 条目,逐项映射没有公开。因此不能用 23 作分母,反推 DeepSeek 的 28.60% 究竟是哪几条通过。
以下是依据规则推导的失败例,不是作者公布的模型日志:如果 A 的中心已经过出口、尾部仍在共享区时就放行 B,会违反 R02、R06 或 R12;如果 A 走完才启动 B,会违反 R13;如果门在第 60 帧自动打开,即使画面时序恰好符合要求,仍违背 R05 的物理依赖。帧评分能看到其中一些后果,但未必能识别所有实现伪装。
3.6 从条目分数算到主表
G 是先按题算条件满足比例,再对题取平均。对第 i 道题,P 表示满足的条目数,N 表示总条目数,I/B/F 分别指初始、中间与最终条件:
这里每题等权,不是把全数据的通过条目直接相加再除以总条目。I、B、F 的类别满足率也各自按题平均;三类别率直接平均通常不等于 G。论文未定义某类别无条目时如何处理,也没有报告“所有条件且机械过程都合格”的严格任务成功率。
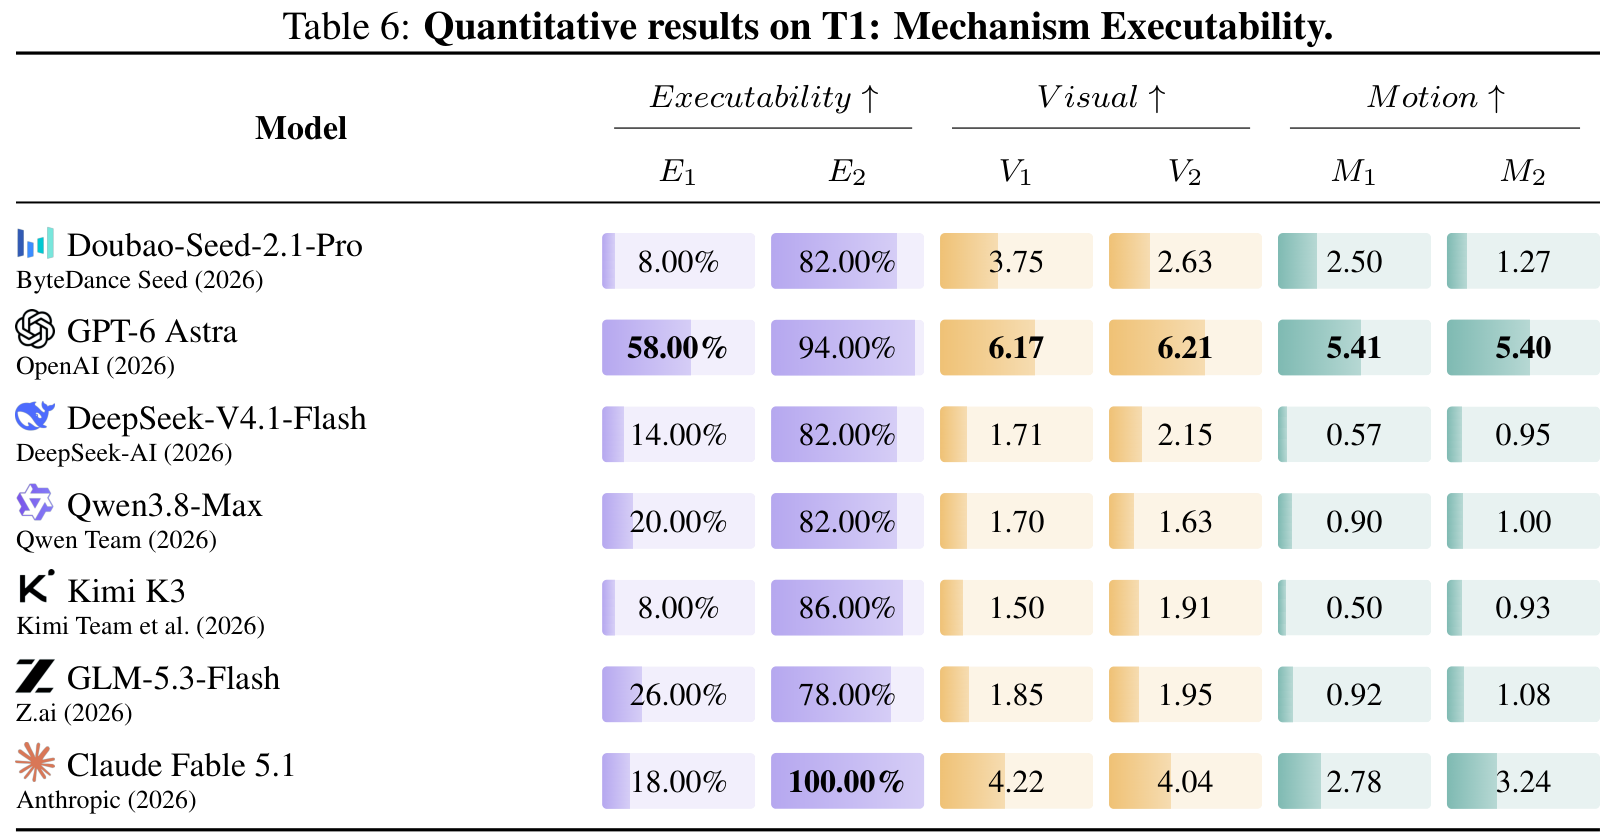
主表让执行失败的题记零,分母保留全部题目,称为 penalized metrics。附录 Tables 6–9 只对能执行的题计算质量均值,称为 conditioned metrics。下标 1 是 API 原始生成,下标 2 是技术错误修复之后。两种均值不能混着比较。可用公开表值复算:Astra 在 T1 修复后执行率 94%,执行成功题的 M 均值 5.40,因此全题均值约为 0.94 × 5.40 = 5.08。
1 | # 独立算术示例,可用 Python 3 运行;不是官方 judge 或 runner。 |
输出分别为 4.75、62.50%、66.67%、5.08、18.13%。前两个虚构任务说明按题平均与按条目平均的差别;后两项仅验证表格算术,不能验证 judge 判分或修复程序。
4. Experiments:修好执行错误,仍接不通机械过程
最稳定的发现是,执行率与机械正确性明显脱节。以下均为作者报告的主设置结果;先看主表的全题均值,再看特定案例和额外输入实验。Harness 行已经包含 Agent 的执行与修改,API 的下标 2 又包含外部技术修复,两者不是严格匹配预算的单次生成比较。
4.1 单个机构:有外形,不一定有正确约束
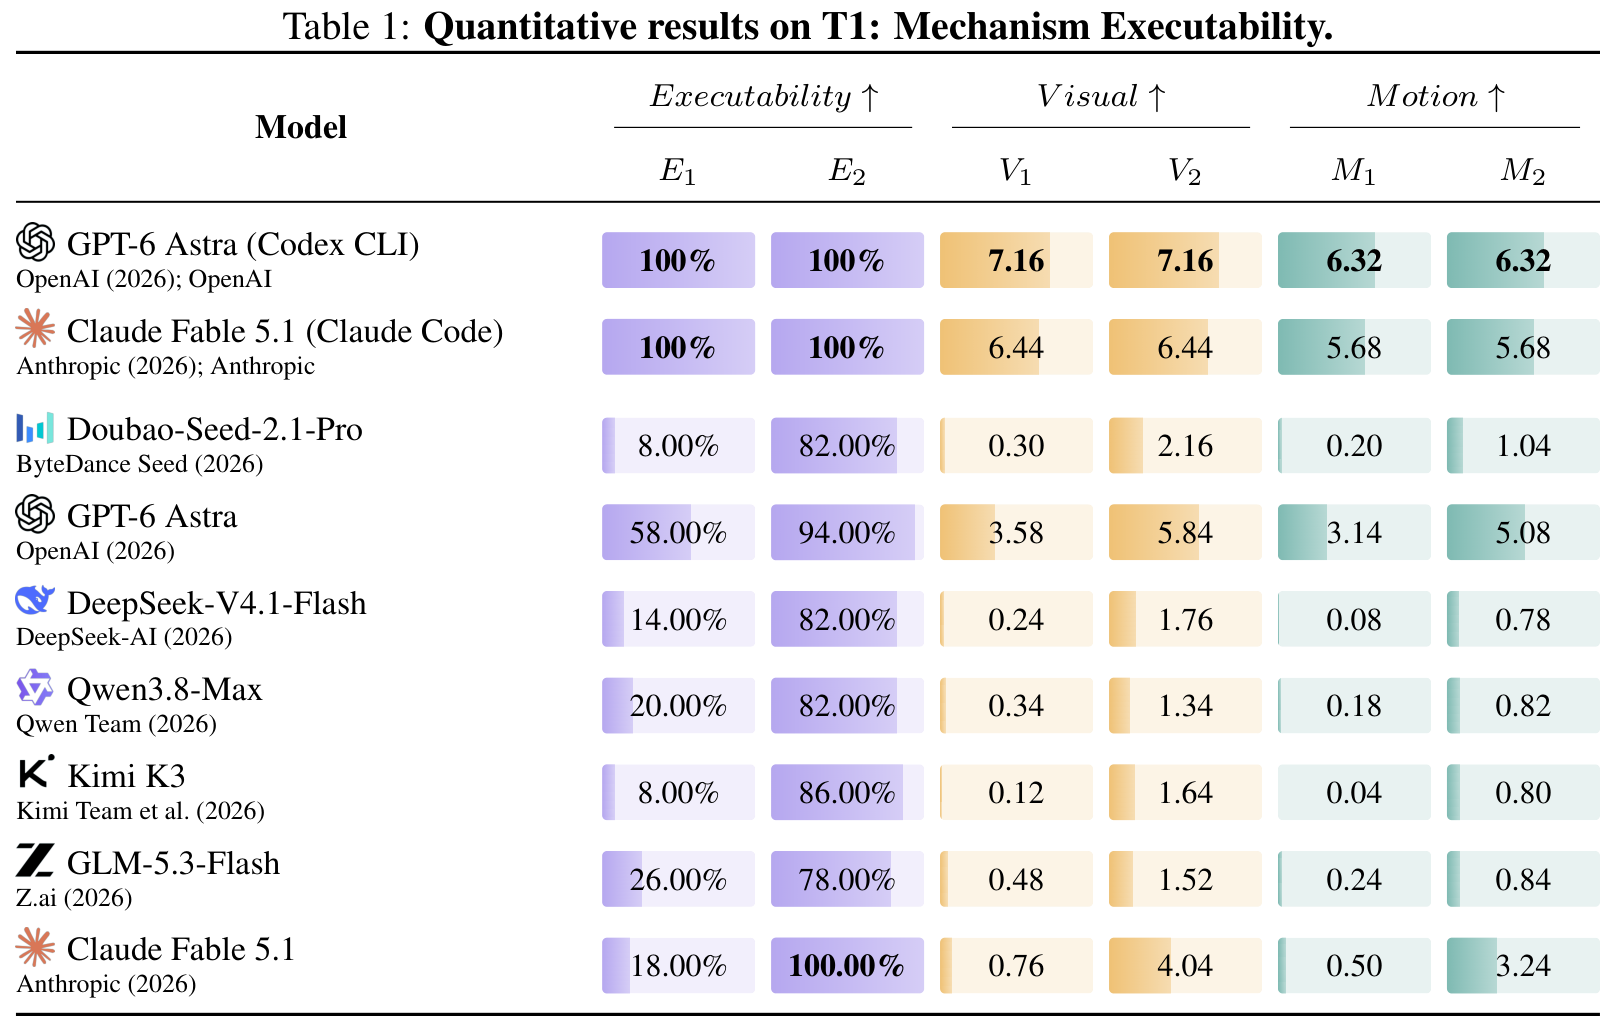
Codex 的 M 为 6.32,Claude Code 为 5.68。Astra API 修复后执行率从 58% 升到 94%,M 从 3.14 升到 5.08;Kimi 则从 8% 升到 86%,M 只从 0.04 升到 0.80。Fable API 修复后 V=4.04、M=3.24,也说明结构呈现与运动表现有差距。
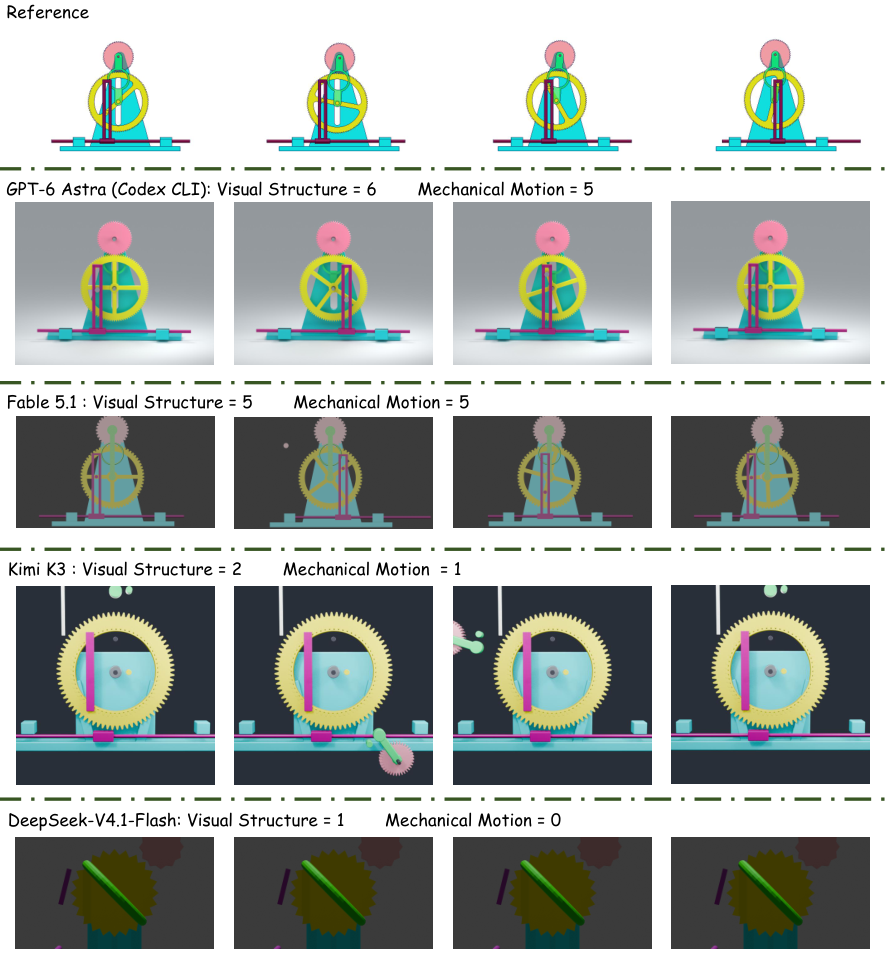
4.2 多级组合:每级都动,与每级都接上是两件事
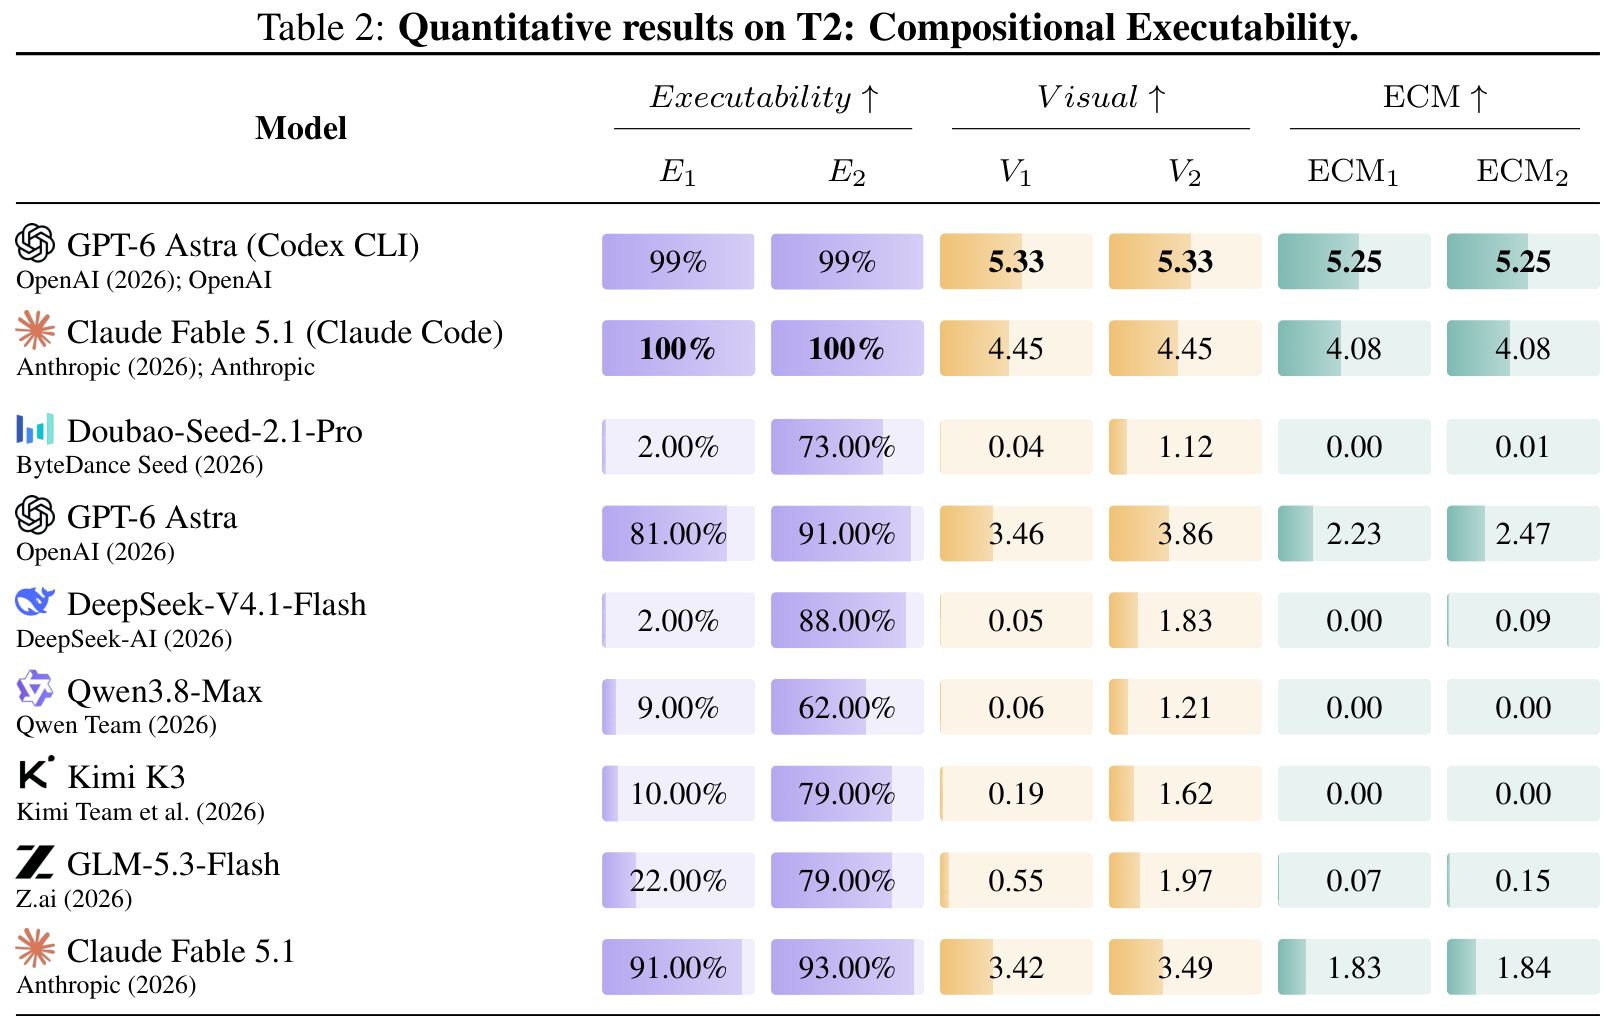
T2 中,Kimi 修复后 79% 的代码能执行,但 ECM 仍为 0;Qwen 修复后执行率 62%,ECM 也为 0。Astra API 达到 91% 执行率、ECM=2.47。这里的低 ECM 可能同时包含组件自身动作错误、几何接触错误和断链后续零分,不能当成纯“因果推理准确率”。
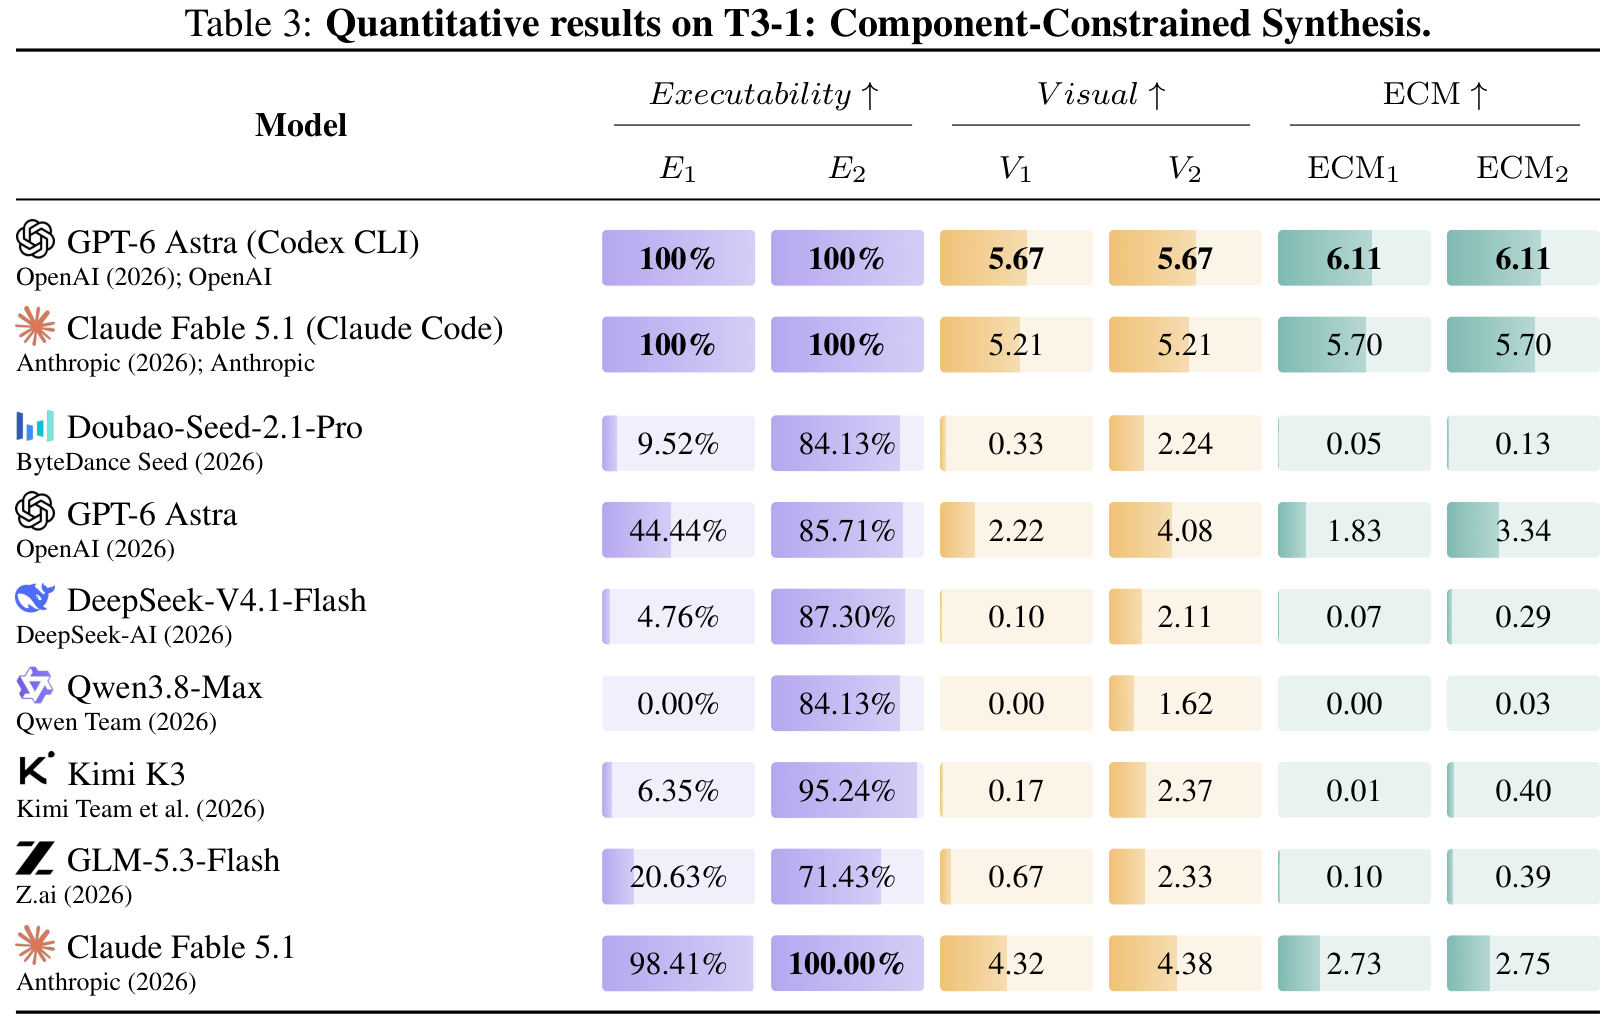
指定组件但取消参考图之后,Codex 的 ECM=6.11,Claude Code=5.70;Astra API 修复后为 3.34,Fable API 为 2.75,其余 API 模型最高为 0.40。T3-1 的分数高于某些 T2 分数,不应解释成更难任务反而容易:两组题目、组件分布与参考约束都不同,它们不是同题逐步去提示的受控实验。
4.3 只给目标:初始场景较容易,持续完成较难
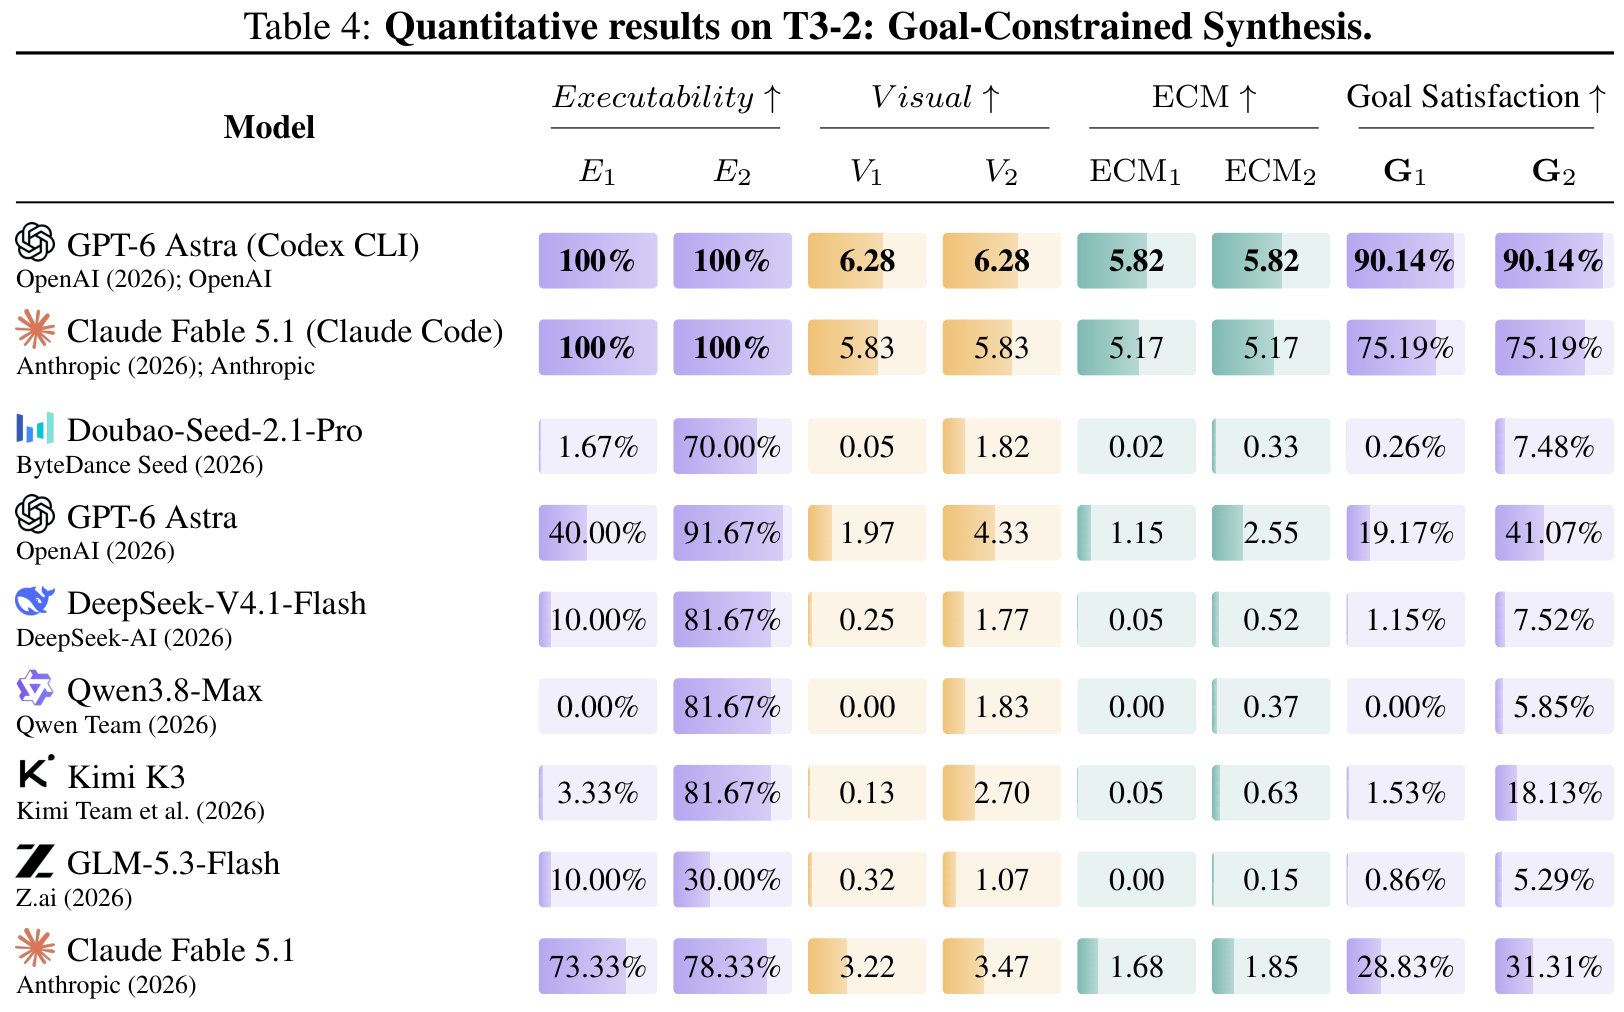
Codex 达到 G=90.14%、ECM=5.82;Claude Code 为 G=75.19%、ECM=5.17。Astra API 修复后执行率 91.67%,G=41.07%、ECM=2.55。Kimi 修复后执行率 81.67%,G=18.13%、ECM=0.63。这一结果支持“修对调用接口远不足以完成机械设计”,但不能量化 harness 本身贡献了多少,也不能把后续修复当成开源模型独立完成的成绩。
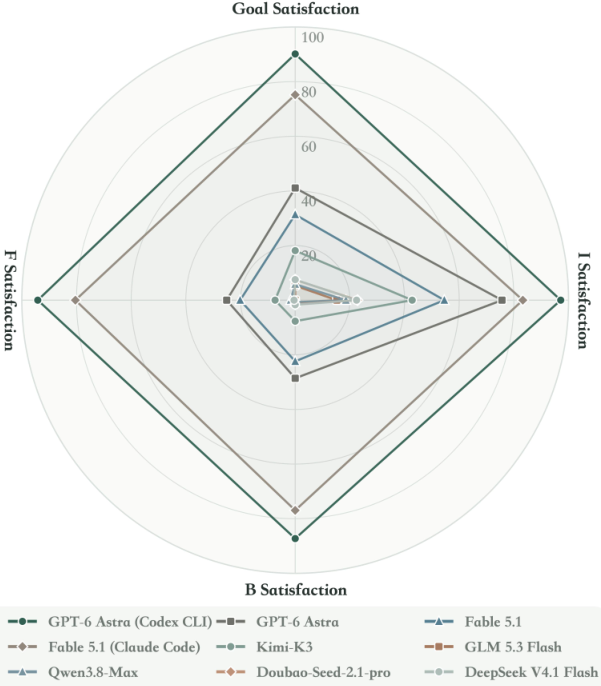
对 053 来说,初始条件主要是把 A、B 放在正确区域外、静止,并设置 object_A 姿态;中途条件却要求同时处理提前接近、机械阻挡、完全离开后放行和禁止再进入。Figure 5 的类别差异与这个难度区别一致,但论文没有给出每类条件数量和类型充分匹配的控制实验。
4.4 级数增加之后,更难保持连续传递
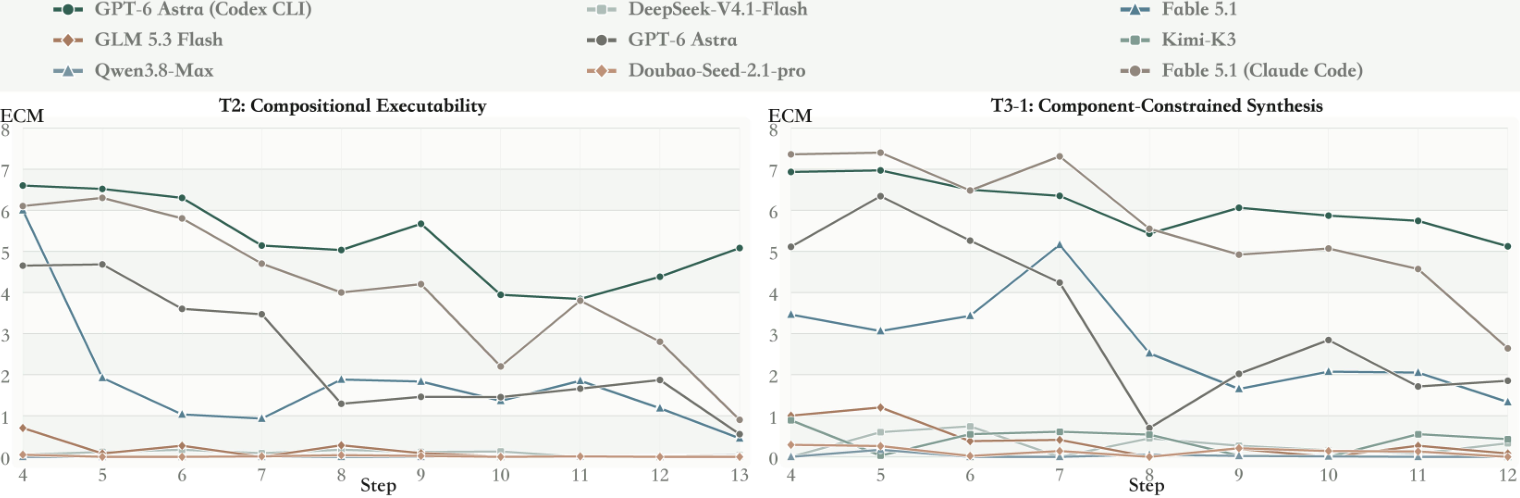
多数组随级数增加而下降,Codex 相对稳定;曲线仍有波动,不是逐点单调下降。更多级意味着更多可能失败的接触与传递,而且断链后下游零分会放大早期错误的影响。不过图中没有各级样本量与误差条,复杂题的组件种类也可能不同,不能据此拟合普适的“每多一级下降多少”。
4.5 加入运动参考,并没有普遍解决实现问题
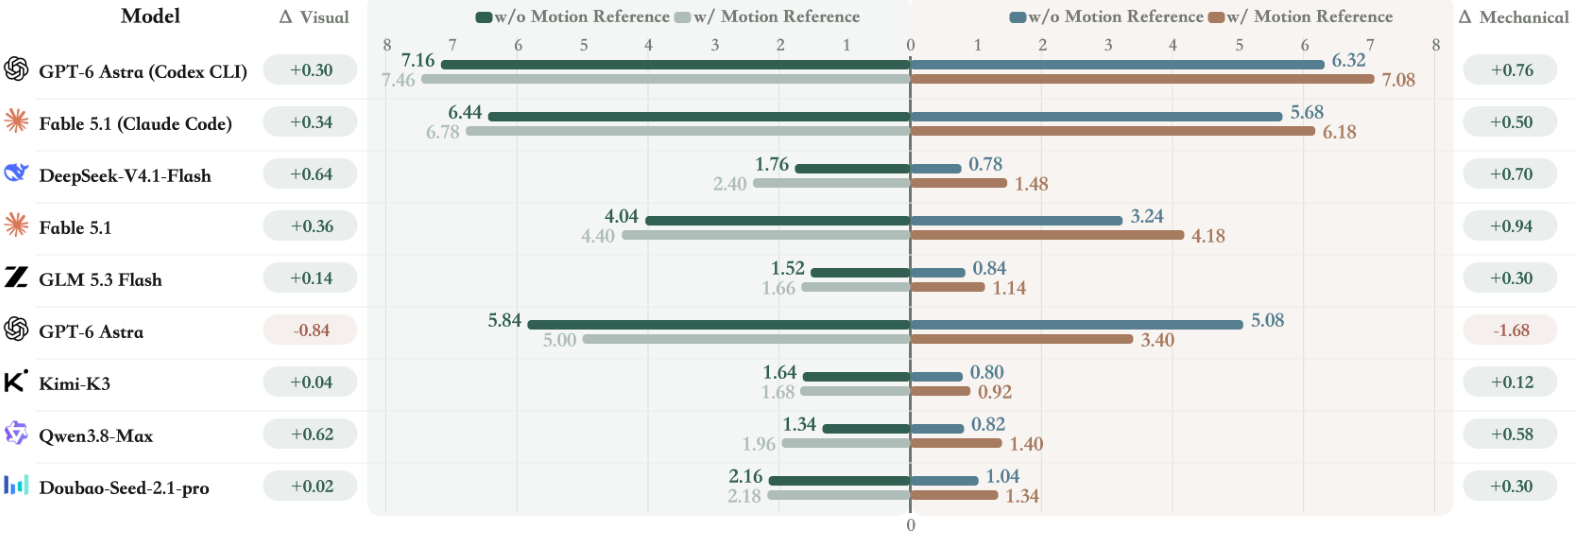
大部分模型的 T1 运动表现有所提高,Astra API 是明显反例。这说明更多观察信息可以帮助一些模型,但还需要把观察落实为结构和约束。不能只保留正向提升,然后总结“补视频就解决了理解问题”。
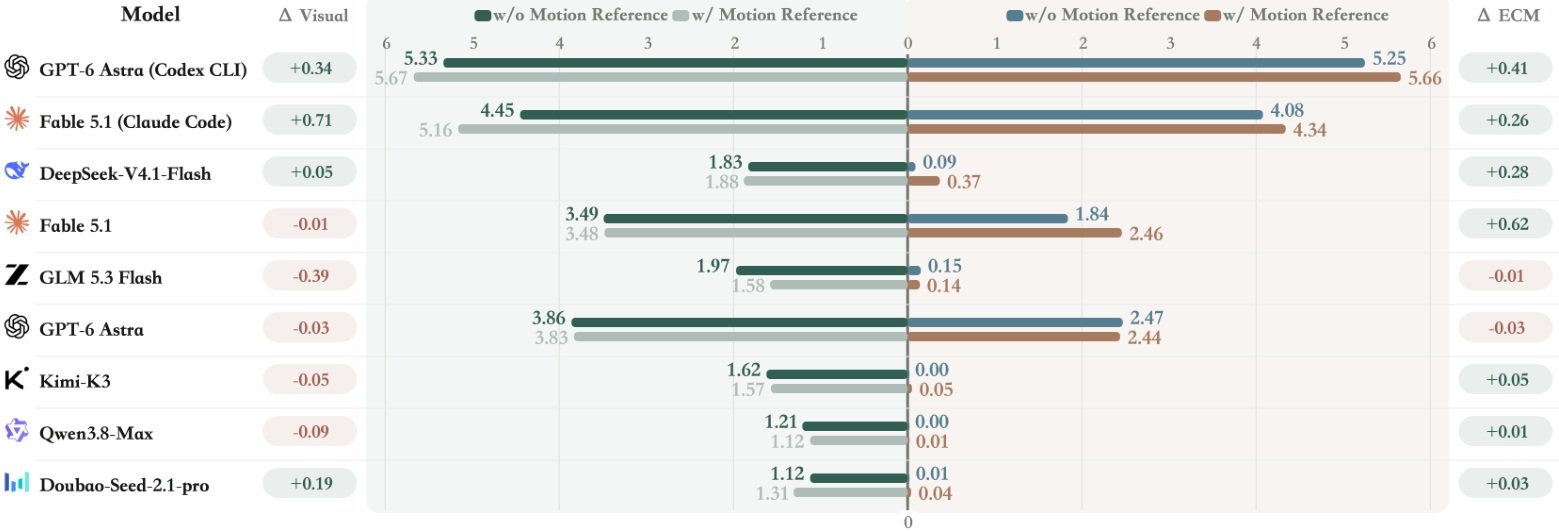
Figure 4 的无运动参考 V 值中,Astra API 为 3.86,DeepSeek 为 1.83,与主表的修复后 V 一致;Figures 3–4 可以据此与主表相应结果对照,但它们没有补齐每种输入设置的执行率、调用预算和重复运行统计。有限改善支持“观察到运动仍难实现机械关系”,还不足以将失败唯一归因于世界理解。
4.6 附录的另外四张表,换了质量均值的分母
Tables 6–9 只对能执行的 API 输出计算质量均值。它们用于区分运行失败和运行后质量,不是主榜单的新版本。随着修复救回更多困难案例,成功执行子集扩大,子集质量均值反而可能下降,这不与全题均值提高矛盾。
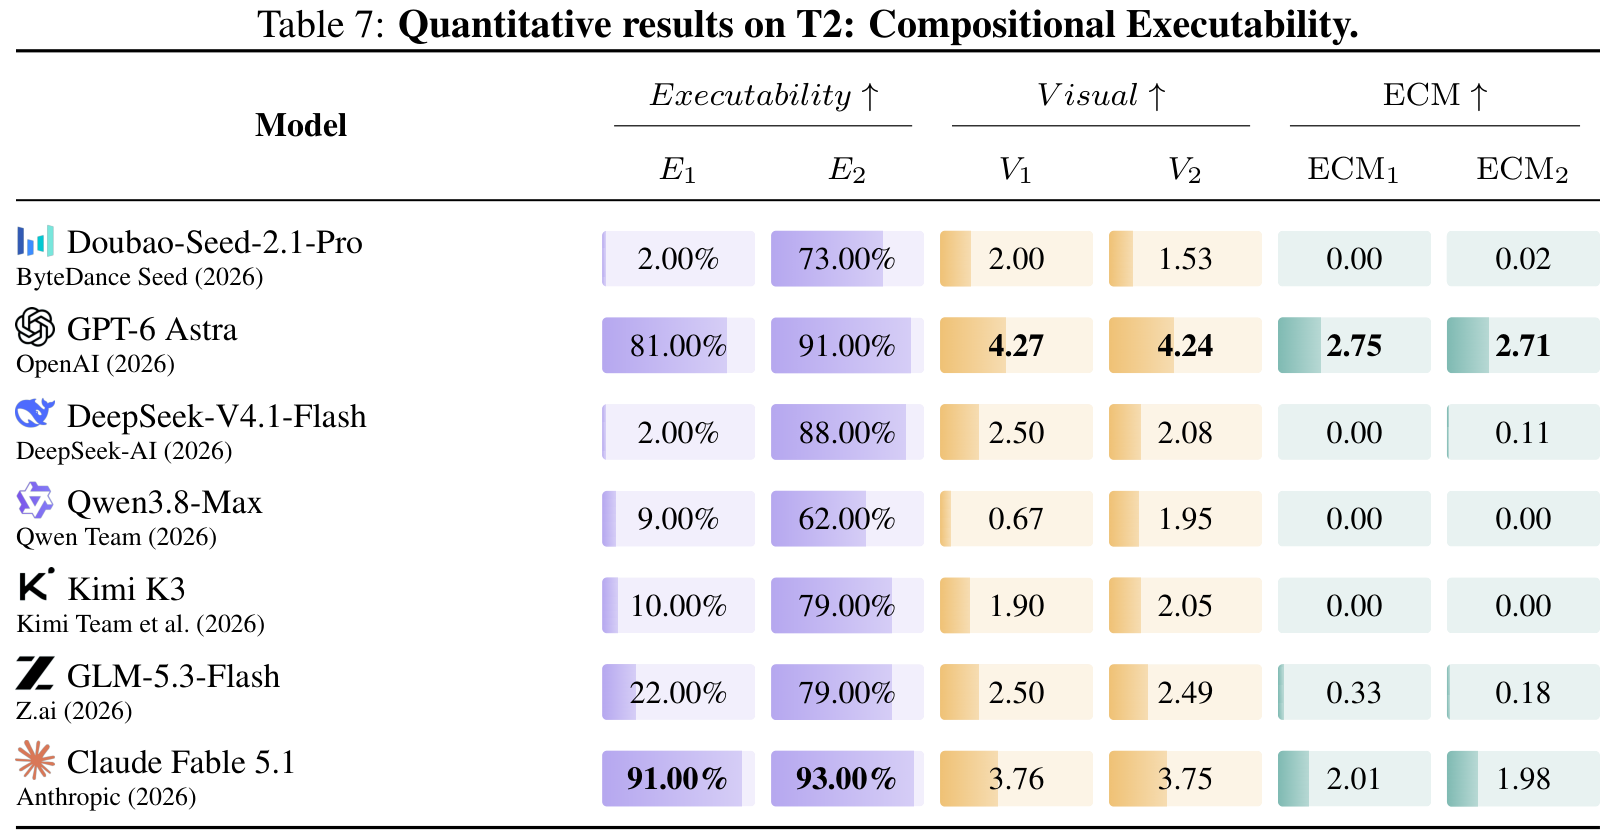
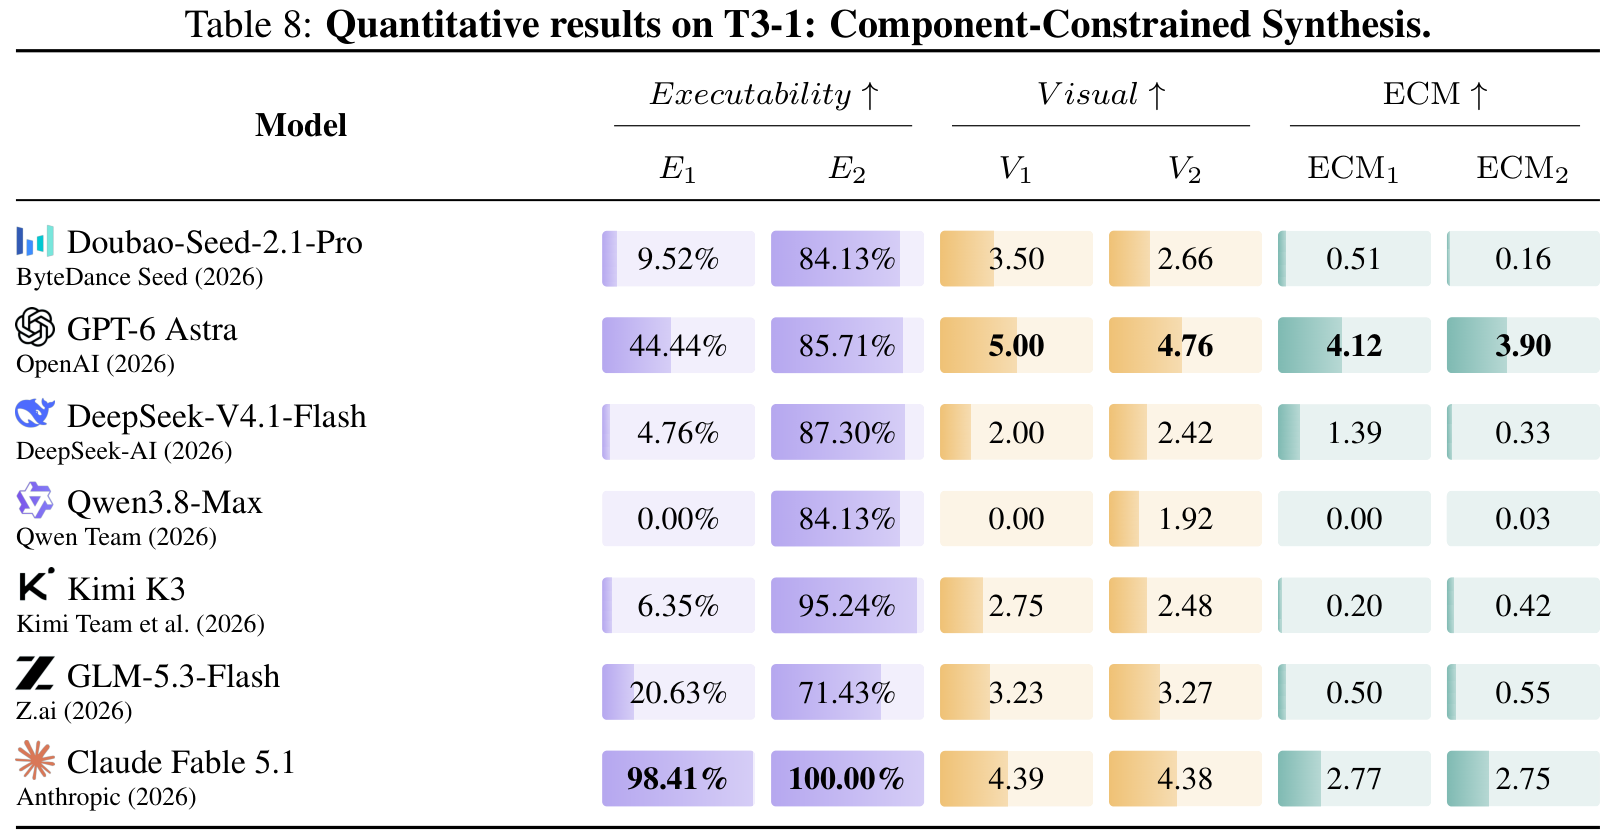
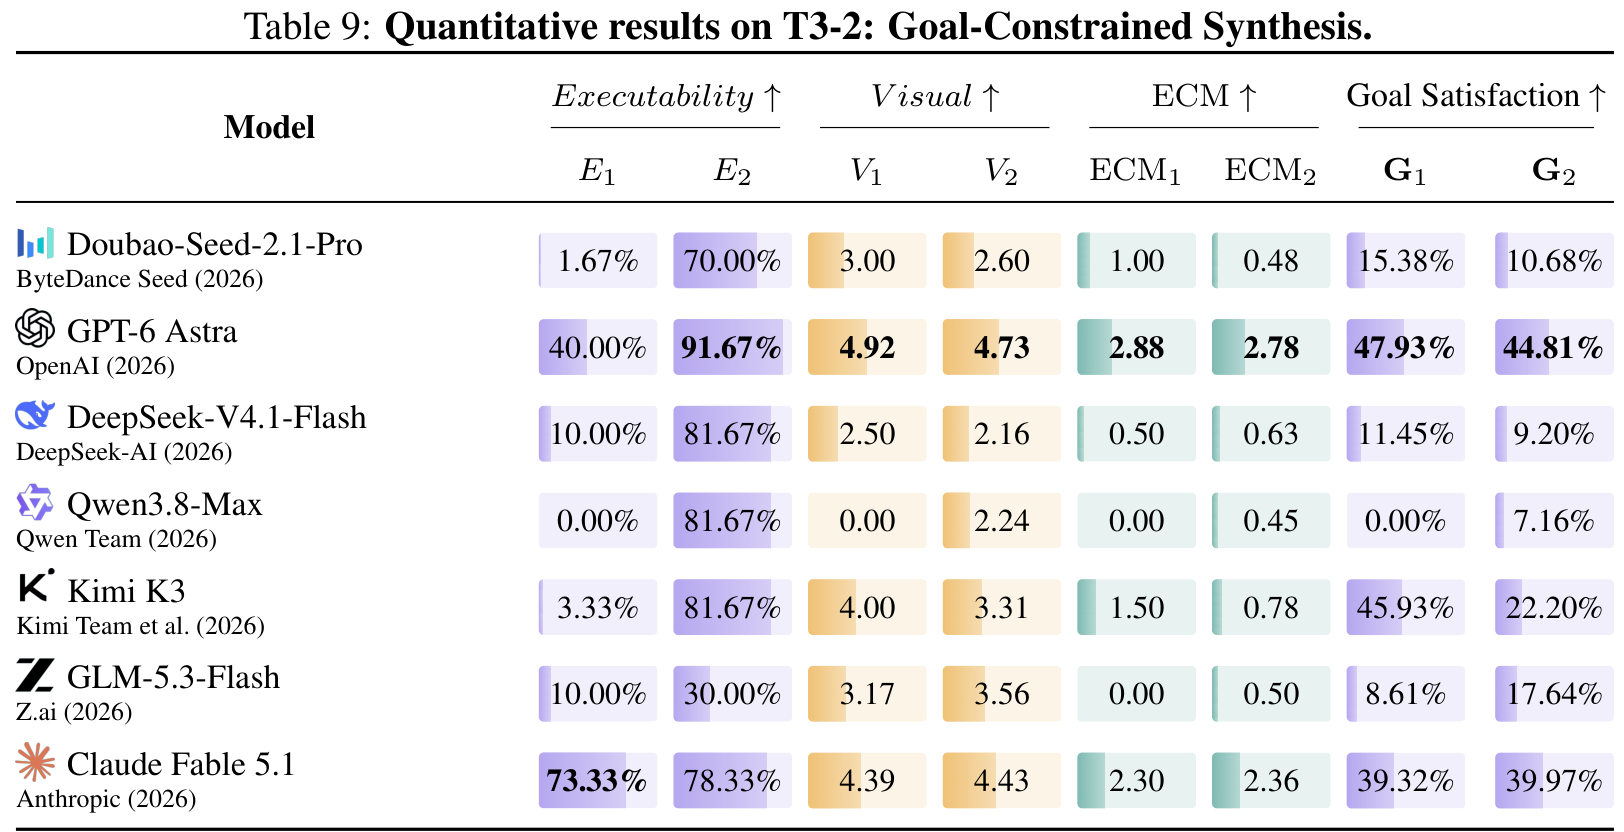
5. Discussion:什么已经说明,什么还值得补实验
这套任务能暴露机械设计失败,但因果验证、预算控制和复现材料仍有缺口。下面的改进建议是本文分析,不是作者已完成的实验。
首先应把视觉和程序证据结合。对 053,程序可以记录物体碰撞几何与共享区的重叠、完全离开时间、object_A 的姿态,以及每次接触;视频继续检验装配和可观察性。再做真实干预:保留初始条件,阻止 A 改变放行机构,检查 B 是否仍自动获准通过。这样才能进一步区分真实机械依赖与按时间播放的伪装。状态检查也可能被生成程序伪报,因此还需要可信引擎读数和故障注入校准,不能仅依赖 Agent 自报日志。
其次应在同一模型上匹配生成预算,分别测试 API 单次、执行错误修复、允许查看渲染的完整 Agent,以及允许修改机制的迭代。记录总 token、Blender 执行次数和耗时,公开每轮修改。当前表格能比较这些系统最终交出的结果,却不能分离模型能力、执行反馈、更多尝试与外部修复各自的贡献。
数据层面可让同一基础机构逐步增加一级、改变高度或球数,再随机生成参数,检验模型能否稳定维持接触和传递。这比仅按现有题目级数分组,更能控制组件分布和难度。也应报告各组样本量,用不同随机种子重复生成,并检查 judge 与人工评分的一致性、已知错误实现的检出率。
若研究“从游戏需求生成代码”,本文最有用的启发是把中间过程是否由正确机制产生也纳入验证:例如最终通关了,但某个门是不是碰到开关才打开,还是被定时脚本绕过。ExeWorldBench 本身没有训练、蒸馏或特权信息实验;这些数据怎样用于训练,仍需另做方法与对照,不能把 benchmark 结果当成某种训练算法的证据。
6. Conclusion:值得读的是任务设计,读分数要带着条件
ExeWorldBench 将机械还原、组合和自主设计放进同一套评测,并展示了运行成功与机械正确性之间的差距。读这篇时,最值得保留的是四种任务的提示边界、真实任务 053 的细致约束、T2/T3-1 的断链记分,以及主表和附录的不同分母。
它也没有完全解决“怎样证明生成世界的物理依赖正确”:VLM 主要看采样帧,T3-2 分段描述与公开输出格式不一致,Rules 到 B 的映射和完整执行程序尚未公开。Codex 的 90.14% 是平均条件满足比例,ECM=5.82 表明中间机械过程仍有明显问题。
本次核查的 GitHub 固定版本包含 README、网页和展示资产,没有批量执行生成任务的程序(runner)、组件库、修复或评分汇总代码;Hugging Face 固定版本公开了任务、生成提示、参考材料和四份评分提示,2117 个文件中未见这些程序脚本。可以按公开提示尝试生成和判分,但还不能完整复现作者的执行与汇总流程。
核查版本:论文 v1(21 页,含附录);GitHub 06bb542;数据 c6dc85e。正文的 9 图、9 表均保留原始内容,Table 图像从许可 PDF 高分辨率裁切。完整证据与图表清单见 source manifest。算术示例可下载 score-example.py;它不是官方评测实现。
留言