一段选座视频里,座位如何排列、地图在什么时候滚动、哪一个座位在什么时候变色,都能写成程序。浏览器执行程序后,又得到可以按时间定位的视频。CodeCap-Bench 就用这种方式检查模型对画面和变化的理解:它写出的程序到底保留了哪些内容?论文同时比较代码与文字描述对下游问答、重建的帮助;这两个问题要分别读。
1. Motivation:让空间和时间变成能执行的规则
代码的价值在于明确画面怎样形成、怎样变化。“座位图向下滚动”没有给出位移和速度曲线;程序可以复用一个绘制函数摆出四列座位,再用时间函数计算滚动量。模型需要识别的是布局规则、运动与状态,而后把这些观察变成可重放的表示。来源:§1、Figure 1。
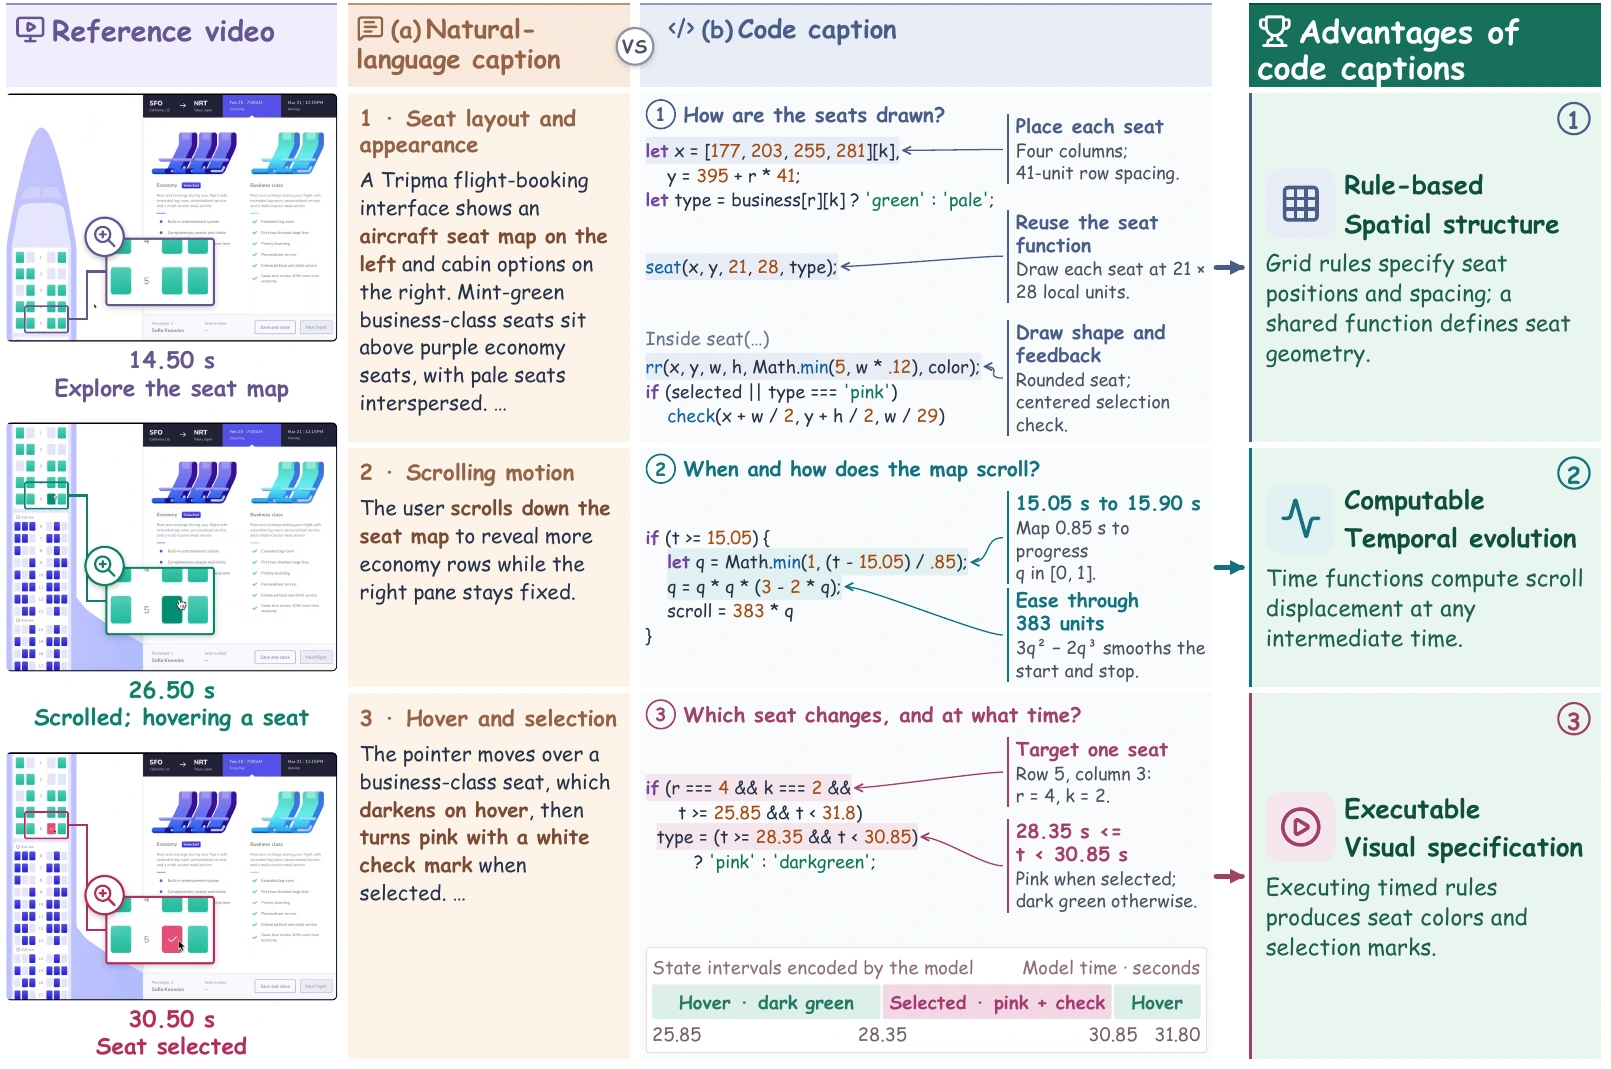
Figure 1 的滚动从 15.05 秒开始,持续 0.85 秒,总位移 383 个局部单位。设 q = min(1, (t − 15.05) / 0.85),在该区间内位移为 383 × q² × (3 − 2q)。在 15.475 秒,q = 0.5,位移为 191.5;这是本文依据原图重算的中点,不是模型新增实测数据。相同的 t 还控制第 5 行第 3 列座位:28.35 至 30.85 秒显示选中的粉色和勾号。这样的表示能同时约束空间、速度与事件。
但写得出函数并不保证函数符合原片。作者因而把两件事分开验证:§4.3.6 比较“代码或文字作为视频描述是否有用”,323 段 CodeCap-Bench 则检验“当前模型能否生成忠实的代码”。不能从下游管线较好直接推断模型已完全理解视频。
2. Related Work:视频重建已有工作,这里扩大了内容与评分层次
CodeCap-Bench 延续了从视觉输入生成程序的路线。其区别是跨五类结构化 2D 视频,除了整体相似度,还检查对象的空间与时间对齐,以及人类指出的关键内容。下面按论文 §2 对邻近工作的介绍比较;各工作的精确分母和隐藏检查协议仍须查其原文,本文不据此宣称统一条件下胜出。
| 工作 | 任务来源与可见输入 | 输出与检查证据 | 与本文的边界 |
|---|---|---|---|
| Animation2Code | CodePen 网页动画;参考视频 | HTML/CSS/JS;外观和时间指标 | 平均 5.1 秒;本集平均 19.0 秒,内容类别更广 |
| BVB | 室内视频;参考画面 | 动画 Blender 场景;时空问答、表示相似度 | 3D 室内程序重建;本文筛选结构化 2D |
| VCode | 静态视觉内容 | SVG 表示;CodeVQA 检查语义保留 | 提供代码表示的先例,本文进一步检验时间演化 |
| IWR-Bench / WebVR / Video2Code | 用户操作网页的视频 | 交互网页;外观、状态或功能检查 | 还原网页交互,与按原时间线重放全部视频的任务不同 |
| CodeCap-Bench | 四个公开平台筛出的 323 段;Agent 观察原片 | 单文件网页渲染视频;整体特征、对象框、关键点评分 | 对象/关键点先视频内再跨视频平均;人工标签在评测侧 |
自然语言视频描述的 VDCscore、VidCapBench、CapQuiz 等也已从字符串相似度转向问答或具体属性。本文改变的是待评价的产物:它先执行代码得到视频,再比较可见内容。其“代码作为视频描述”主张有这些先例,不能写成首次用代码保存视觉信息。来源:§2,参考文献 [11,14,19,22,36,46]。
3. Benchmark / Protocol:从标注视频到一个可解释的分数
3.1 作者怎样构建任务和标签
作者从 Bilibili、YouTube、Behance、Vimeo 收集候选视频,按场景几何、外观复杂度和运动结构筛选。入选内容主要由 2D 布局、形状、文字和显式对象轨迹构成;复杂 3D 视角、细密纹理、密集粒子或像素变化被排除。五类分别是桌面/应用界面、2D 游戏、视觉设计/媒体动画、数据/科学可视化、图标/抽象动态图形。来源:§3.3。
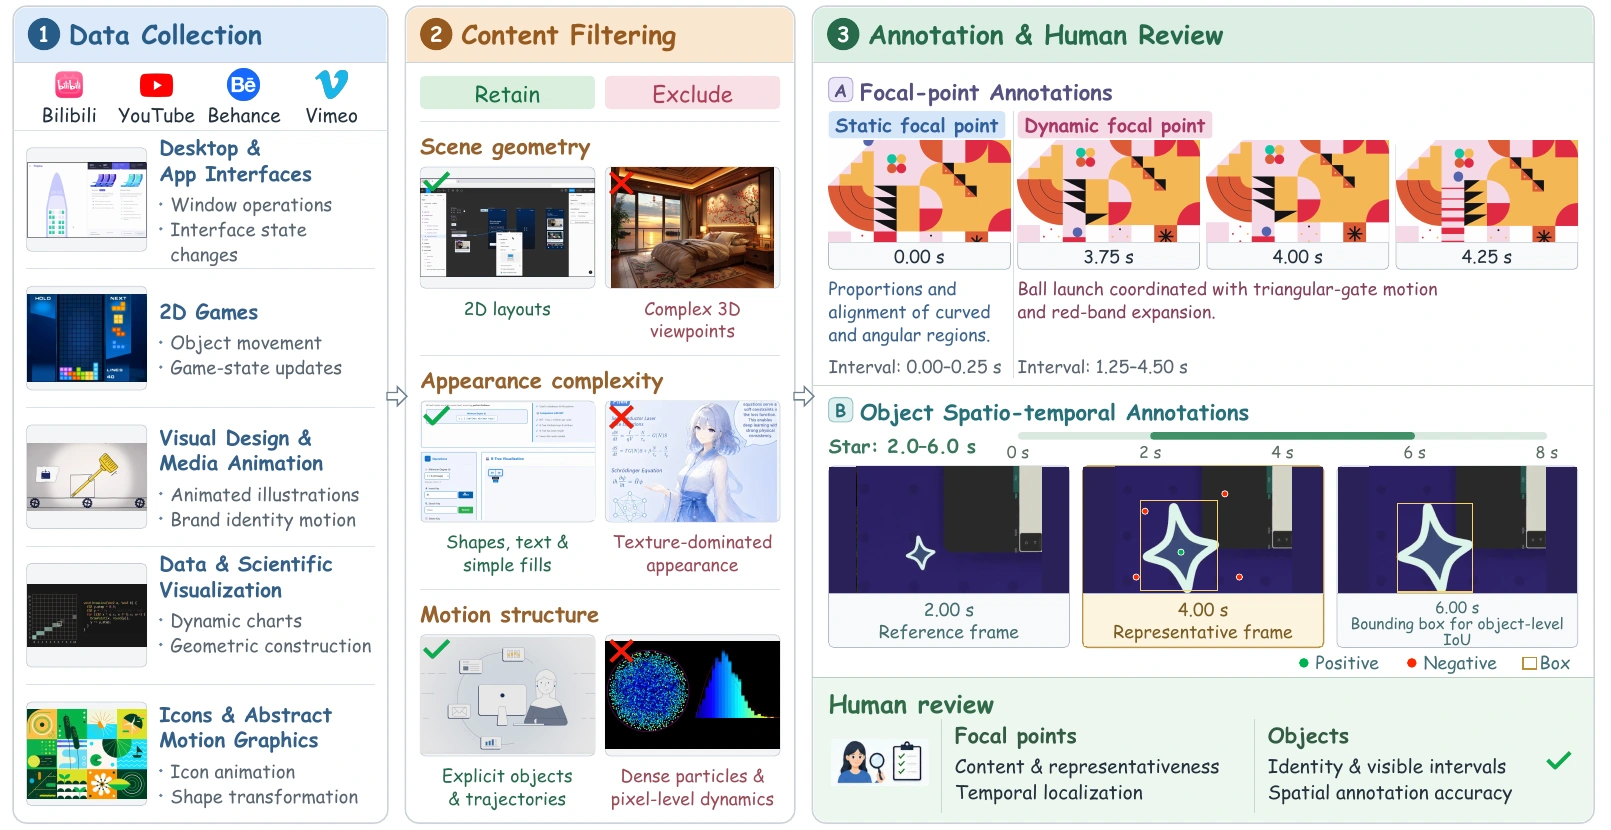
作者给每段视频两类标签。一类是 focal point,即带文字描述和原片时间范围的关键内容,例如几何区域的比例,或球发射时与三角门、红带的协同运动。另一类记录关键对象的可见区间和逐帧包围框。空间标签借助代表帧的框与正负点提示,引导视频分割;全部标签经过人工复核和修正,检查描述、时间定位、对象身份与边界。§3.3 没有明确交代关键点文字初稿由谁生成,也没有报告标注者人数或标注者间一致性。
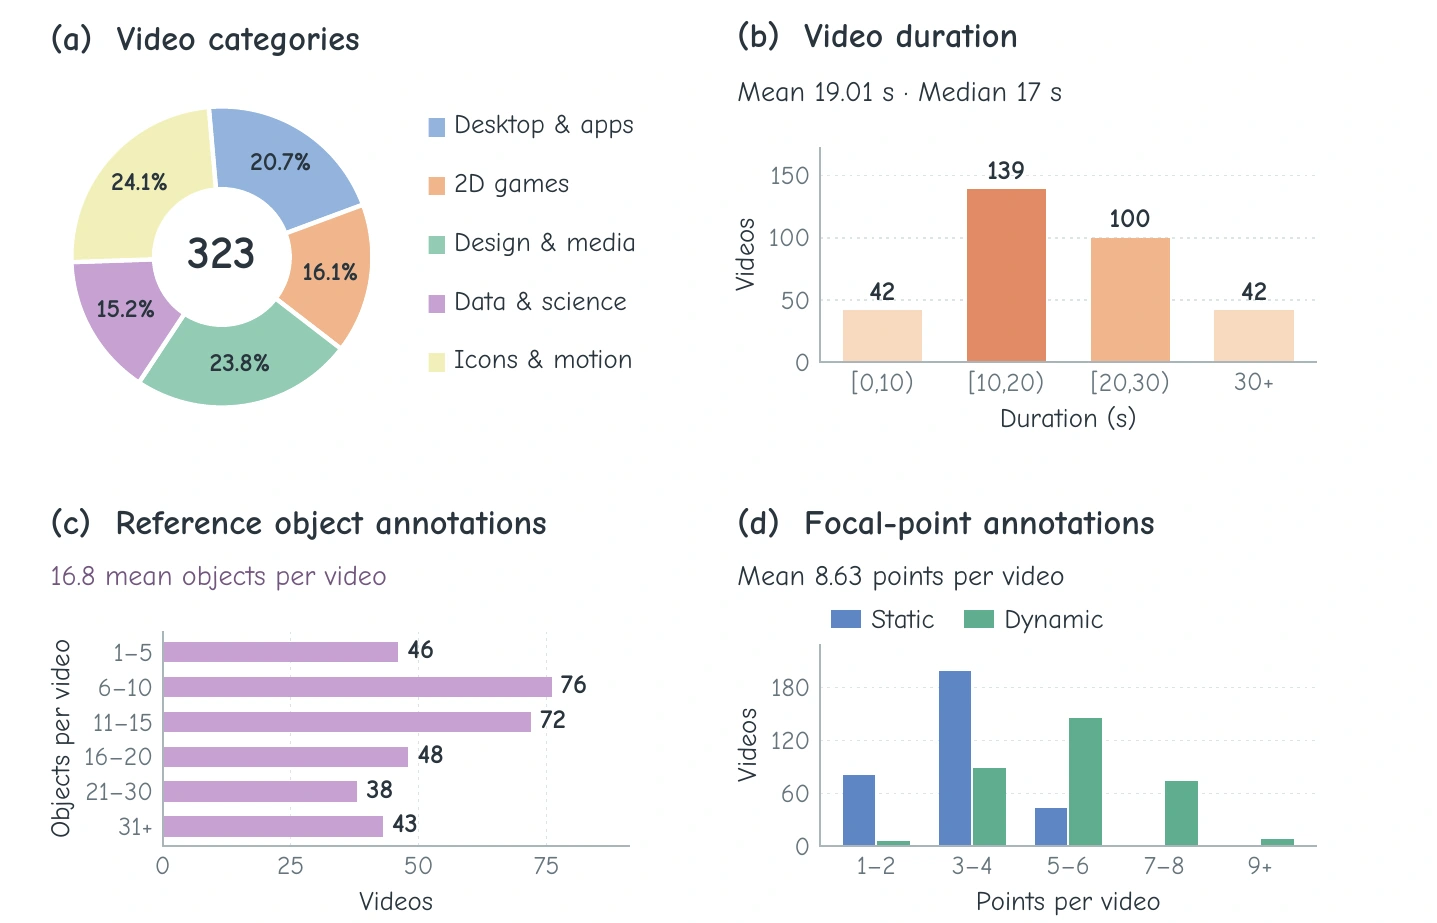
全 323 段的平均时长 19.0 秒,median 17.0;平均每段 16.8 个标注对象、8.6 个静态加动态关键点。关键点时间范围平均 3.3 秒,median 1.8。公开来源不自动排除预训练见过视频的风险。论文没有给出完整候选池大小、筛选淘汰率、训练/测试切分或系统去污染结果;不能把这些未知写成已保证的独立测试。
补充:完整视频、对象与关键点分布
3.2 Agent 看什么、可以做什么、最后交什么
Agent 通过 Pi Agent、Codex 或 Claude Code 运行在隔离容器中。它可以读原视频,自选时间抽帧,使用 ffmpeg/ffprobe、Python、Node、Chromium 和 Playwright 分析、写代码、渲染和比较,再修改。这里的 harness 是运行编码模型并提供文件与工具操作的环境,论文用的是完整编程代理栈。作者没有给模型训练新策略;这些是测试时的观察和修复步骤。
生成提示词要求所有视觉内容用 DOM/CSS、Canvas、内联 SVG 或程序化 WebGL 画出。参考视频和抽帧仅供观察;不能把截图、视频、下载图像、外部字体、Base64、像素数组或自动描摹结果作为成品素材。模型可以用系统字体,并需从真实字符串渲染文字。直接联网与安装新依赖不可用。人类关键点和对象标签用于判分,未列入生成提示词的可见输入。来源:Appendix C.1。
最后只交一个自包含 index.html,在仅含该文件的隔离环境中运行。页面暴露 seek(seconds),即暂停播放并把画面重画到共享时间线上的指定秒数;重复调用同一时刻、先看晚时刻再看早时刻,都应可靠。外部渲染过程在每 1/24 秒调用这个接口、截图,编码为 24 fps 的成品视频。生成限时每视频 3600 秒;Qwen3.8-max 的 xhigh 放宽到 7200 秒;单次渲染另限 900 秒。
补充:实验栈版本和单次生成对照
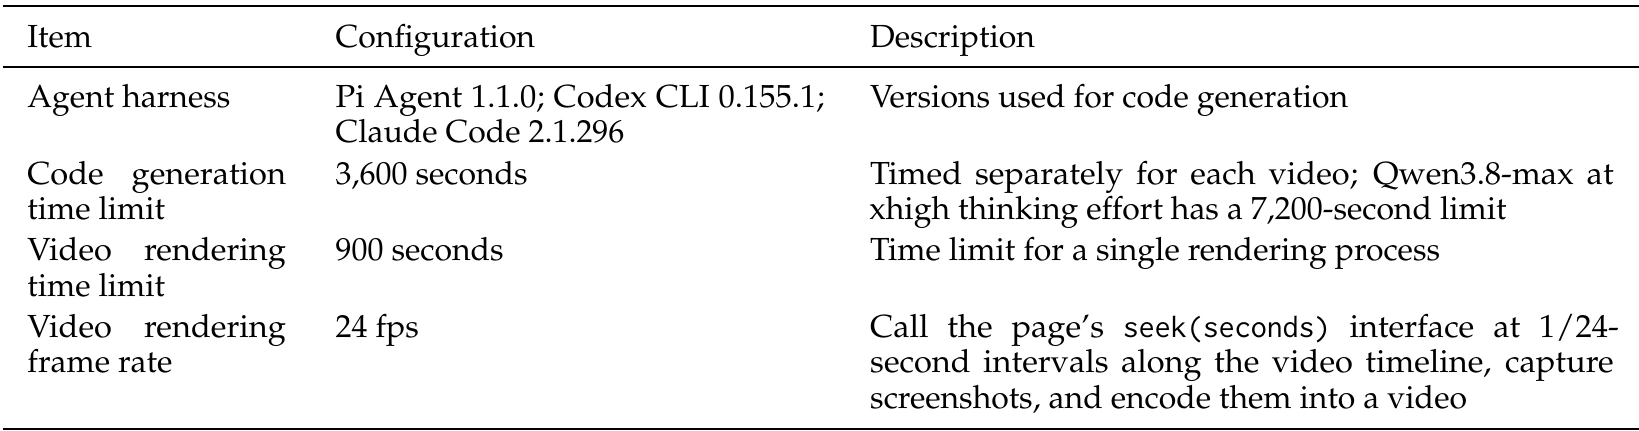
无工具单次生成直接收到 2 fps 均匀采样帧、时间戳、尺寸与时长,输出 HTML;没有试运行和渲染反馈。GPT 超过 50 张图的 API 限制时,把所有采样帧放入有时间顺序的拼图,其他模型直接收图。Agent 则自主选帧。两组观察方式和计算预算不同,因此表中差值不能当作只替换 harness 的等预算因果效应。
3.3 一份成品如何被执行和评分
先将 HTML 渲染成视频。如果未能产生视频,所有质量分记 0,失败任务仍在全部任务的分母里。video production success rate 是成功生成渲染视频的任务比例,不能理解为还原质量达标的比例。论文没有另设“忠实还原 PASS”的二元阈值。成功产出的成品继续经过三种互补检查。来源:§3.2、§4.1。
Visual similarity 是原视频与成品视频的整体特征余弦相似度:相同时间采样和预处理,经 V-JEPA 2.1 ViT-Gigantic-384 提取视频表示,再计算相似度。它覆盖外观与运动的整体特征,高分仍可能掩盖局部事件或指针时间的错误。
Object-level spatio-temporal IoU 检查对象逐帧的框是否对齐。GPT-6-sol 对每个参考对象寻找成品中的对应对象、可见时间和代表帧,给出框与正负点提示;SAM 3.1 据此分割,提取逐帧框,再与参考标注比较。框的 IoU 是交集面积除以并集面积。对象分在“原视频或成品至少一方可见”的帧上平均;成品完全缺失对象得 0。然后先平均当前视频的对象分,再平均全部视频,避免对象多的视频自动权重更大。
对象分 = Σ共同时间线上的 IoU / 至少一方可见的帧数
总对象分 = mean_video(mean_object(对象分))
例如三个并集可见帧的 IoU 分别为 1、0.5、0,第三帧只在参考视频可见,则对象分是 (1 + 0.5 + 0) / 3 = 0.5。若把缺失帧删掉会错误变成 0.75。这是本文按规则写的算例,未运行官方分割或评测代码。
Fine-grained visual information retention 是评测模型对每个关键内容的忠实程度评分。GPT-6-sol 收到原片对应片段、关键点文字和完整成品视频,逐关键点输出整数 0 至 5。静态点查内容、外观、布局和关系;动态点查起态、中间步骤、顺序、节奏、时长、协同及结果。分数先在视频内平均,再在视频间平均;静态和动态另报。Table 1 用 0 至 100 尺度展示保留分,但 §3.2 未显式写出 0 至 5 到展示尺度的转换式。Overall 也不能由两列简单平均,关键点数量不同。
Appendix C.3 的 5 表示相关内容与过程完整准确;3 要求核心关系、关键步骤和主节奏仍正确;2 只要求至少一个实质局部完整。纯动态点若只有静态终态、没有动作过程,得 0;明显改变主要时间位置、节奏或同步,最多 2。轻微整体时间偏移仅在主要节奏与事件关系保存时可算小差别。判分查完整成品以找到对应过程,并不等于允许随意移动事件。
3.4 真实案例:气泡图的滑块提前一年
论文 Figure 9 展示作者选取的真实 GPT-6-astra + Codex 执行轨迹。Agent 的输入是气泡图视频;需复现固定软件界面、移动气泡、年份和指针。它首先看 0、10、24.96 秒等帧,将固定界面与动态对象分开。随后用 OpenCV 按颜色区域拟合气泡中心和半径,比较相邻帧年份区域的像素变化,用模板匹配追踪指针。测得的轨迹与切换时间被写入动画并同步。
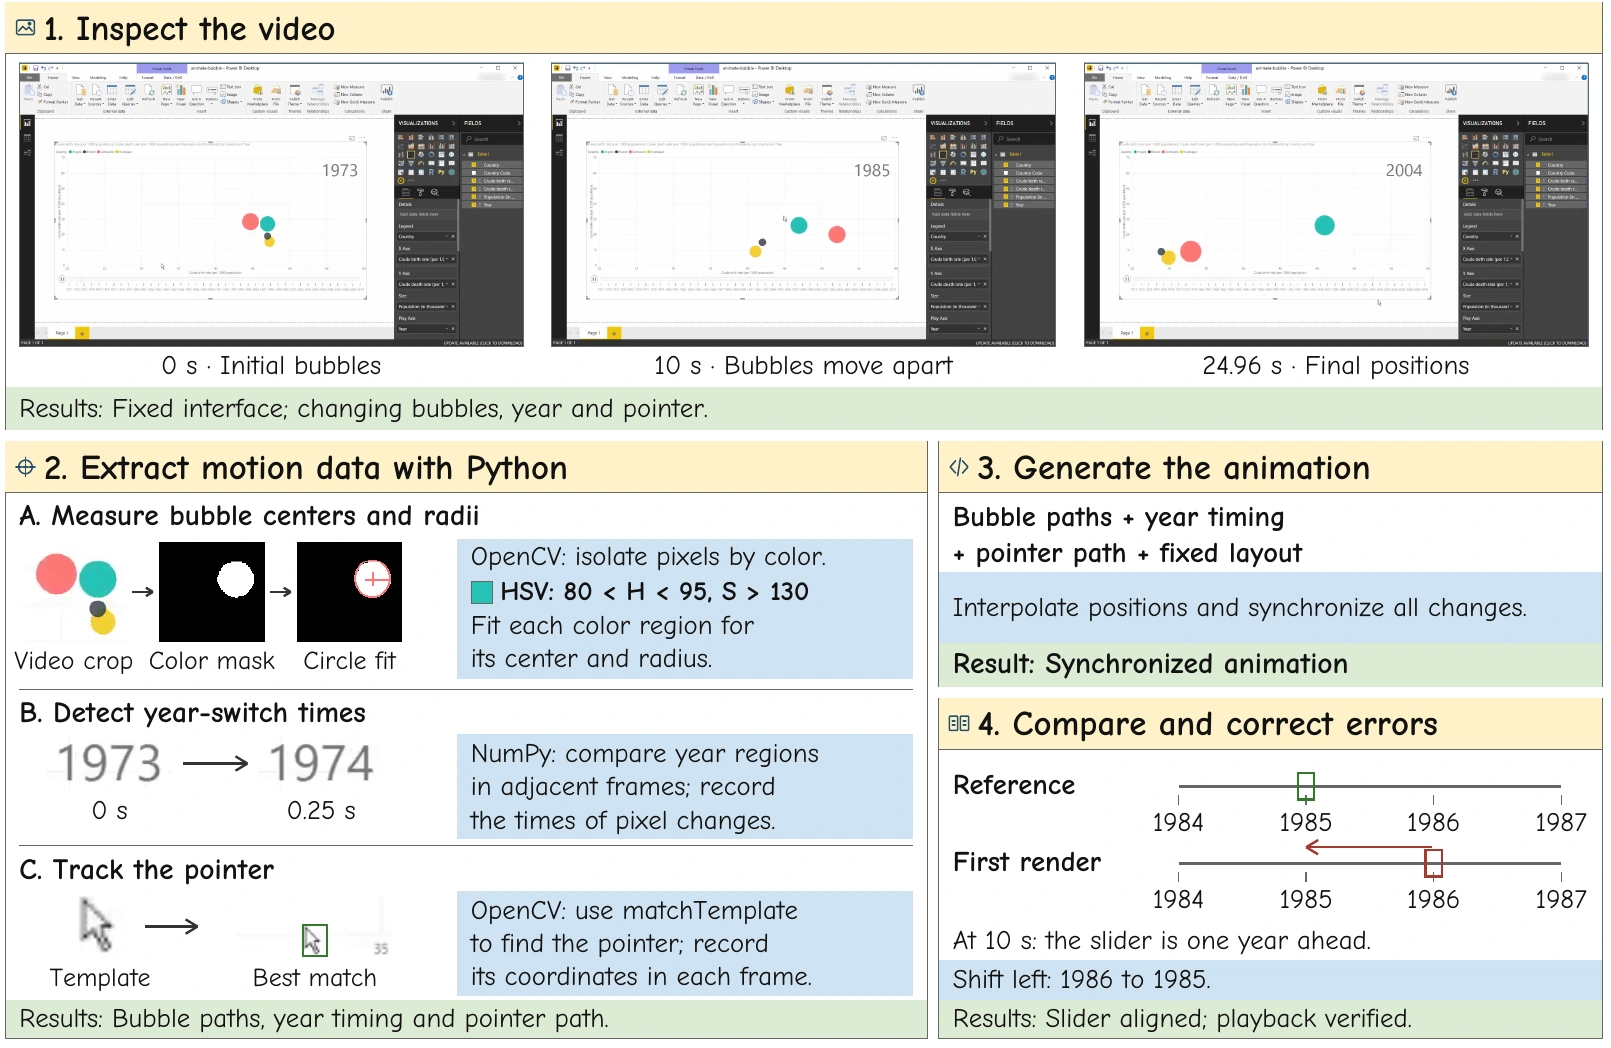
首次渲染后,Agent 在 10 秒处比较对应帧,发现滑块比原片快了一年,把 1986 左移回 1985,并验证播放。这里能直接确认的是一次具体观察、实现和修正。论文没有给出该 case 的完整代码、逐对象框或关键点官方得分;“修正后验证播放”不能写成获得全部评测满分。假如年份切换与气泡运动仍明显不同步,按 C.3 的规则会限制相关动态点得分,但本文未把这一推导当成实际判分日志。
2026-10-28 检查官方项目页,Code 与 Dataset 按钮仍为未启用状态,页面写着“Links coming soon”。因此能核实的是公开提示词、公式描述与 Figure 9 轨迹,官方 checker、逐题数据和资源禁用的实际执行代码尚不可检查。下文没有将本文算例冒充官方评测器。
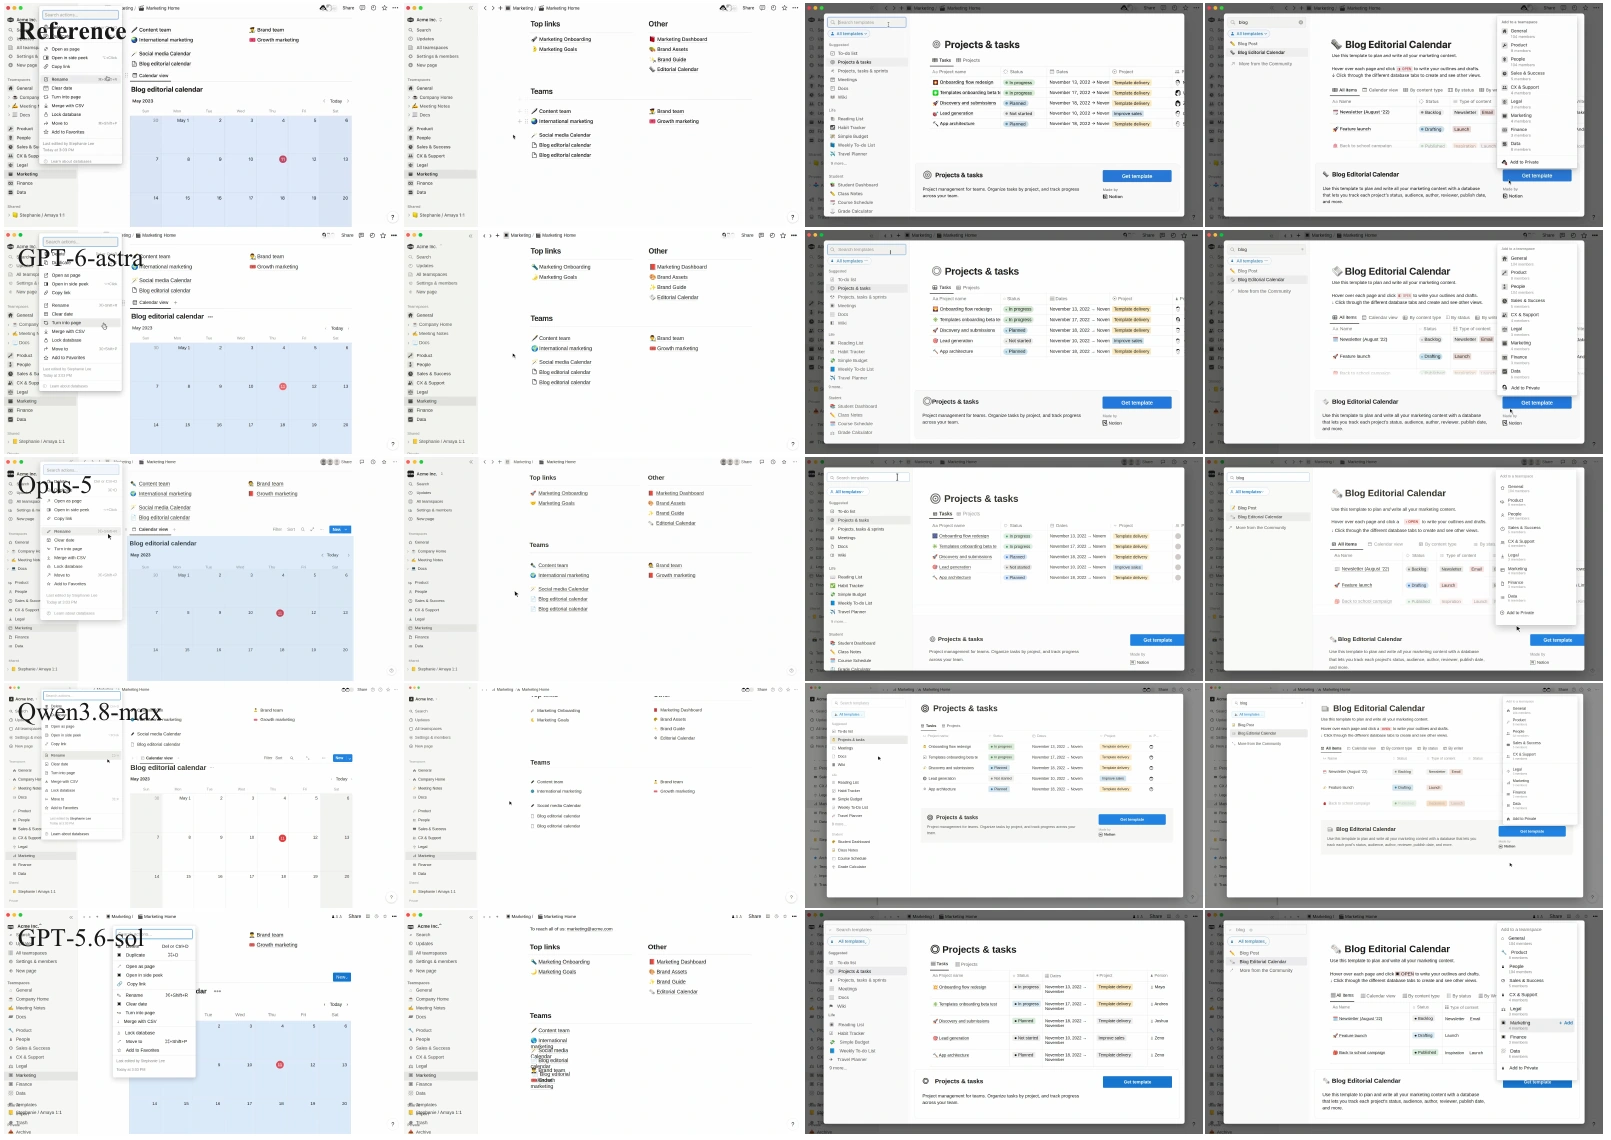
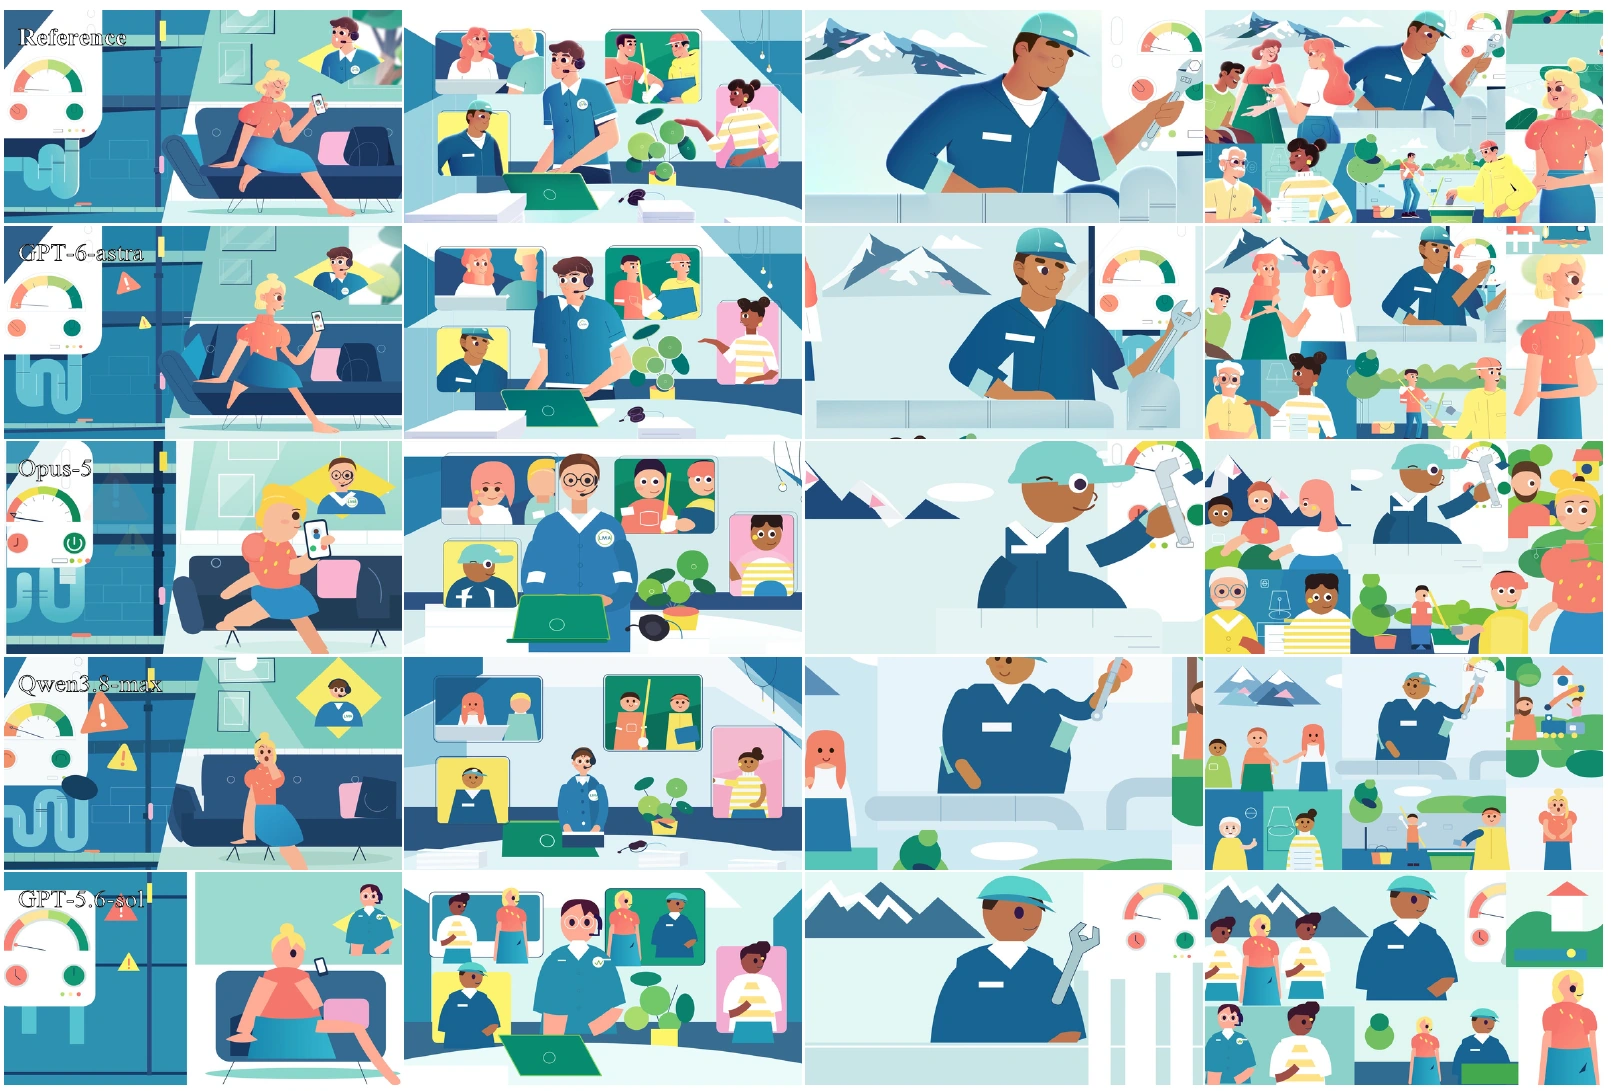
补充:另一个真实游戏案例及四类附录对照
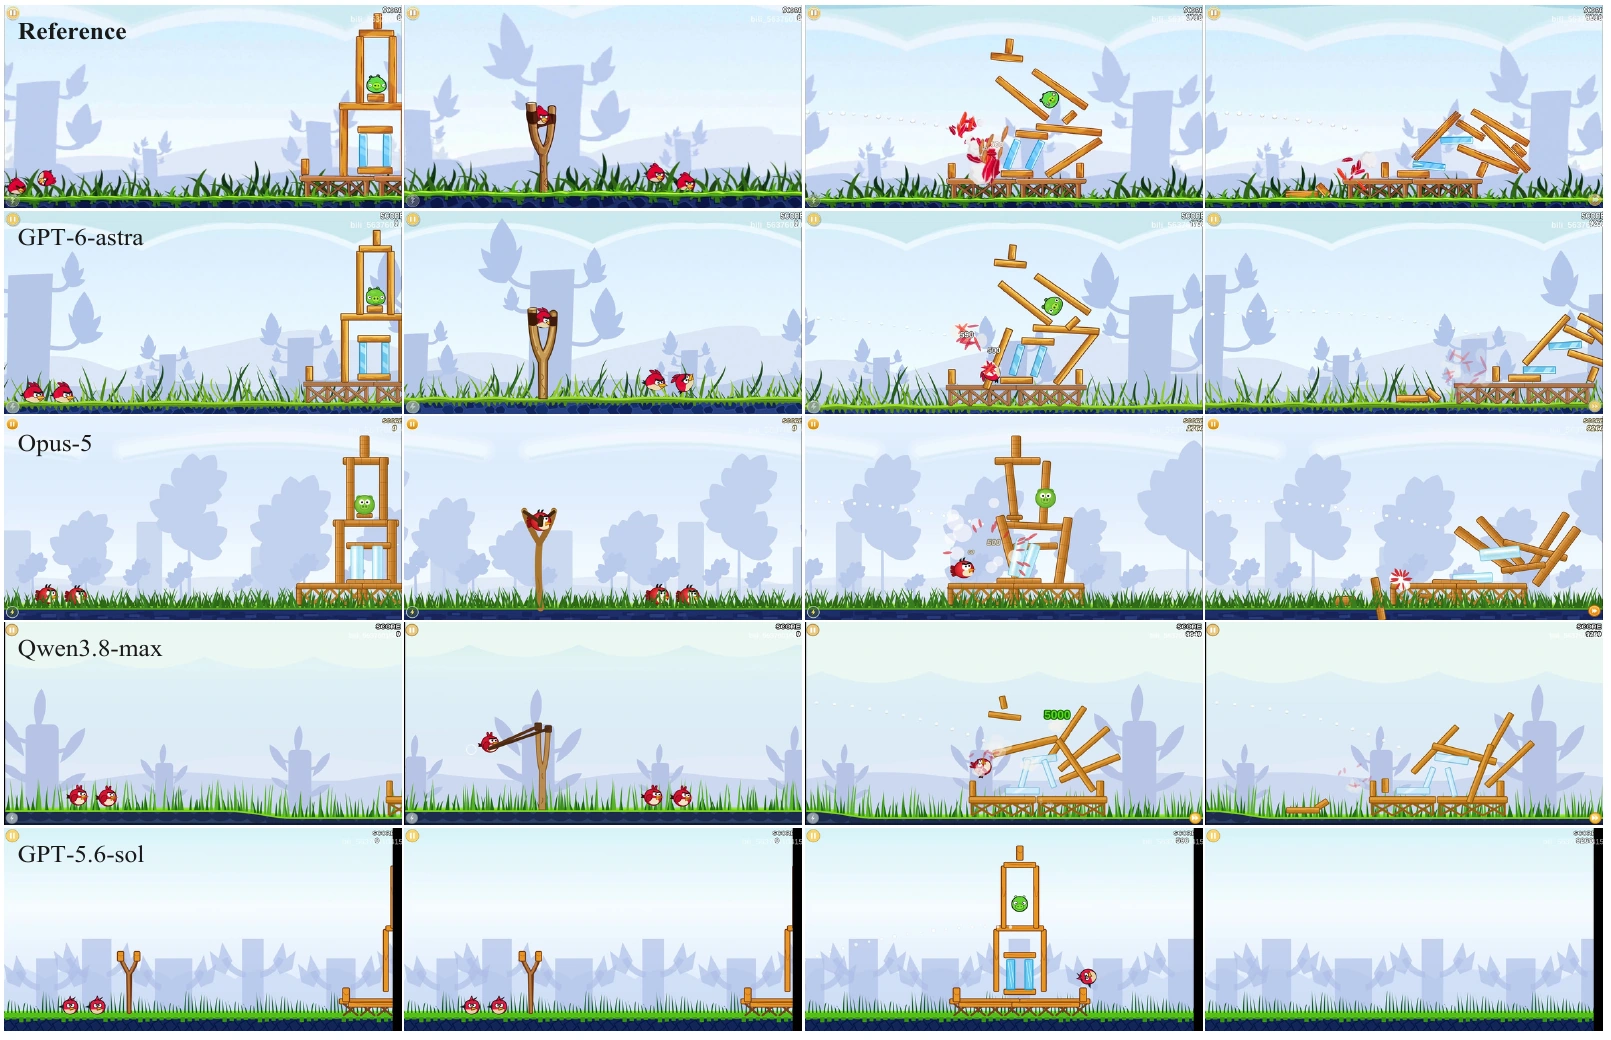
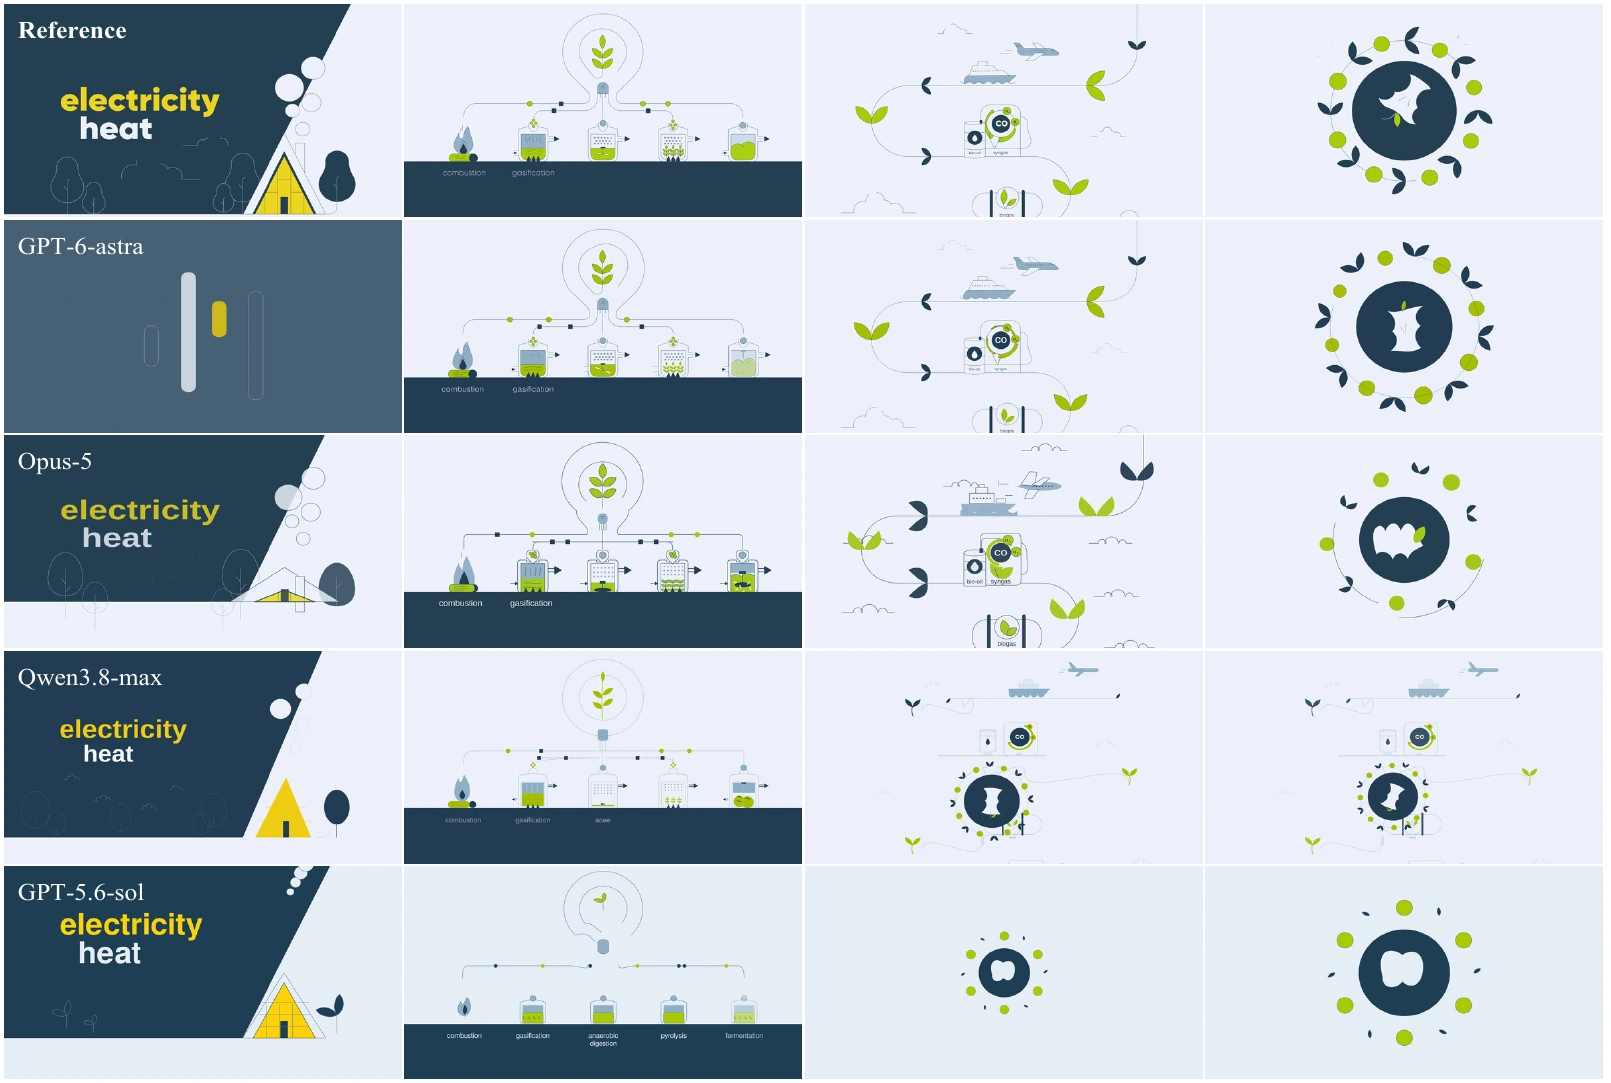
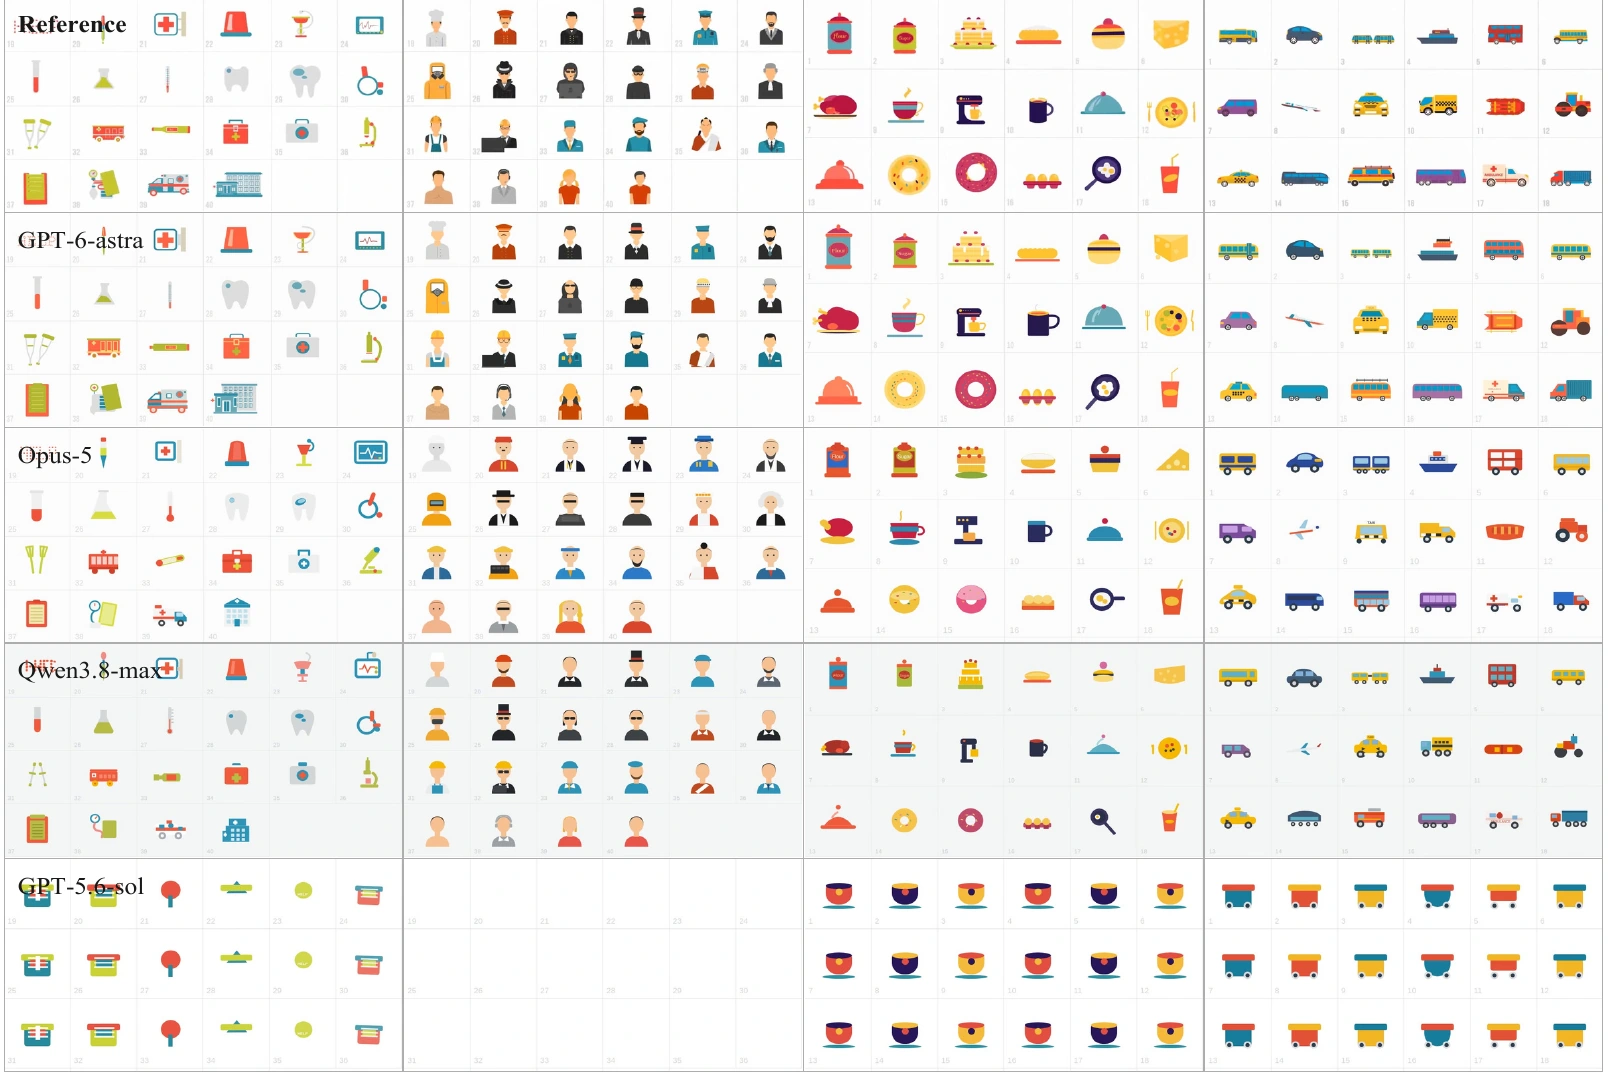
Appendix D 的五个案例都按相同时间与裁切区比较:从上到下是参考、GPT-6-astra、Opus-5、Qwen3.8-max、GPT-5.6-sol,使用 Pi Agent。Figure 12 的 3.1、5.0、8.0、13.4 秒展示发射、碰撞与倒塌;最后一行在 8 秒仍出现近完整立柱,而参考已在倒塌,可见阶段错位。本文据原图观察,没有为该片补造数值得分,也没有把视频重放当成可操作游戏的物理规则测试。
3.5 判分器校准能证明多少
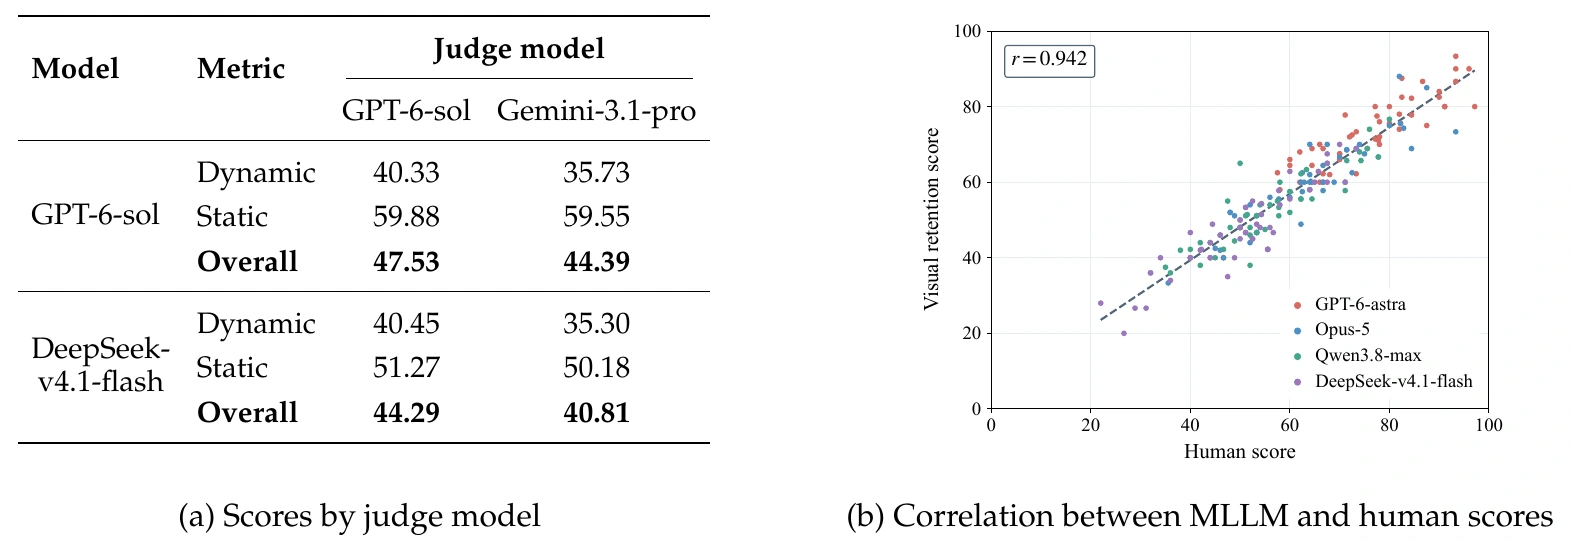
50 个参考视频每类取 10 个,比较四个 Pi Agent 模型的生成视频。人类使用同样的 0 至 5 关键点评分,聚合成视频级分后,与 GPT-6-sol 的对应分数得到 Pearson r = 0.942。它支持视频级排序与人类判断较一致,未证明每个短事件或每个对象都判对。另一个双 judge 比较只覆盖 GPT-6-sol、DeepSeek-v4.1-flash 两种生成模型;GPT-6-sol 与 Gemini-3.1-pro-preview 排序相同但绝对分数不同,输入方式也有差别,不能据此宣称整个榜单完全无 judge 偏差。来源:§4.3.4。
补充:两种 judge 的分数与人工相关散点
4. Experiments:动态难,Agent 的质量收益并不稳定
4.1 先看完整主表,再区分成功和质量
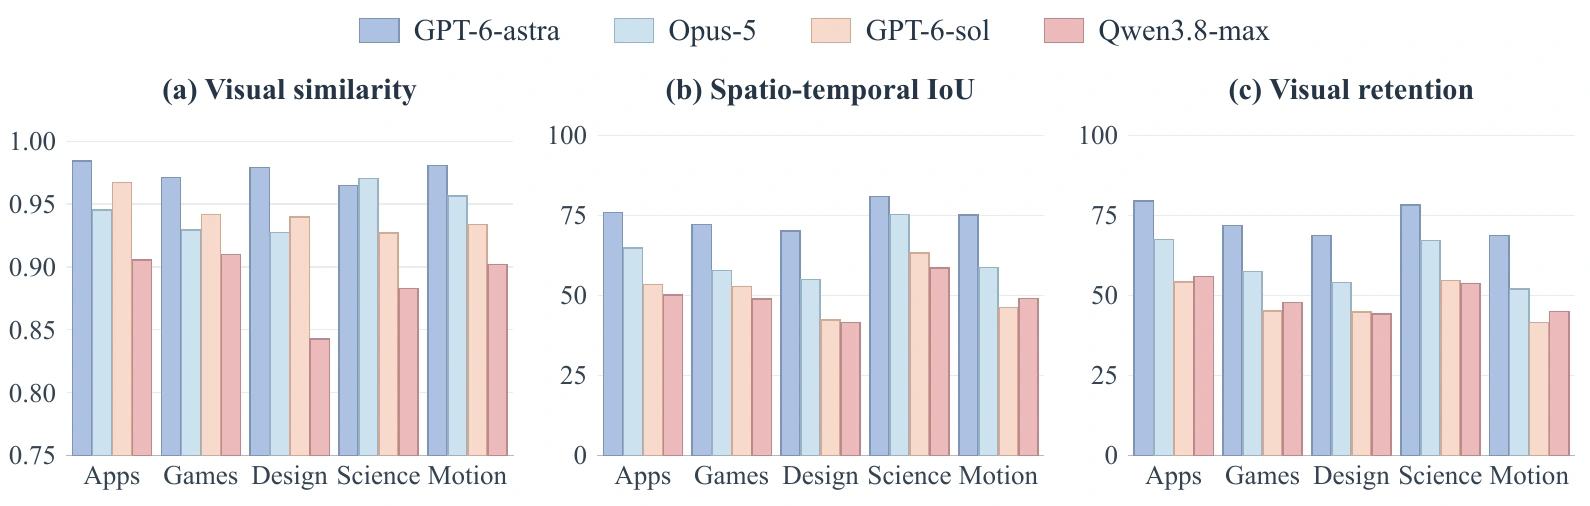
Table 1 全部配置为 medium thinking effort,评测 7 个模型的 Agent 或单次生成设置。GPT-6-astra + Codex 的整体保留 73.24、对象 IoU 75.37,较 Opus-5 + Pi 的保留 58.84 高 14.40 点。GPT-6-sol + Codex 虽 323 段全部产出视频,保留却为 51.34。动态点在每种配置下都低于静态点:Astra + Codex 是 68.61 对 80.72,GPT-6-sol + Codex 是 43.92 对 64.04。
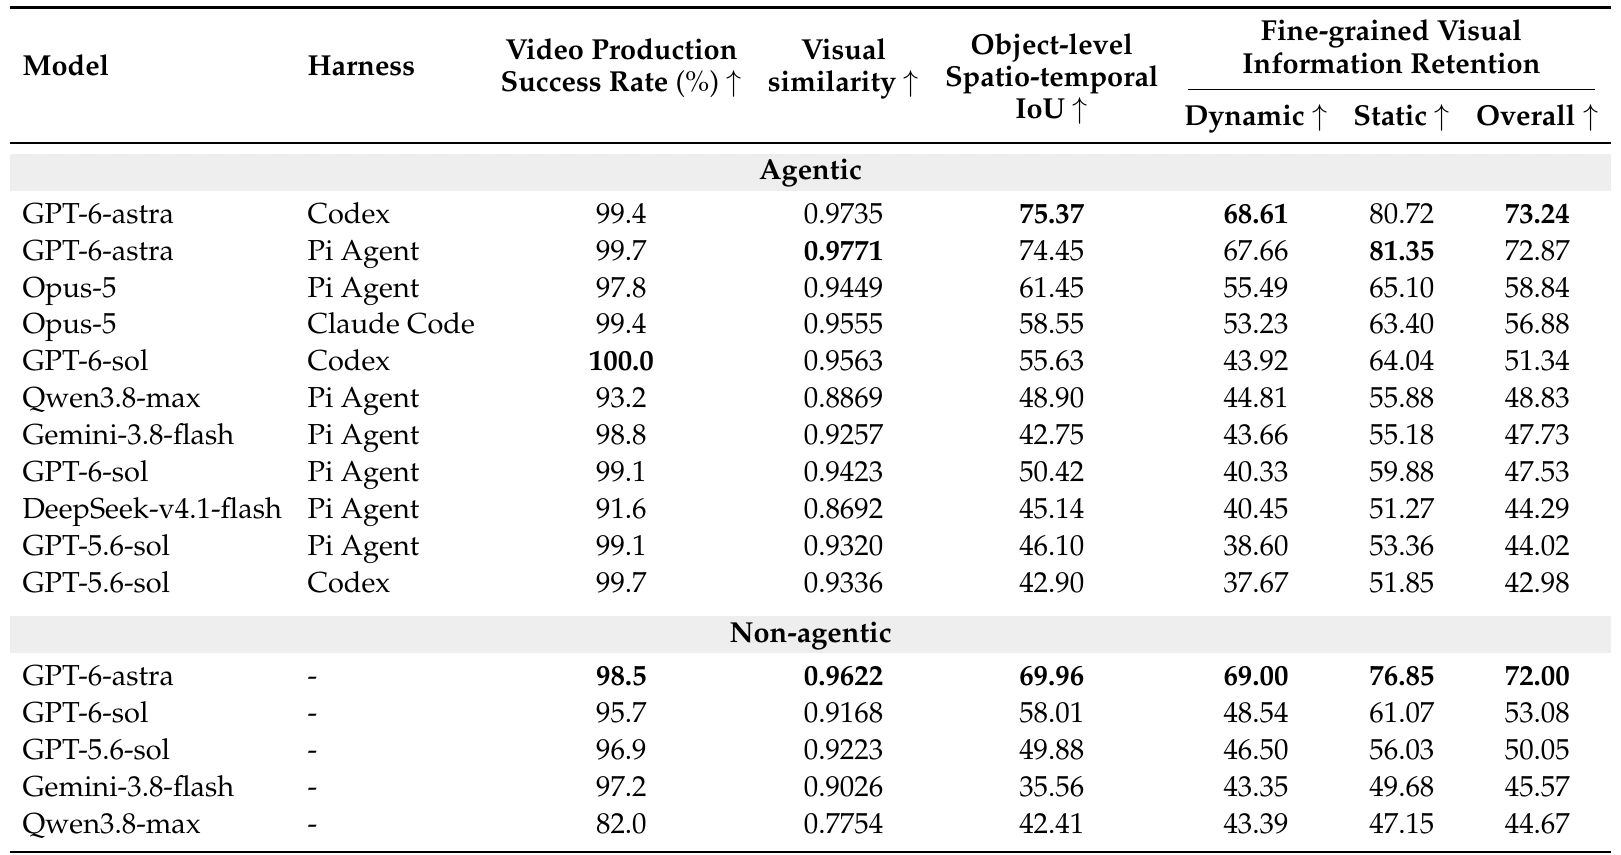
多轮工具主要稳定提高视频产出成功率,质量收益因模型而异。Qwen + Pi 的成功率从单次生成 82.0% 到 93.2%,整体保留 44.67 到 48.83;GPT-6-sol 的单次保留为 53.08,却高于 Codex 的 51.34 和 Pi 的 47.53。GPT-5.6-sol 单次 50.05,也高于 Pi 44.02、Codex 42.98。这组反例限制了“只要加视觉反馈就更忠实”的说法。输入帧和预算的差别前面已说明,论文也未报告多次随机种子的均值、方差或置信区间;小分差需谨慎解释。
补充:分类型结果与 67 次失败的原因
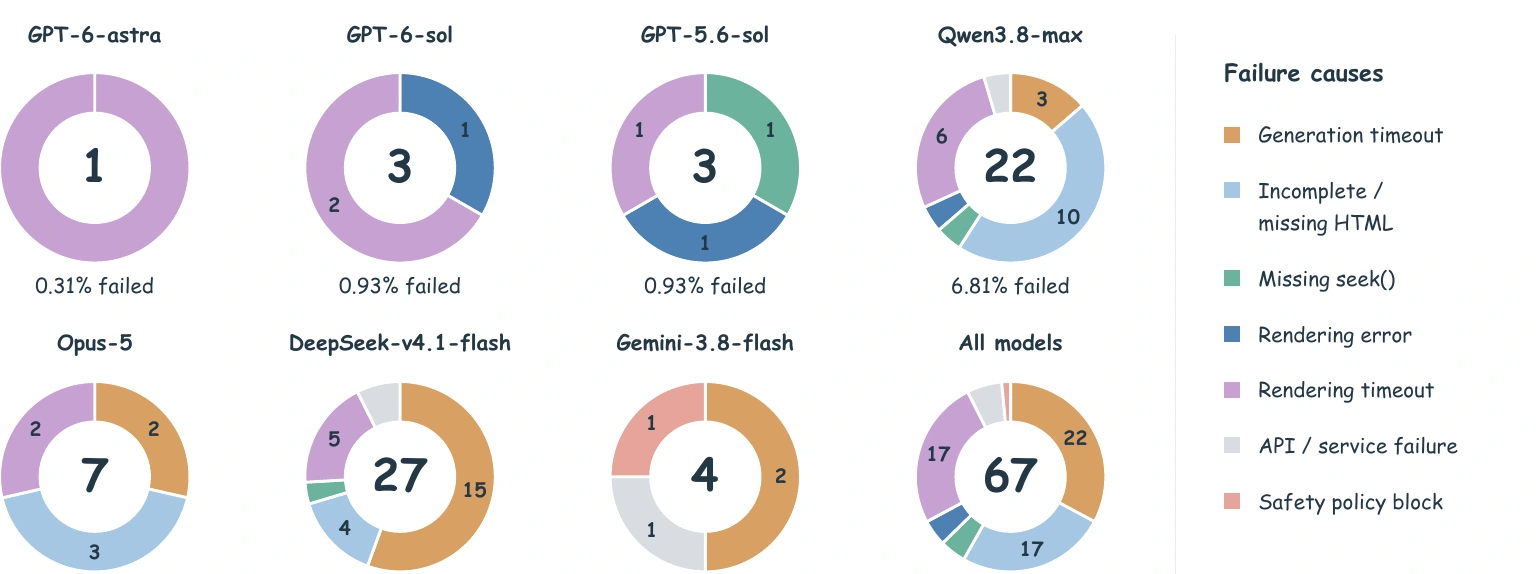
代码生成超时、HTML 缺失/不完整、渲染超时合计占失败的 83.6%。Qwen 与 DeepSeek 占全部失败的 73.1%,前者主要是 HTML 交付问题,后者主要生成超时。67 ÷ (7 × 323) ≈ 2.96% 是本文对原图总失败率的重算。
4.2 思考、费用、耗时和工具次数分别看
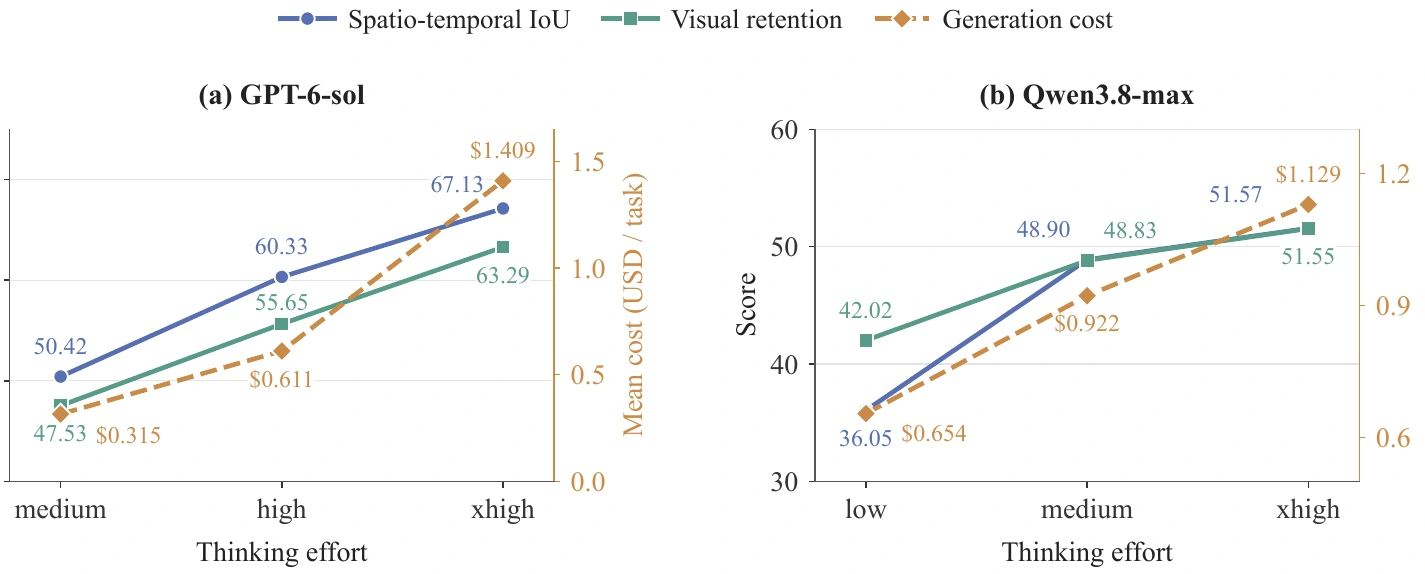
Pi 下 GPT-6-sol 从 medium 到 xhigh,对象 IoU 50.42 → 67.13,整体保留 47.53 → 63.29,每视频生成成本 $0.315 → $1.409。Qwen 从 low 到 medium 的收益较大,IoU 36.05 → 48.90、保留 42.02 → 48.83;再到 xhigh 只增加 2.67、2.72 点,成本 $0.922 → $1.129,而且时间上限放宽。思考强度是各模型的配置,不是通用的等 token 预算。来源:§4.3.1。
补充:完整成本效率和工具组成
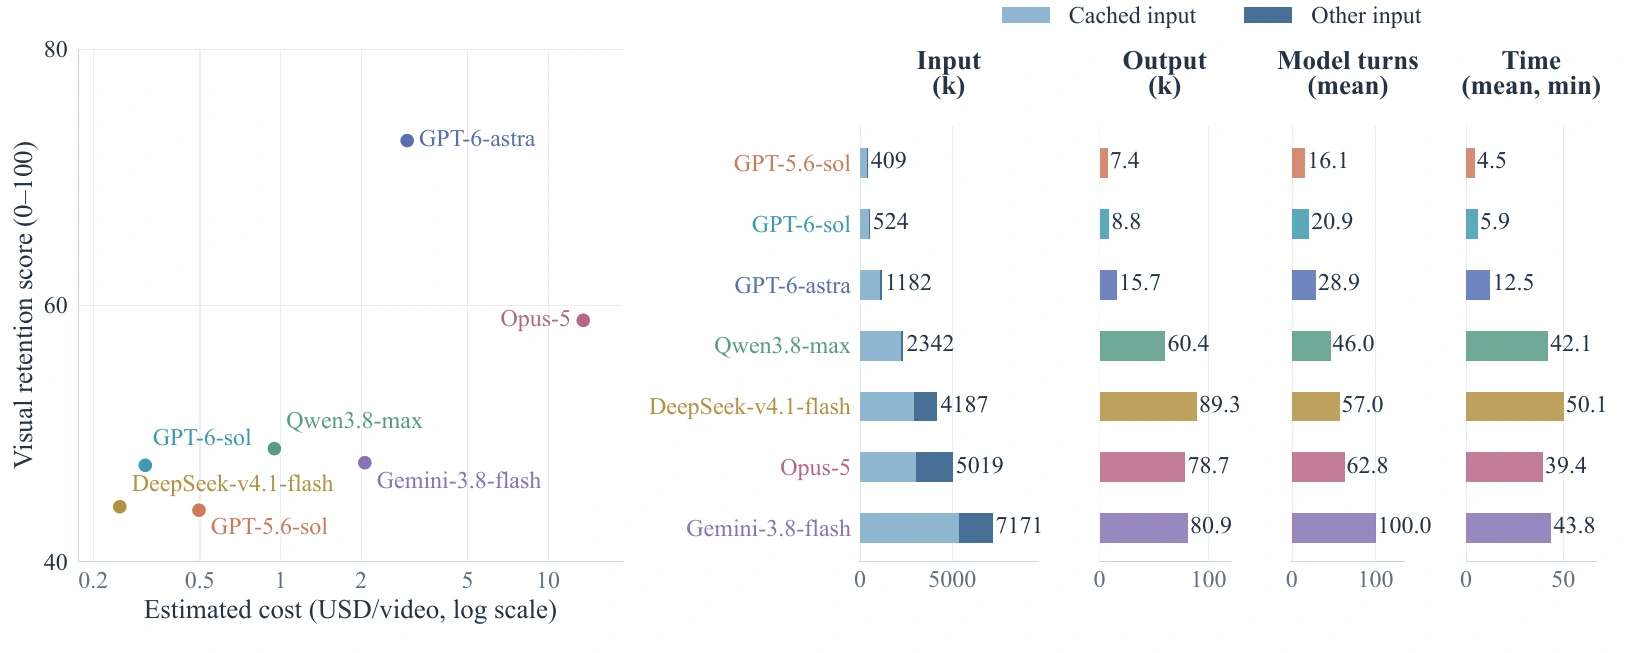
平均每视频 GPT-6-astra 耗时 12.5 分钟,Qwen 42.1 分钟,DeepSeek 50.1 分钟。Figure 6 的 model turns 是模型响应轮次,Figure 7 的 tool calls 是工具调用,不能交换单位。生成费用也未包含所有评测器成本。
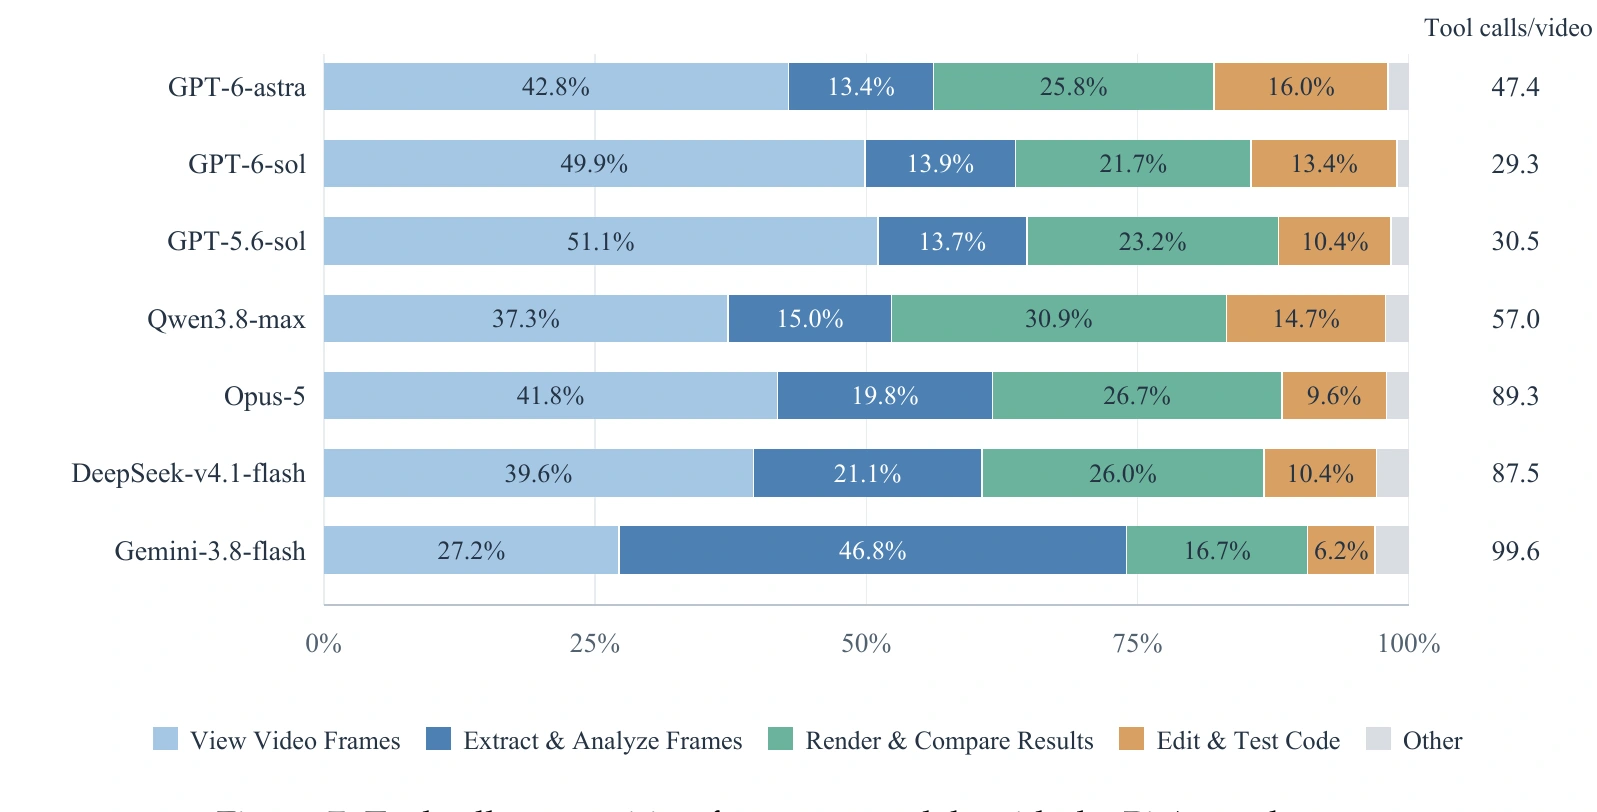
Astra 平均 47.4 次工具调用、保留 72.87;Gemini 99.6 次、保留 47.73。Qwen 的渲染与对比占 30.9%,Gemini 的抽帧分析占 46.8%。这些是行为统计,未隔离某类工具调用的因果价值。
4.3 下游问答:代码渲染视频比文字输入保留了更多可答信息
作者从 DVBench、VideoMathQA、GUI-World 随机取 100 个有问答标注的视频,由 GPT-5.6-sol、Opus-5、Qwen3.8-max 各生成代码与自然语言描述。Gemini-3.8-flash 用代码渲染视频或描述文本作答,对照原数据的真实答案;看原视频得 83.96%。这里 100 是视频数,精确问题总数与准确率聚合细节未交代。
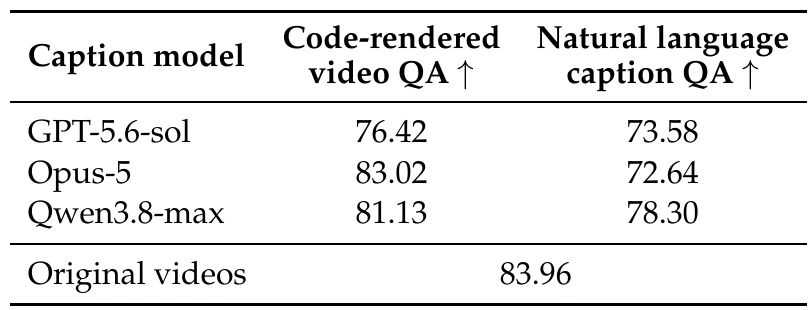
Opus 的代码视频 83.02% 对文字 72.64%,按表重算增加 10.38 个百分点。GPT 的表值相减是 2.84,正文写最小 2.83,可能来自显示舍入,本文以打印表值为准。这支持所测管线的效用;答题端看到的模态不同,不能解读成控制输入长度和预算后“代码文本普遍优于自然语言文本”。
4.4 重建:直接渲染和额外视频生成模型之间的比较
在 CodeCap-Bench 上,代码直接渲染;文字描述交给 Seedance-2.5 生成视频。作者将参考视频划为镜头,与成品对应片段匹配。Appearance Similarity(AS)查 DreamSim 外观特征,Motion Pattern Similarity(MPS)比较 CoTracker3 追踪点的位移方向和大小,Keyframe Structural Similarity(KSS)算参考镜头中点帧与匹配成品帧的 SSIM。分数先按视频内镜头平均,再对视频平均,这与主表对象和关键点的分母不同。
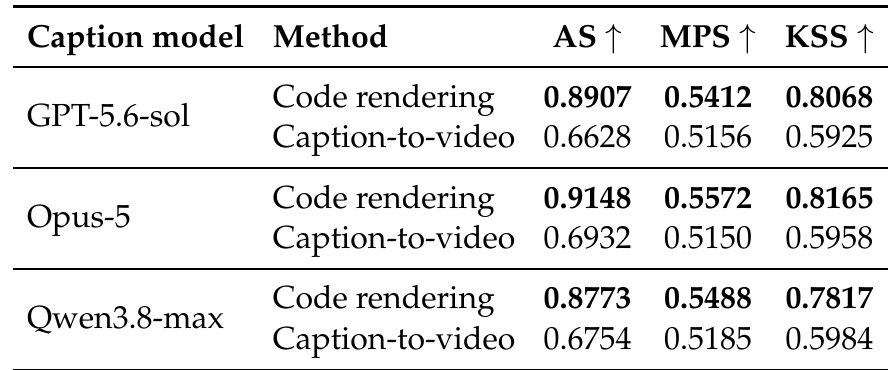
三模型每项都是代码管线较高。例如 Opus 的 AS 0.9148 对 0.6932,KSS 0.8165 对 0.5958,MPS 0.5572 对 0.5150,后者差值明显较小。对照同时改变了表示方式和重建系统;描述长度、生成费用和时间的匹配未披露。因此实验支持这些视频上代码直接渲染的优势,不能证明任何视频、任何同等成本条件下代码都优于文字描述。
5. Discussion:对视频理解与 coding Agent 研究的启发
我更关注它把“理解”落到了可检查的产物上。气泡图案例里,位置、半径、年份和指针都成为可操作的中间量;render-and-compare 能指出一次时间错位。对编码代理研究,可以把结构测量与渲染反馈分开做对照:固定观察帧、token 与耗时预算,分别禁用测量工具、禁用成品视觉反馈,报告对象分和动态保留,而不只报告页面能否打开。这是本文的实验建议,论文尚未进行这种消融。
与游戏研究相接时,还需区分视频重放和交互游戏。当前任务只需沿原时间线复现画面,无须证明相同动作在新初态下会产生正确碰撞或胜负。可进一步收集交互轨迹,将重建代码的对象与事件作为训练时额外信息,再对比强模型完整轨迹的直接蒸馏、只用最终代码、以及没有代码的基线。能否带来泛化收益仍是待验证假设,本论文没有给出 OPD/OPSD 或 RL 证据。
评测也应补上更短的事件检测与独立 judge:2 fps 观察可能遗漏短变化,视频级高相关不能替代逐事件核验;由模型找对象再分割,身份和可见时间的错误还可能传到 IoU。完整数据来源、标注过程与可执行评测器公开后,才能检查去污染、评分稳定性、无素材要求是否真正执行,以及失败判零的具体实现。
6. Conclusion:代码表示有潜力,忠实生成仍是瓶颈
CodeCap-Bench 提供了一个具体的观察链:原视频 → 程序 → 渲染视频 → 对象与关键内容评分。它在筛选过的结构化 2D 内容上证明了所测代码管线对问答和重建的帮助,同时暴露模型对时间过程、节奏和协同的短板。读榜单时,应把产出成功、整体相似度、对象对齐和关键内容保留分别看,并保留 Agent 质量不升反降的反例。
适用范围受内容筛选限制,下游对照也未控制所有模态、生成器和预算。官方数据与 checker 尚未提供可用链接;本文能核实完整论文、公开提示词和案例,不声称独立复现了模型榜单。
取证范围:arXiv:2610.37341v1 全 21 页,含 Appendix A 至 D;论文 HTML、arXiv 元数据与官方项目页(2026-10-28)。最早公开日期依据 arXiv citation_date 为 2026-10-27,未采用 PDF 页眉的 2026-10-28。所有原图和原表按 CC BY 4.0 复用,仅裁去页边与邻接正文;图解的 Figure 2、Figure 9 局部图明确标为细节裁切。本文的中点、IoU 和失败率算例为重算,不是官方运行日志。
留言