CodeCap-Bench: Can Code Serve as a Good Video Caption? · 323 段结构化 2D 视频
CodeCap-Bench · 核心问题01 / 15
一段视频,能不能用可执行代码描述?
§1、§3;Figure 1原文 ↗
CodeCap-Bench · 时间函数02 / 15
“向下滚动”变成每个时刻可计算的位置
scroll(t) = 383 × q² × (3 − 2q)
位移 0
位移 191.5
位移 383
座位状态另算
座位按四列和 41 单位行距绘制;第 5 行第 3 列在 28.35 至 30.85 秒为选中态。用同一个 t 协调状态,避免只画几张静态终态。
Figure 1,p.2;中点191.5为本文重算原文 ↗
CodeCap-Bench · 收集与筛选03 / 15
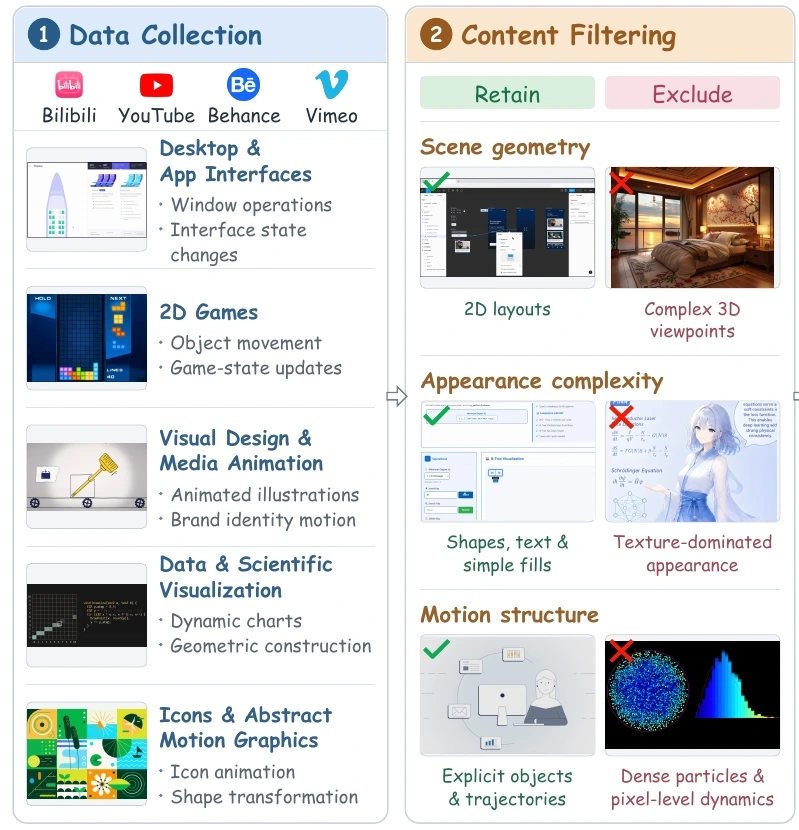
先筛适合程序表达的内容
Figure 2,p.4 左侧细节裁切 · Tang et al. · CC BY 4.0原文 ↗
CodeCap-Bench · 标注与复核04 / 15
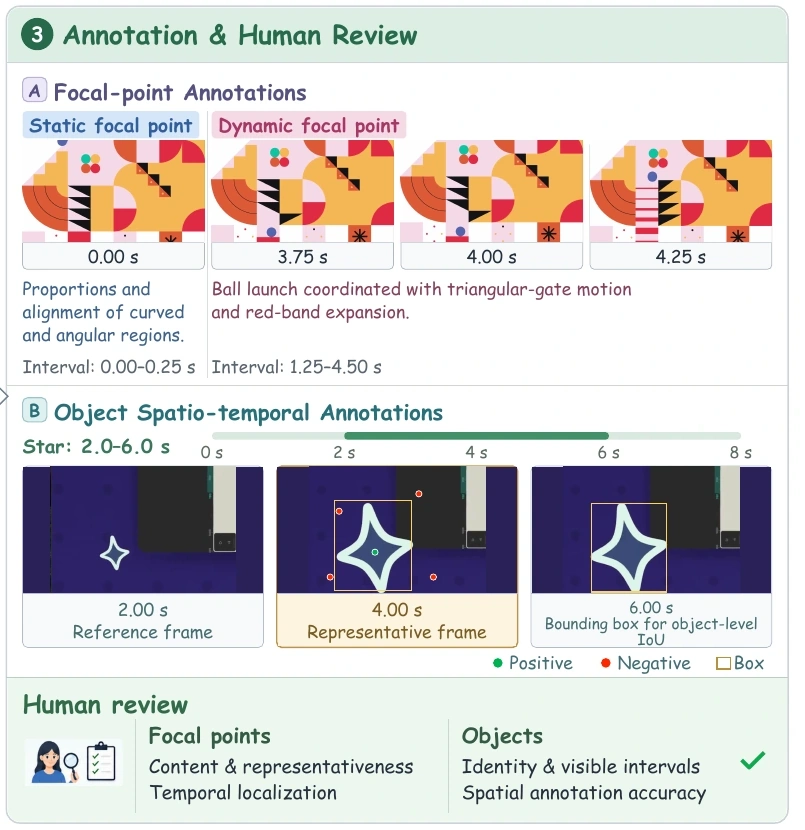
关键描述带时间范围,对象记录可见区间
Figure 2,p.4 右侧细节裁切 · Tang et al. · CC BY 4.0原文 ↗
CodeCap-Bench · 样本与标签05 / 15
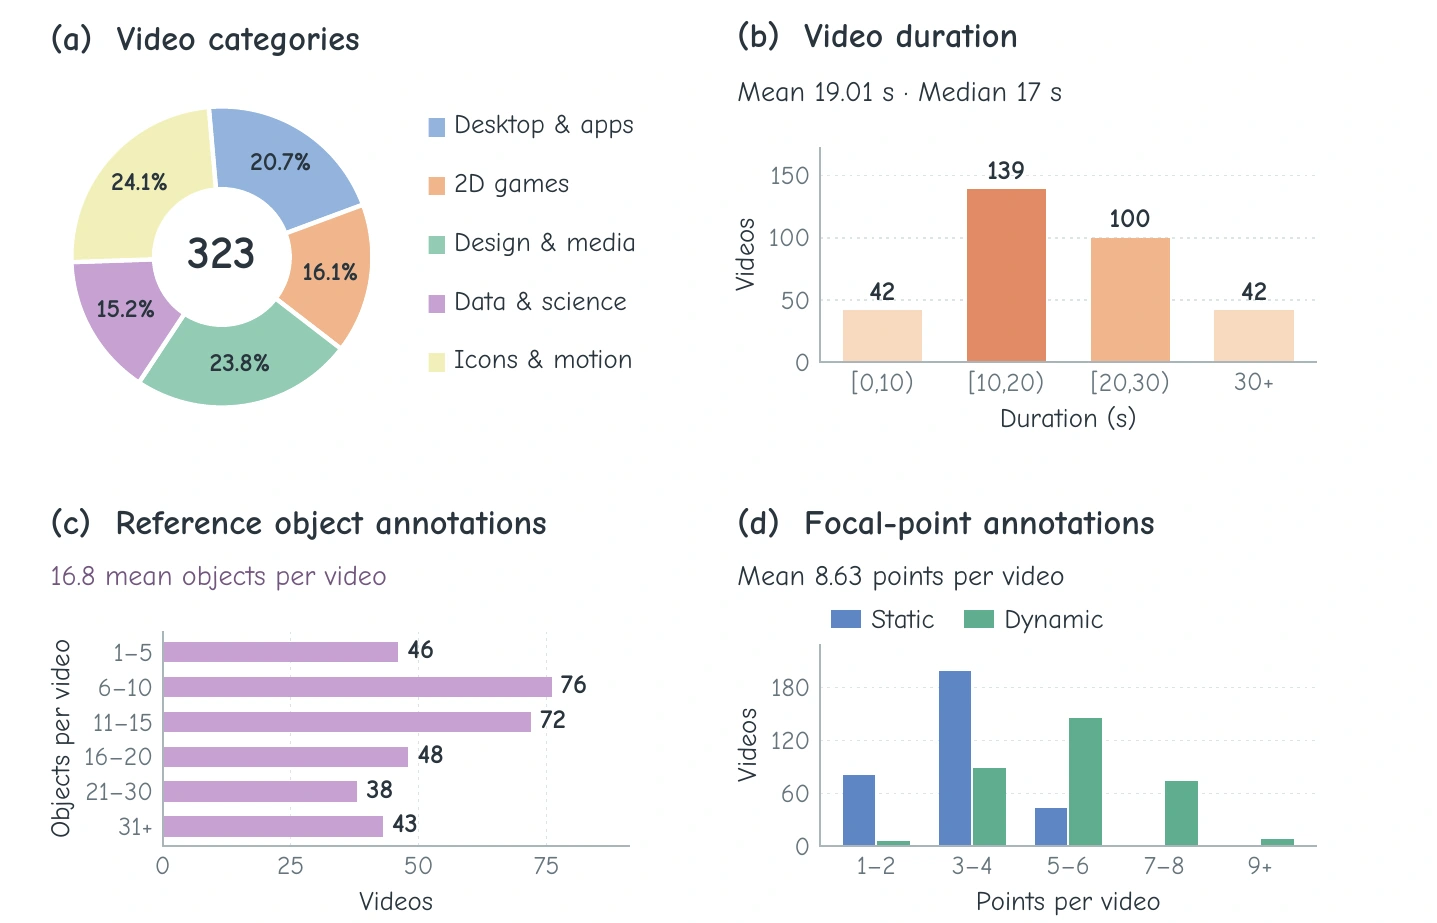
323 段,不代表所有类型的视频
Figure 3,p.5 · CC BY 4.0;原始池大小、标注者人数及一致性未披露原文 ↗
CodeCap-Bench · 输入和交付06 / 15
Agent 能看原视频,成品只能含程序
参考视频 → 自选时间抽帧 → 分析 → 写 index.html → 渲染对比 → 修改。
Pi / Codex / Claude Code 提供完整编码环境。
隔离环境只留 index.html;禁止把原视频、截图、外部图像或 Base64 嵌进成品。
人类标签用于评测,未列为 Agent 输入。
seek 暂停播放并按共享时间画出一帧,支持重复与乱序调用。外部渲染器每 1/24 秒调用、截图、编码为 24 fps 视频。
Appendix A、C.1,pp.16–17;公开提示词,执行实现未发布原文 ↗
CodeCap-Bench · 三种评分07 / 15
有视频只是成功交付,还要量内容是否忠实
§3.2、§4.1,pp.4、6原文 ↗
CodeCap-Bench · 具体算分08 / 15
只画出终态,动态关键点仍可得 0 分
对象对齐:并集可见帧
对象分 = (1 + 0.5 + 0) / 3 = 0.5
第 3 帧只在原视频可见,不能删出分母。对象完全缺失记 0。
动态评分:完整过程
成品:只展示倒塌后的结构
纯动态关键点得 0。
明显改变主节奏或同步关系,最多 2。
这是本文依据公开规则编写的算例,未运行官方评测器,也不是某模型的真实得分。保留分在表中用 0 至 100 尺度展示,不能把 Overall 当作 Static 与 Dynamic 的简单平均。
§3.2、Appendix C.3;算例为本文说明原文 ↗
CodeCap-Bench · 真实执行轨迹09 / 15
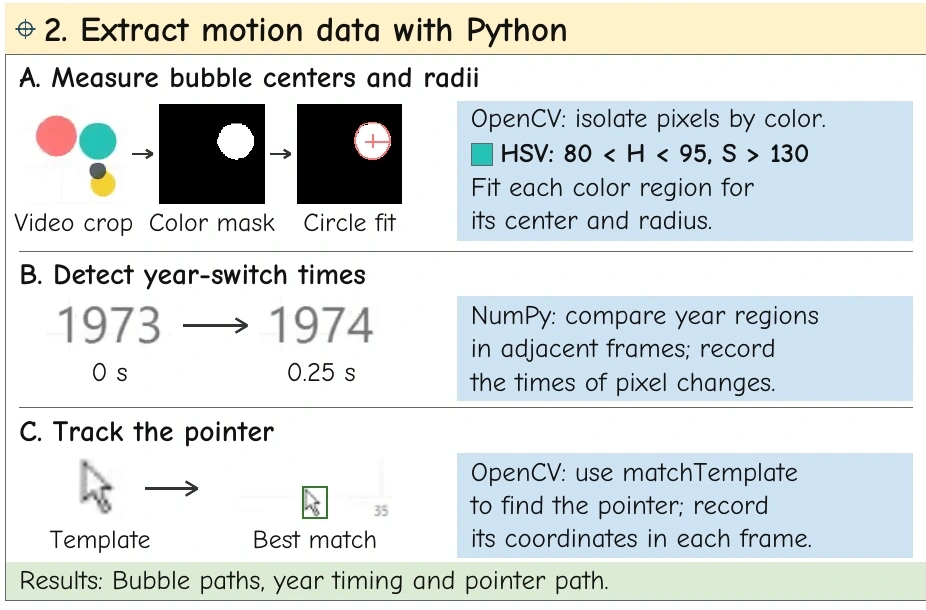
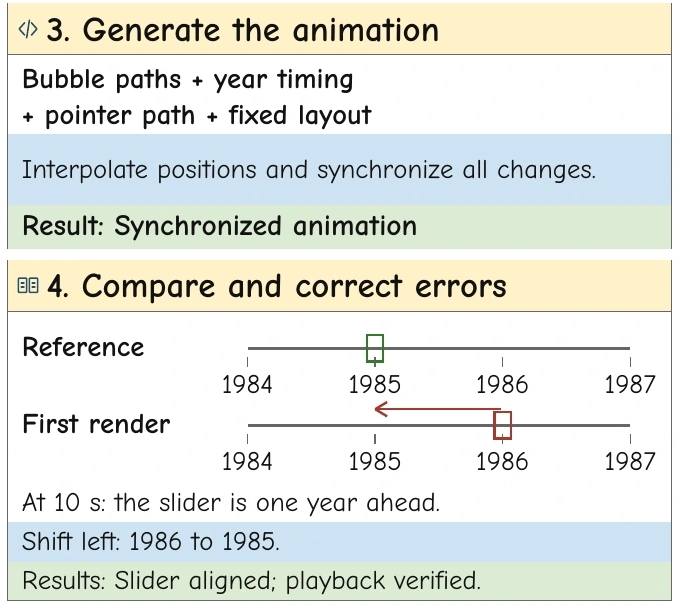
气泡、年份和指针:先测量,再同步动画
Figure 9,p.10 左下细节裁切 · CC BY 4.0;GPT-6-astra + Codex原文 ↗
CodeCap-Bench · 同刻比较修正10 / 15
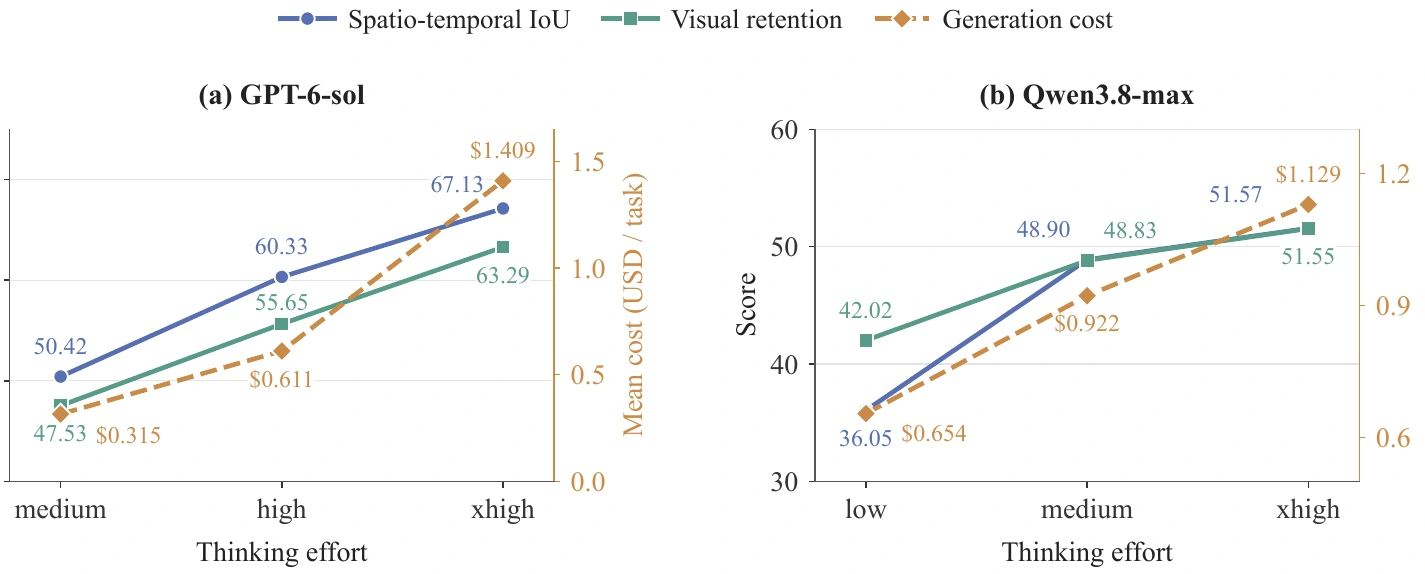
10 秒处:滑块快了一年
Figure 9,p.10 右下细节裁切 · CC BY 4.0;§4.3.5原文 ↗
CodeCap-Bench · 主结果11 / 15
100% 成功产出,也可能只保留一半内容
| medium 配置 | 产出成功率 % | 对象 IoU | Dynamic | Static | Overall |
|---|---|---|---|---|---|
| GPT-6-astra / Codex | 99.4 | 75.37 | 68.61 | 80.72 | 73.24 |
| Opus-5 / Pi | 97.8 | 61.45 | 55.49 | 65.10 | 58.84 |
| GPT-6-sol / Codex | 100.0 | 55.63 | 43.92 | 64.04 | 51.34 |
| Qwen3.8-max / Pi | 93.2 | 48.90 | 44.81 | 55.88 | 48.83 |
Table 1,p.6,节选;完整原表在正文原文 ↗
CodeCap-Bench · 推理成本12 / 15
增加思考有收益,成本和耗时需要同时看

GPT-6-sol / Pi:medium → xhigh,保留 47.53 → 63.29,每视频成本 $0.315 → $1.409。Qwen 的高强度增益较小,且 xhigh 超时上限放宽到 7200 秒。
Figure 5,p.8 · CC BY 4.0;Appendix A原文 ↗
CodeCap-Bench · 下游问答13 / 15
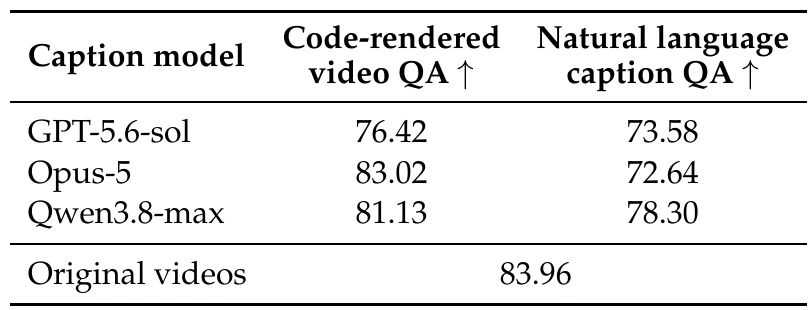
83.02% 对 72.64%:比较的是两条输入管线

Gemini-3.8-flash 看代码渲染视频或自然语言文本回答原标注问题。
100 是视频数,精确问题分母未报告。
Opus-5 的差值按原表重算为 10.38 个百分点。这不是把代码文本和描述文本交给同一个文本问答器的控制实验。
§4.3.6、Table 2,p.10 · CC BY 4.0原文 ↗
CodeCap-Bench · 重建与评测边界14 / 15
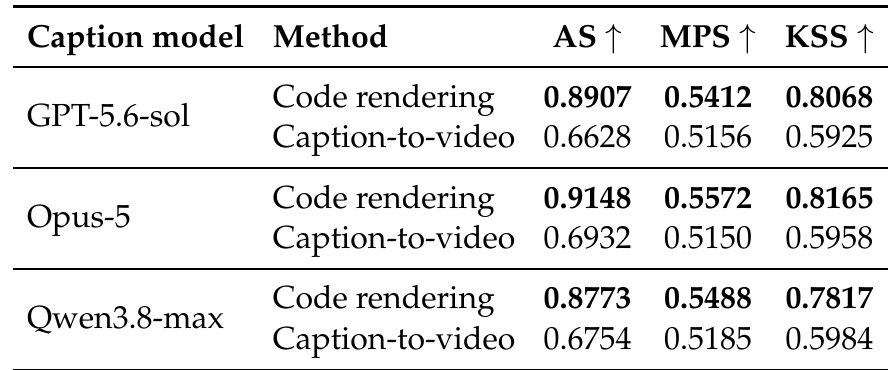
代码直接渲染,与描述经 Seedance 重建比较

MPS:CoTracker3 位移方向与大小
KSS:匹配镜头中帧的 SSIM
先镜头内,再视频间平均。三模型各项代码管线较高,但渲染方式与额外生成器不同,长度和成本匹配未披露。
人工校准:50 原视频、每类 10 段、四模型输出,视频级 Pearson r = 0.942。高相关不能证明每个短事件都判断正确。
§4.3.4、§4.3.6;Table 3,p.11 · CC BY 4.0原文 ↗
CodeCap-Bench · 结论15 / 15
能计算与重放的描述,有用也有明确边界
取证:v1 全21页,2026-10-27;项目链接检查2026-10-28原文 ↗