IdeaEval · 研究问题1 / 14
能预测引用,能判断研究方法吗?
IdeaEval 尝试在实验开始前,判断哪份研究提案更值得投入。
作者公开的失败复盘;原 75 对 human–AI 准确率 49.3%。后续公开 40 对为 67.5%,必须分别解读。
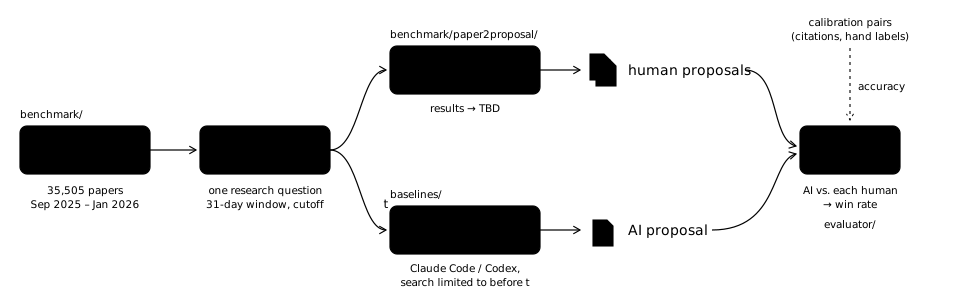
作者原文 TL;DR / Afterword;官方 overview.svg 原图,Apache 2.0作者原文 ↗
IdeaEval · 评测对象2 / 14
交付一份研究计划,不执行计划里的实验
人类提案来自已完成论文的改写;AI 提案由 agent 在历史时间边界内生成。
原文 Judging an idea / Rewinding papers;baselines/README作者原文 ↗
IdeaEval · 任务来源3 / 14
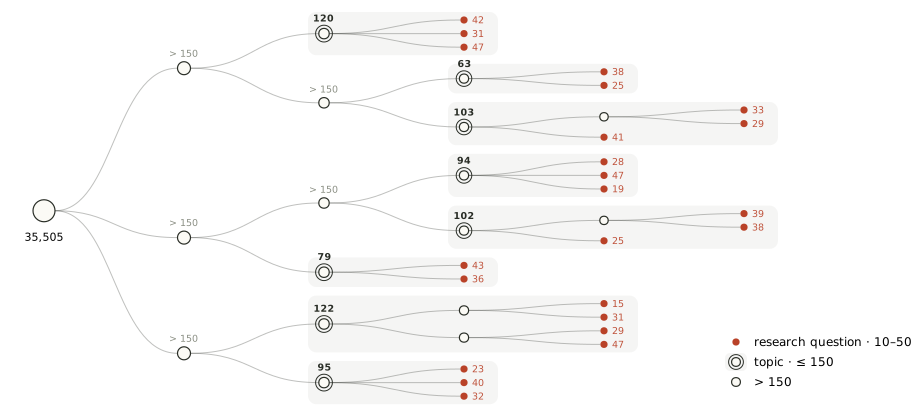
35,505 篇论文,组成 91 个同期研究组
一个 cohort 是同一主题、31 天内的一组论文;“相同知识背景”只是近似。
6 层、1,799 个叶子;人工选 70 个活跃主题,最终覆盖 40 个。公开版 1,330 篇独立论文,占 1,394 个组内席位。
原文 Carving the literature;PIPELINE §3–4;taxonomy.svg 原图,Apache 2.0作者原文 ↗
IdeaEval · 时间与改写4 / 14
去掉实验结果,保留方法和实验设计
cutoff 取组内最早论文公开前一天;检索边界与模型训练知识边界都要检查。
原文 Rewinding / Four-month citations;PIPELINE;paper2proposal作者原文 ↗
IdeaEval · 原评判流程5 / 14
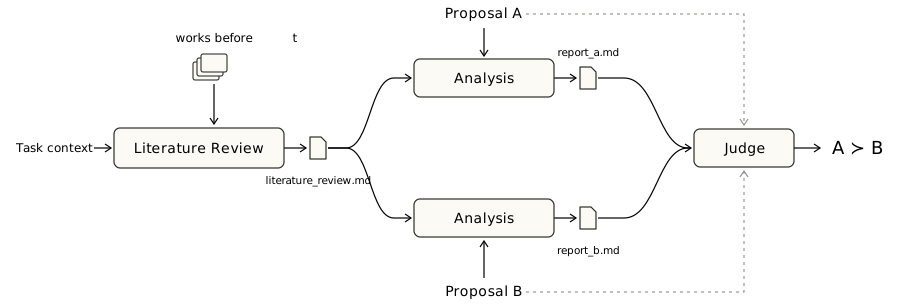
先共同调研,再分析两案,最后比较
原设计把领域知识、提案增量和最终判断交给不同的模型调用。
原文七因子 rubric 要求致命缺陷不能被影响力补偿。公开 v23 judge-only 跳过 Analysis,直接查本地文献;不能把两版当同一流程。
原文 Three-stage ranker;evaluator/README;ranker.svg 原图,Apache 2.0作者原文 ↗
IdeaEval · 公开 Judge6 / 14
v23 先问:写下的方法能支撑最强主张吗?
Judge 可以查本地提案、文献摘要并用 Bash 做小算例;不开放外部检索工具。
sys_judge_agent.md v23;rank_runner.py:799–900;pair_manifest.py:81–140作者原文 ↗
IdeaEval · 真实提案7 / 14
SGA:压缩敏感的 head 应获得更多缓存
公开 humanAI 案例:GLM-5.1 + Claude Code 写 SGA,与论文 LAVa 改写提案比较。
min Σ σ² (1 − n/N), Σn ≤ B, n ≥ n_min
提案声称:n = n_min + [σ² / Σσ²] (B − LH n_min)
σ 是压缩后的输出变化;n 是给每个注意力 head 保留的 token 数。目标采用线性衰减,却声称平滑比例分配是最优解。
人工标注:human_much_better,unsound / fatal。我们只验证公式错误;没有该 pair 的作者逐次 judge 日志。
HF humanAI pair …2509.09754;AI Methods Step 2;CC BY-NC 4.0 数据作者原文 ↗
IdeaEval · 算出反例8 / 14
换一个 token,就能得到更小的目标
一个合法替代解已经足以反驳最优性;不需要先跑完整压缩实验。
这是一段本文构造的数值验证,不是原评判器的运行输出,也不证明该启发式在所有实验上无用。
根据公开 SGA Methods Step 2 绘制;Python 数值验证保存在本文来源记录作者原文 ↗
IdeaEval · 历史消融9 / 14
只读标题已有约 73%;删核心内容仍约 80%
时间更均衡的250对;这些指标检验与引用排序一致,不直接检验方法正确。
原文 Removing literature review / Titles alone;两批数据不合并作者原文 ↗
IdeaEval · 历史失败10 / 14
原 75 对:49.3%,始终选人类则是 76%
人工认为AI胜18对、人类胜57对;原GPT-5.4对两类的准确率分别约83%与39%。
旧集致命缺陷15对,只检出8对。重排rubric、强制验证、换GPT-5.5都未超过旧49.3%。
原文 Human-AI / Nothing helped;旧37/75按分组数重建;新版来自results_160作者原文 ↗
IdeaEval · 博客反例11 / 14
CSA 的“反事实”来自不同观察历史
原博客嵌入了完整DeepSeek提案;作者报告它与同组13份人类提案比较全部胜出。
原提案承认不构成严格因果反事实,改称 associative counterfactuals。启发式能否有效仍须实验;13/13判决日志没有公开。
博客 The judge falls…;嵌入原稿 Methods / Where it is most likely to fail作者原文 ↗
IdeaEval · 后续公开数据12 / 14
160 对是四种评测,各 40 对
后续清洗套件与原 260/250/75 对重叠不完整;新版 v23 + Opus4.6、seed42。
IdeaEval-Calibration 卡片 / results_160.json;两列同为 Opus 4.6作者原文 ↗
IdeaEval · 工具收益13 / 14
文献检查帮助找到重复,但 humanAI 没提高
Set C 的先例是人为放入背景文献的;读文献恰好是解决它所必需的操作。
GPT-5.4 proposal-only 的 8 对无判决被排除:95/152=62.5%;按全部160作分母则59.375%。
HF results_160;本文重算;非纯文献消融:模型调用方式与工具同时改变作者原文 ↗
IdeaEval · 结论14 / 14
先证明评判器会发现问题,再让它排名
这次项目未给出可信的 ideation 排行榜;代码和数据更适合研究评判失败。
作者 Afterword;公开限制;本文研究建议,不是已完成实验作者原文 ↗